
OnlineJudge难度与正确度的相关性检验
本着做题的心态,上了东莞理工学院的 oj 网;在选择难度的时候发现有些题目通过率和难度可能存在着某些关系,于是决定爬下这些数据简单查看一下是否存在关系。
一、新建项目
我是用 Scrapy 框架爬取的(因为刚学没多久,顺便练练手)。首先,先新建 project (下载 Scarpy 部分已省略),在控制台输入 scrapy startproject onlineJudge(其中, onlineJudge为项目名称),敲击回车键新建项目完成。
二、明确目的
在动手写代码之前,先分析一下网页结构。网站是通过动态加载的,数据通过 json 文件加载。

1、明确要爬取的目标: http://oj.dgut.edu.cn/problems 网站里的题目,难度,提交量,通过率。在查找 json 的时候发现只有通过数,那么通过率就要自己计算。
2、打开 onlineJudge 目录下的 items.py 写下如下代码:
class OnlinejudgeItem(scrapy.Item):

    id = scrapy.Field()                     # 题目编号

    title = scrapy.Field()                  # 标题

    difficulty = scrapy.Field()             # 难度

    submissionNo = scrapy.Field()         # 提交量

    acceptedNo = scrapy.Field()           # 正确数

    passingRate = scrapy.Field()           # 正确率
三、制作爬虫
1、在当前目录下输入命令:scrapy genspider oj "oj.dgut.edu.cn" (其中 oj 是爬虫的名字,"oj.dgut.edu.cn"算是一个约束,规定一个域名)
2、打开 onlineJudge/spiders 下的 ojSpider.py ,增加或修改代码为:
import scrapy

import json

from onlineJudge.items import OnlinejudgeItem

class OjSpider(scrapy.Spider):

    name = 'oj'        # 爬虫的名字

    allowed_domains = ['oj.dgut.edu.cn']     # 域名范围

    offset = 0

    url = 'http://oj.dgut.edu.cn/api/xproblem/?limit=20&offset='

    start_urls = [url + str(offset)]       # 爬取的URL元祖/列表

    def parse(self, response):

        data = json.loads(response.text)['data']['results']

        if len(data):

            for i in range(len(data)):

                submissionNo = data[i]['submission_number']

                acceptedNo = data[i]['accepted_number']

                try:

                    passingRate = round((int(acceptedNo)/int(submissionNo)) * 100, 2)

                except ZeroDivisionError as e:

                    passingRate = 0

                strPR = str(passingRate) + "%"

                item = OnlinejudgeItem()

                item['id'] = data[i]['_id']

                item['title'] = data[i]['title']

                item['difficulty'] = data[i]['difficulty']

                item['submissionNo'] = submissionNo

                item['acceptedNo'] = acceptedNo

                item['passingRate'] = strPR

                yield item

                print(i)

            self.offset += 20

            yield scrapy.Request(self.url + str(self.offset), callback=self.parse)
四、存储数据
1、打算将数据存储为 excel 文档,要先安装 openpyxl 模块,通过 pip install openpyxl 下载。
2、下载完成后,在 pipelines.py 中写入如下代码
from openpyxl import Workbook

class OnlinejudgePipeline(object):

    def __init__(self):

        self.wb = Workbook()

        self.ws = self.wb.active                # 激活工作簿

        self.ws.append(['编号', '标题', '难度', '提交量', '正确数', '正确率'])    # 设置表头

    def process_item(self, item, spider):

        line = [item['id'], item['title'], item['difficulty'],

                item['submissionNo'], item['acceptedNo'], item['passingRate']]

        self.ws.append(line)

        self.wb.save('oj.xlsx')

        return item
五、设置 settings.py
修改并增加代码:
LOG_FILE = "oj.log"

ROBOTSTXT_OBEY = True

ITEM_PIPELINES = {

    'onlineJudge.pipelines.OnlinejudgePipeline': 300,

}
六、运行爬虫
在当前目录下新建一个 main.py 并写下如下代码
from scrapy import cmdline

cmdline.execute("scrapy crawl oj".split())
然后运行 main.py 文件。
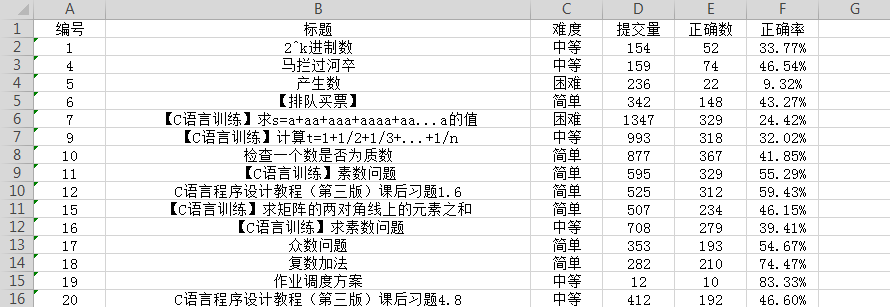
于是,想要的数据就被爬下来了
七、分析数据
分析数据之前,先安装好 numpy,pandas,matplotlib,xlrd。
import pandas as pd

import xlrd

data = pd.read_excel("../onlineJudge/onlineJudge/oj.xlsx")  # 导入 excel 文件

data.describe()
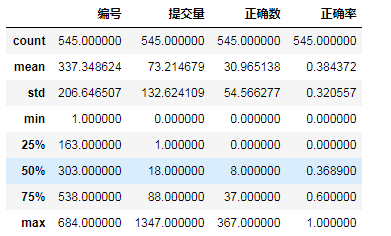
通过观察,数据没有异常值以及确实值,虽然提交量和正确数有为0的部分,但属于正常范围,不做处理。
data = data.set_index('编号')  # 设置编号为索引
data.head()            # 显示前五条信息

from matplotlib import pyplot as plt

import matplotlib.style as psl

%matplotlib inline

psl.use('seaborn-colorblind')    # 设置图表风格

plt.rcParams['font.sans-serif']=['SimHei'] #用来正常显示中文标签
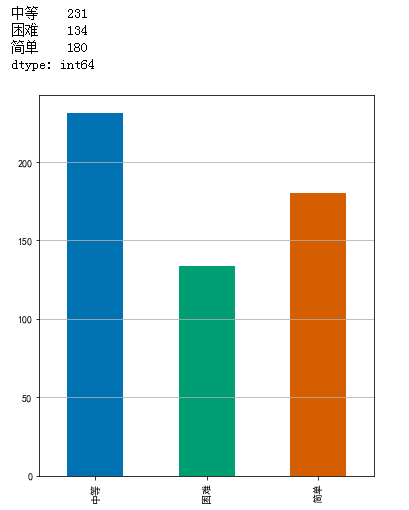
查看题目各难度的数目:
level_values = data['难度'].values

difficulties = {

    '简单': 0,

    '中等': 0,

    '困难': 0

}

for value in level_values:

    if value == '简单':

        difficulties['简单'] += 1

    elif value == '中等':

        difficulties['中等'] += 1

    else:

        difficulties['困难'] += 1

level = pd.Series(difficulties)

print(level)

level.plot(kind = 'bar', figsize=(6, 7))

plt.grid(axis='y')
验证正确率与难度之间是否存在关系:
import numpy as np

relation = data[['难度', '正确率']]

rate_values = relation['正确率'].values

fig, axes = plt.subplots(figsize=(15, 6))

axes.scatter(rate_values, level_values)

plt.grid(axis='x')

plt.xticks(np.arange(0, 1, 0.05))

plt.xlabel('正确率')

plt.ylabel('难度')
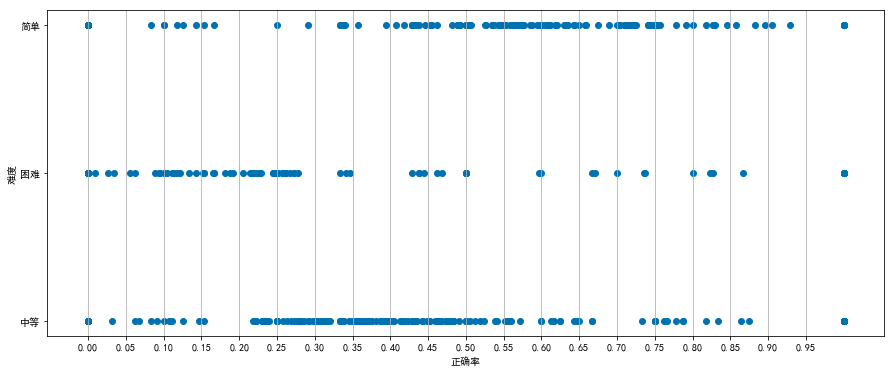
根据图像显示,题目难度跟正确率存在一定关系,困难的题目正确率相对集中于8%-28%,中等难度的题目比较集中在23%-55%,简单难度的题目正确率主要在40%以上。
OnlineJudge难度与正确度的相关性检验的更多相关文章
- python相关性分析与p值检验
## 最近两天的成果 ''' ########################################## # # # 不忘初心 砥砺前行. # # 418__yj # ########### ...
- 使用K-S检验一个数列是否服从正态分布、两个数列是否服从相同的分布
假设检验的基本思想: 若对总体的某个假设是真实的,那么不利于或者不能支持这一假设的事件A在一次试验中是几乎不可能发生的.如果事件A真的发生了,则有理由怀疑这一假设的真实性,从而拒绝该假设. 实质分析: ...
- 【应用】R--判断类别型属性之间是否有相关性(相互之间是否独立)
检验某学区所有在售房源中,小区与楼栋类别(低层:多层;小高层:高层)是否相关 导入数据: > house<- read.table("house_data.txt", ...
- Mahout的taste里的几种相似度计算方法
欧几里德相似度(Euclidean Distance) 最初用于计算欧几里德空间中两个点的距离,以两个用户x和y为例子,看成是n维空间的两个向量x和y, xi表示用户x对itemi的喜好值,yi表示 ...
- 2017高教杯数学建模B 题分析
B题原文 "拍照赚钱"是移动互联网下的一种自助式服务模式.用户下载APP,注册成为APP的会员,然后从APP上领取需要拍照的任务(比如上超市去检查某种商品的上架情况),赚取APP对 ...
- 11大Java开源中文分词器的使用方法和分词效果对比,当前几个主要的Lucene中文分词器的比较
本文的目标有两个: 1.学会使用11大Java开源中文分词器 2.对比分析11大Java开源中文分词器的分词效果 本文给出了11大Java开源中文分词的使用方法以及分词结果对比代码,至于效果哪个好,那 ...
- 简单介绍一下R中的几种统计分布及常用模型
统计学上分布有很多,在R中基本都有描述.因能力有限,我们就挑选几个常用的.比较重要的简单介绍一下每种分布的定义,公式,以及在R中的展示. 统计分布每一种分布有四个函数:d――density(密度函数) ...
- 干货:结合Scikit-learn介绍几种常用的特征选择方法
原文 http://dataunion.org/14072.html 主题 特征选择 scikit-learn 作者: Edwin Jarvis 特征选择(排序)对于数据科学家.机器学习从业者来说非 ...
- 结合Scikit-learn介绍几种常用的特征选择方法
特征选择(排序)对于数据科学家.机器学习从业者来说非常重要.好的特征选择能够提升模型的性能,更能帮助我们理解数据的特点.底层结构,这对进一步改善模型.算法都有着重要作用. 特征选择主要有两个功能: 减 ...
随机推荐
- HCNA之网络通信基础
一.通信与网络 通信的概念我们并不陌生,在人类社会的起源和发展过程中,通信就直伴随着我们.般认为, 20世纪七.八十年代,人类社会已进入到信息时代,对于生活在信息时代的我们,通信的必要性和重要性更是不 ...
- 代码图片转文本--阿里VS度娘
最近看vue的书,居然没有提供源代码,一堆的CSS真不想手工录入,于是用手机找APP去转.发现广告普遍,于是找找网上相关的API,结果百度和阿里都有在线的API提供,于是好奇其能力如何.如于用以下两图 ...
- sphinx-doc的中文搜索
第一,你的系统需要安装jieba类库, pip install jieba 第二,接下来修改sphinx的conf.py文件,为项目设置为中文的搜索配置. # Language to be used ...
- Openvswitch手册(9): Flow
这一节我们将flow table flow table主要由ovs-ofctl命令操作 ovs-ofctl可以走和openflow controller一样的协议: ssl:ip[:port]: Th ...
- SQL Server AlwaysOn搭建
标签:SQL SERVER/MSSQL SERVER/数据库/DBA/高性能解决方案 概述 环境: 域服务器:windows server 2008 R2 SP1,192.168.2.10 DNS:1 ...
- 传统asp.net小心 async/await坑
最近在改老项目时,干了一件自以为很有成就感的事,心想 “项目都是同步方法,为啥不用异步方法呢?”,于是有了异步方法,类型下面的代码(当然是举例子说明啊) //更新某人名下公司名称 public Tas ...
- 1分钟快速制作漂亮的H5本地记事本
大家好,以前给大家分享过一个五步骤制作精美的HTML5时钟的文章,点击回顾<五步教你制作漂亮精致的HTML时钟>,还有<一分钟教你如何实现唯美的文字描边>:今天给大家分享一个用 ...
- C/C++中宏定义#pragma once与 #ifndef的区别
为了避免同一个文件被include多次,我们可以通过以下两种方式来进行宏定义: 1. #ifndef方式2. #pragma once方式 在能够支持这两种方式的编译器上,二者并没有太大的区别,但是两 ...
- 微博第三方登录使用social_django实现显示登陆的用户名
首先修改social_soce源码,将用户信息添加进cookie 将其修改为: response = backend.strategy.redirect(url) payload = jwt ...
- Nginx 在 Linux 上的安装和配置
一.Nginx的安装 1.单台Nginx的安装 Nginx在Linux上的安装可以参考这篇博客:http://blog.csdn.net/molingduzun123/article/details/ ...