
MapReduce规约
深入了解Combiners编程(相当于Map端的Reduce)
- 每一个map可能会产生大量的输出,combiner的作用就是在map端对输出先做一次合并,以减少传输到reducer的数据量。
- combiner最基本是实现本地key的归并,combiner具有类似本地的reduce功能。
- 如果不用combiner,那么,所有的结果都是reduce完成,效率会相对低下。使用combiner,先完成的map会在本地聚合,提升速度。
- 注意:Combiner的输出是Reducer的输入,Combiner绝不能改变最终的计算结果。
- 所以,Combiner只应该用于那种Reduce的输入key/value与输出key/value类型完全一致,且不影响最终结果的场景。比如累加,最大值等。
在程序中仅需要在主函数中添加如下代码:
//规约的例子,足以

job.setCombinerClass(MyReducer.class);
其中:MyReducer为自定的Reducer任务。
以单词技术为例:
(1)在没有Combine情况下
输入2个键值对<0,hello you><10,hello me>
map端产生4个键值对<k2,v2>,<hello,1><you,1><hello,1><me,1>
3个分组,<hello,{1,1}><me,{1}><you,{1}>
传输到reduce有3个键值对<hello,{2}><me,{1}><you,{1}>,3个分组
-----------------
hello you
hello me
-----------------
(2)有Combine的情况
输入2个键值对<0,hello you><10,hello me>
map端产生4个键值对<k2,v2>,<hello,1><you,1><hello,1><me,1>
Combine输入键值对有4个 <hello,1><you,1><hello,1><me,1>
Combine输出键值对有三个<hello,{1,1}><me,{1}><you,{1}>
3个分组,<hello,{1,1}><me,{1}><you,{1}>
传输到reduce有3个键值对<hello,{2}><me,{1}><you,{1}>,3个分组
测试代码:
package Mapreduce;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;

/**

 * 规约:Combiner

 *

 */

public class CombinerTest {

    public static void main(String[] args) throws Exception {

        //必须要传递的是自定的mapper和reducer的类,输入输出的路径必须指定,输出的类型<k3,v3>必须指定

        //2将自定义的MyMapper和MyReducer组装在一起

        Configuration conf=new Configuration();

        String jobName=CombinerTest.class.getSimpleName();

        //1首先寫job,知道需要conf和jobname在去創建即可

        Job job = Job.getInstance(conf, jobName);

        //*13最后,如果要打包运行改程序,则需要调用如下行

        job.setJarByClass(CombinerTest.class);

        //3读取HDFS內容:FileInputFormat在mapreduce.lib包下

        FileInputFormat.setInputPaths(job, new Path("hdfs://neusoft-master:9000/data/hellodemo"));

        //4指定解析<k1,v1>的类(谁来解析键值对)

        //*指定解析的类可以省略不写,因为设置解析类默认的就是TextInputFormat.class

        job.setInputFormatClass(TextInputFormat.class);

        //5指定自定义mapper类

        job.setMapperClass(MyMapper.class);

        //6指定map输出的key2的类型和value2的类型  <k2,v2>

        //*下面两步可以省略,当<k3,v3>和<k2,v2>类型一致的时候,<k2,v2>类型可以不指定

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(LongWritable.class);

        //7分区(默认1个),排序,分组,规约 采用 默认

        //规约的例子

        job.setCombinerClass(MyReducer.class);

        //接下来采用reduce步骤

        //8指定自定义的reduce类

        job.setReducerClass(MyReducer.class);

        //9指定输出的<k3,v3>类型

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(LongWritable.class);

        //10指定输出<K3,V3>的类

        //*下面这一步可以省

        job.setOutputFormatClass(TextOutputFormat.class);

        //11指定输出路径

        FileOutputFormat.setOutputPath(job, new Path("hdfs://neusoft-master:9000/out1"));

        //12写的mapreduce程序要交给resource manager运行

        job.waitForCompletion(true);

    }

    private static class MyMapper extends Mapper<LongWritable, Text, Text,LongWritable>{

        Text k2 = new Text();

        LongWritable v2 = new LongWritable();

        @Override

        protected void map(LongWritable key, Text value,//三个参数

                Mapper<LongWritable, Text, Text, LongWritable>.Context context)

                throws IOException, InterruptedException {

            String line = value.toString();

            String[] splited = line.split("\t");//因为split方法属于string字符的方法,首先应该转化为string类型在使用

            for (String word : splited) {

                //word表示每一行中每个单词

                //对K2和V2赋值

                k2.set(word);

                v2.set(1L);

                context.write(k2, v2);

            }

        }

    }

    private static class MyReducer extends Reducer<Text, LongWritable, Text, LongWritable> {

        LongWritable v3 = new LongWritable();

        @Override //k2表示单词,v2s表示不同单词出现的次数,需要对v2s进行迭代

        protected void reduce(Text k2, Iterable<LongWritable> v2s,  //三个参数

                Reducer<Text, LongWritable, Text, LongWritable>.Context context)

                throws IOException, InterruptedException {

            long sum =0;

            for (LongWritable v2 : v2s) {

                //LongWritable本身是hadoop类型,sum是java类型

                //首先将LongWritable转化为字符串,利用get方法

                sum+=v2.get();

            }

            v3.set(sum);

            //将k2,v3写出去

            context.write(k2, v3);

        }

    }

}
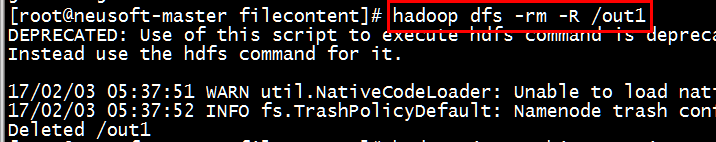
Combine测试代码
[root@neusoft-master filecontent]# hadoop dfs -rm -R /out1
[root@neusoft-master filecontent]# hadoop jar CombineTest.jar

Map-Reduce Framework
Map input records=2
Map output records=4
Map output bytes=51
Map output materialized bytes=49
Input split bytes=106
Combine input records=4
Combine output records=3
Reduce input groups=3
Reduce shuffle bytes=49
Reduce input records=3
Reduce output records=3
Spilled Records=6
Shuffled Maps =1
Failed Shuffles=0
Merged Map outputs=1
GC time elapsed (ms)=53
CPU time spent (ms)=1760
Physical memory (bytes) snapshot=455901184
Virtual memory (bytes) snapshot=3118538752
使用Combiner有什么好处?
在map端执行reduce操作,可以减少map最终的数据量,减少传输到reduce的数据量,减少网络带宽。
为什么Combiner不是默认配置?
因为有的算法不适合Combiner
什么算法不适合Combiner?
不符合幂等性的算法,比如在网络传输时候出现故障,多次执行程序结果是不同的
如:求平均值的算法。
2 2 2 这三个数在一个文件中
1 1 1 1 这四个数在一个文件中
两个文件产生2个inputsplit,每一个inputsplit对应一个mao任务,产生2个mapper任务,如果求平均数,真实值(2+2+2+1+1+1+1)/7=1.4
如果使用Combiner,map端要做一次Reduce,第一个文件平均数为2,第二个文件的平均数为1,之后再reduce再求平均值得到1.5,值不正确。
为什么在map端执行了reduce操作,还需要在reduce端再次执行哪?
答:因为map端执行的是局部reduce操作,在reduce端执行全局reduce操作。(上述例子中,map端仅仅指定的是单个文件的合并,reduce端执行的是两个文件的合并)
MapReduce规约的更多相关文章
- 第2节 mapreduce深入学习:7、MapReduce的规约过程combiner
第2节 mapreduce深入学习:7.MapReduce的规约过程combiner 每一个 map 都可能会产生大量的本地输出,Combiner 的作用就是对 map 端的输出先做一次合并,以减少在 ...
- Mapreduce之排序&规约&实战案例
MapReduce 排序和序列化 简单介绍 ①序列化 (Serialization) 是指把结构化对象转化为字节流②反序列化 (Deserialization) 是序列化的逆过程. 把字节流转为结构化 ...
- MapReduce中Combiner规约的作用以及不能作为MR标配的原因
作用:在Mapper端对数据进行Combine归约处理,Combine业务逻辑与Reducer端做的完全相同.处理后的数据再传送到Reducer端,再做一次归约.这样的好处是减少了网络传输的数量.在M ...
- [MapReduce] Google三驾马车:GFS、MapReduce和Bigtable
声明:此文转载自博客开发团队的博客,尊重原创工作.该文适合学分布式系统之前,作为背景介绍来读. 谈到分布式系统,就不得不提Google的三驾马车:Google FS[1],MapReduce[2],B ...
- Hadoop日记Day17---计数器、map规约、分区学习
一.Hadoop计数器 1.1 什么是Hadoop计数器 Haoop是处理大数据的,不适合处理小数据,有些大数据问题是小数据程序是处理不了的,他是一个高延迟的任务,有时处理一个大数据需要花费好几个小时 ...
- 用Map-Reduce的思维处理数据
在很多人的眼里,Map-Reduce等于Hadoop,没有Hadoop谈Map-Reduce犹如自上谈兵,实则不然,Map-Reduce是一种计算模型,只是非常适合在并行的环境下运行,Hadoop是M ...
- MapReduce介绍
一.MapReduce模型 1.MapReduce是大规模数据(TB级)计算的利器,Map和Reduce是它的主要思想,来源于函数式编程语言. 2.Map负责将数据打散,Reduce负责对数据进行聚集 ...
- MapReduce Shuffle原理 与 Spark Shuffle原理
MapReduce的Shuffle过程介绍 Shuffle的本义是洗牌.混洗,把一组有一定规则的数据尽量转换成一组无规则的数据,越随机越好.MapReduce中的Shuffle更像是洗牌的逆过程,把一 ...
- Hadoop 1.0 和 2.0 中的数据处理框架 - MapReduce
1. MapReduce - 映射.化简编程模型 1.1 MapReduce 的概念 1.1.1 map 和 reduce 1.1.2 shufftle 和 排序 MapReduce 保证每个 red ...
随机推荐
- C语言realloc,malloc,calloc的区别【转载】
转载自:http://www.cnblogs.com/BlueTzar/articles/1136549.html 三个函数的申明分别是: void* realloc(void* ptr, unsig ...
- AngularJS------命令行
如下:(‘$’符号不需要输入哦) $ ng build --发布项目
- virtio-netdev 数据包的发送
在前面几文中已经大体介绍了virtio的重要组成,包含virtio net设备的创建,vring的创建,与virtio设备的交互方式,我们就从网络数据包的发送角度来看下virtio的详细使用流程. [ ...
- 10 -- 深入使用Spring -- 5... 实现任务的自动调度
10.5 实现任务的自动调度 10.5.1 使用Quartz 10.5.2 在Spring中使用Quartz
- Git Step by Step – (5) Git分支(branch)
在前面两盘文章中介绍了Git的基本原理,都是理论知识.这篇文章我们再次回到实践中,看看Git分支(branch)的使用. 在代码版本控制工具中,都会有branch的概念.刚开始建立版本仓库的时候,我们 ...
- ios开发之--仿购物类详情页面数量添加小功能
话不多说先上图:
- Python中的yield和Generators(生成器)
本文目的 解释yield关键字到底是什么,为什么它是有用的,以及如何来使用它. 协程与子例程 我们调用一个普通的Python函数时,一般是从函数的第一行代码开始执行,结束于return语句.异常或者函 ...
- mysql的wait_timeout配置(此处处理方法是有问题的,不建议作为操作参考)
mysql数据库有一个wait_timeout的配置,默认值为28800(即8小时). 在默认配置不改变的情况下,如果连续8小时内都没有访问数据库的操作,再次访问mysql数据库的时候,mysql数据 ...
- SpringBoot(十一)-- 动态数据源
SpringBoot中使用动态数据源可以实现分布式中的分库技术,比如查询用户 就在用户库中查询,查询订单 就在订单库中查询. 一.配置文件application.properties # 默认数据源 ...
- 客户端远程连接linux下mysql数据库授权
mysql默认状态是只支持localhost连接,这样远程服务器都输入IP地址去连接你的服务器是不可以的,下面我来介绍怎么让mysql允许远程连接配置方法,有需要的朋友可参考. 方法一,直接利用p ...