
scrapy的使用--Rcrapy-Redis
Scrapy-Redis分布式爬虫组件
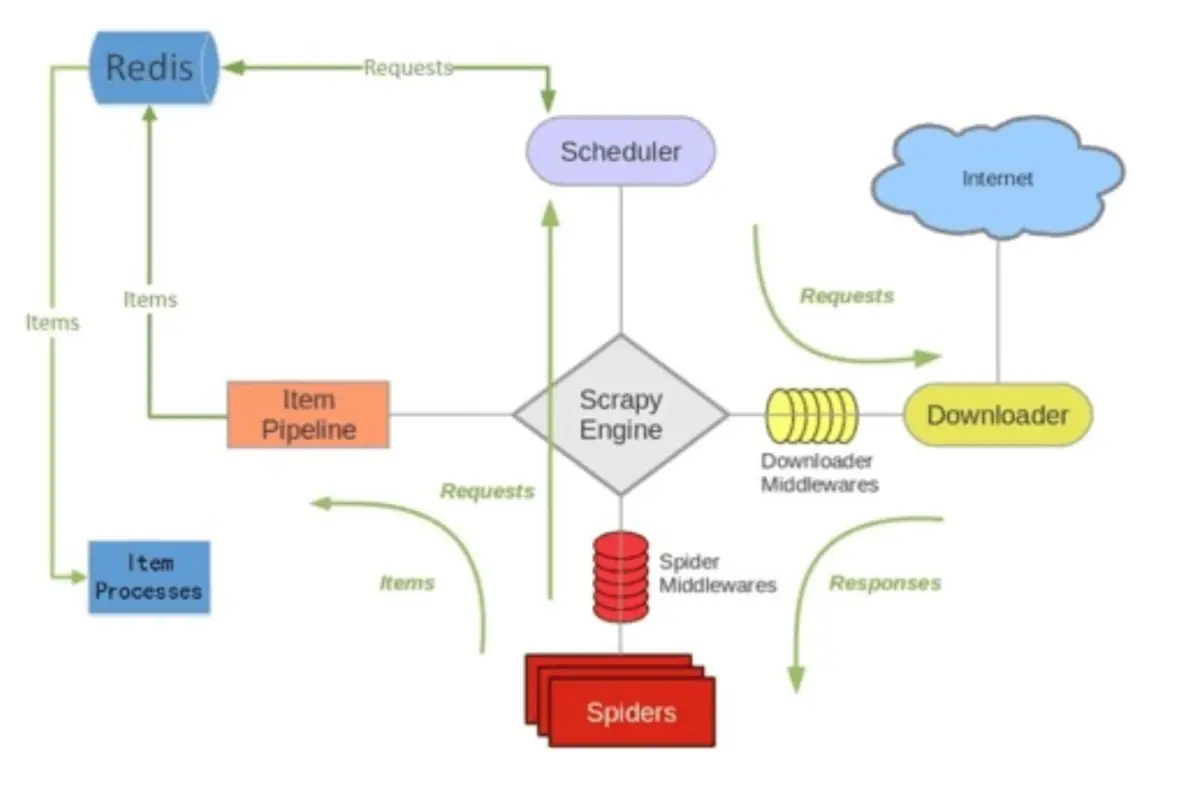
Scrapy是一个框架,他本身是不支持分布式的。如果我们想要做分布式的爬虫。就需要借助一个组件叫做Scrapy-Redis。这个组件正式利用了Redis可以分布式的功能,继承到Scrapy框架中,使得爬虫可以进行分布式,可以充分的利用资源(多个ip,更多带宽,同步爬取)来提高爬虫的爬取效率。
-分布式爬虫组件的优点:
1.可以充分利用多台机器的带宽
2.可以充分利用多台机器的ip地址
3.多台机器工作,io频率提高,爬取效率更高
-分布式爬虫需要解决的问题:
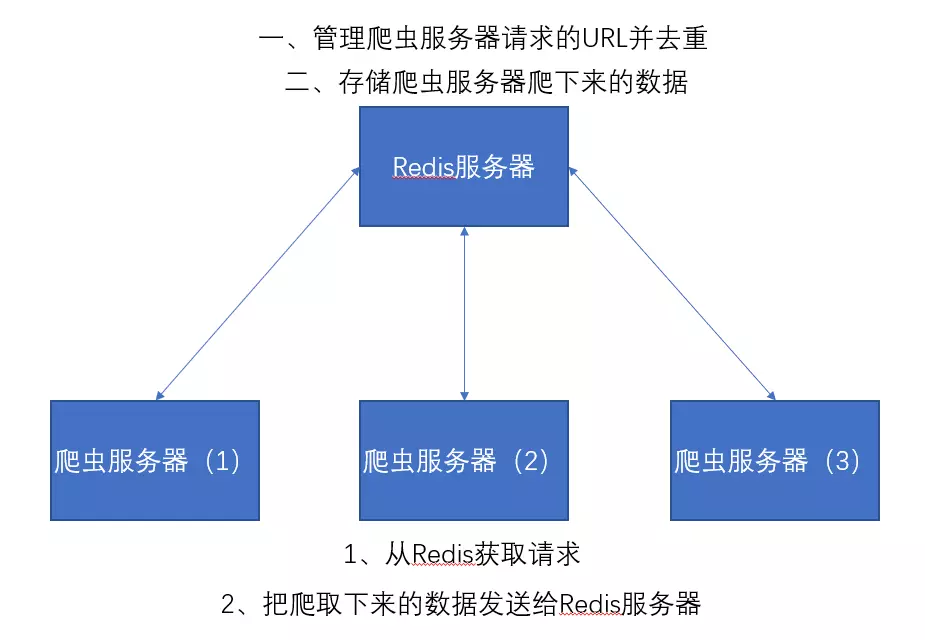
1.分布式爬虫是好几个台式机器在同时运行,保证不同的机器爬取页面的时候不会出现重复爬取的问题。
2.同样,分布式爬虫在不同的机器上运行,在把数据爬取完后如何保存在同一个地方。
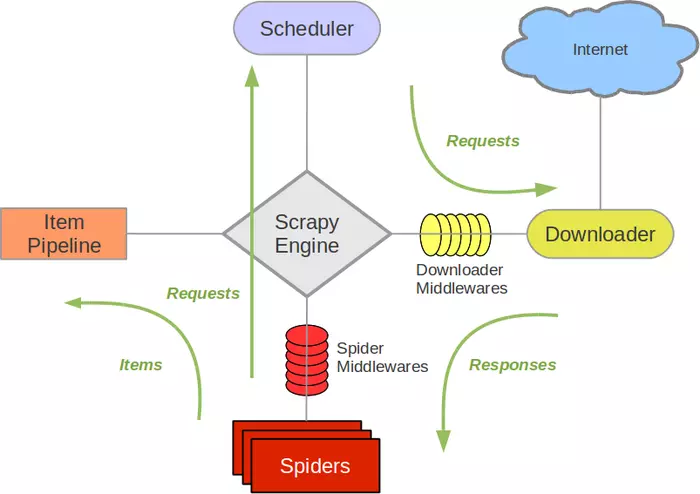
Scrapy 框架图
Scrapy-Redis
-分布式架构图:
Redis教程:
概述
redis是一种支持分布式的nosql数据库,他的数据是深存在内存中,同时可以将数据持久化,并且他比memcached 支持更多的数据结构(string,list,set,sorted set(有序集合),hash(hash)
redis使用的场景:
1.登录会话存储在redis中。memcached(缓存)
2.作为消息队列,‘celary’使用redis作为中间人(消息队列)
3.排行版/计数器:比如一些秀场类的项目,经常会有一些钱多少名的主播排名,或者点赞数之类的(计数器)
4. 当前在线人数,会显示当前系统多少在线人数。
5.一些常用的数据缓存:一些论坛,模块不会经常变化。但是每次访问首页都要从MySQL中获取,可以在redis中缓存起来,不用每次请求数据库。
6.把前200篇文章缓存或者评论缓存;一般用户浏览网站,只会浏览前面一部分文章或者评论,那么可以把前面200篇文章和对应的评论缓存起来,用户访问超时的,就访问数据库,并且以后文章超过200篇,则把之前的文章删除。
7.好友关系,微博的好友关系使用redis实现。
8.发布和订阅功能,可以用来聊天软件
具体分布式区别:https://www.cnblogs.com/457248499-qq-com/p/7392653.html
scrapy的使用--Rcrapy-Redis的更多相关文章
- scrapy与redis分布式组件
Scrapy 和 scrapy-redis的区别 Scrapy 是一个通用的爬虫框架,但是不支持分布式,Scrapy-redis是为了更方便地实现Scrapy分布式爬取,而提供了一些以redis为基础 ...
- Scrapy 和 scrapy-redis的区别
Scrapy 和 scrapy-redis的区别 Scrapy 是一个通用的爬虫框架,但是不支持分布式,Scrapy-redis是为了更方便地实现Scrapy分布式爬取,而提供了一些以redis为基础 ...
- scrapy入门与进阶
Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页内容以及各种图片,非 ...
- Python爬虫框架Scrapy教程(1)—入门
最近实验室的项目中有一个需求是这样的,需要爬取若干个(数目不小)网站发布的文章元数据(标题.时间.正文等).问题是这些网站都很老旧和小众,当然也不可能遵守 Microdata 这类标准.这时候所有网页 ...
- scrapy实战2分布式爬取lagou招聘(加入了免费的User-Agent随机动态获取库 fake-useragent 使用方法查看:https://github.com/hellysmile/fake-useragent)
items.py # -*- coding: utf-8 -*- # Define here the models for your scraped items # # See documentati ...
- scrapy基础知识之 Scrapy 和 scrapy-redis的区别:
Scrapy 和 scrapy-redis的区别 Scrapy 是一个通用的爬虫框架,但是不支持分布式,Scrapy-redis是为了更方便地实现Scrapy分布式爬取,而提供了一些以redis为基础 ...
- 浅析scrapy与scrapy_redis区别
最近在工作中写了很多 scrapy_redis 分布式爬虫,但是回想 scrapy 与 scrapy_redis 两者区别的时候,竟然,思维只是局限在了应用方面,于是乎,搜索了很多相关文章介绍,这才搞 ...
- scrapy架构流程
1.爬虫spiders将请求通过引擎传递给调度器scheduler 2.scheduler有个请求队列,在请求队列中拿出请求给下载器,downloader 3.downloader从Internet的 ...
- 浅析scrapy与scrapy-redis的区别
首先,要了解两者的区别,就要清楚scrapy-redis是如何产生的,有需求才会有发展,社会在日新月异的飞速发展,大量相似网页框架的飞速产生,人们已经不满足于当前爬取网页的速度,因此有了分布式爬虫,让 ...
- Scrapy-redis 分布式
分布式:架构方式 多台真实机器+爬虫(如requests,scrapy等)+任务共享中心 多台虚拟机器(或者部分虚拟部分真实)+爬虫(如requests,scrapy等)+任务共享中心 多台容器级虚拟 ...
随机推荐
- LINIX上Nginx的从零安装
源码编译方式: #一般系统中已经装了了make和g++,无须再装 安装make: yum -y install autoconf automake make 安装g++: yum -y install ...
- (转)rand函数和srand函数
转:http://www.cnblogs.com/lenient/articles/1565376.html 首先我们要对rand&srand有个总体的看法:srand初始化随机种子,rand ...
- Vi/Vim查找,替换,统计使用方法
Vi/Vim查找替换使用方法 vi/vim 中可以使用 :s 命令来替换字符串.该命令有很多种不同细节使用方法,可以实现复杂的功能,记录几种在此,方便以后查询. 可以使用 # 作为分隔符,此时中间出现 ...
- java IO 流小结
java IO 流小结 java流类图结构 流的分类 按方向 输入流 输出流 按类型 字节流 字符流 结论:只要是处理纯文本数据,就优先考虑使用字符流. 除此之外都使用字节流.
- CSS:CSS margin(外边距)
ylbtech-CSS:CSS margin(外边距) 1.返回顶部 1. CSS margin(外边距) CSS margin(外边距)属性定义元素周围的空间. margin margin 清除周围 ...
- 1. USB协议
1.1 Packets USB总线上数据传输以包为基本单位,一个包含不同的域,但都要从同步域开始,然后跟踪一个包标识符PID(Packet Identifier),最终以包结束符EOP(End of ...
- build protobuf to a static library
use ar cd src ar -cvq libprotobuf.a *.o
- (转载)理解和使用Promise.all和Promise.race
声明:本文转载自:https://www.jianshu.com/p/7e60fc1be1b2 一.Pomise.all的使用 Promise.all可以将多个Promise实例包装成一个新的Prom ...
- webdriver使用已打开过的chrome
基本功能: 执行脚本a,打开一个chrome,脚本a执行完成,chrome未关闭. 执行脚本b,继续使用a打开的chrome,不新启浏览器. 附加: 如果已打开的chrome未关闭,则在chrome中 ...
- centos7下利用nfs搭建wordpress
拓扑环境 web1 192.168.198.110 web2 192.168.198.120 mysql 192.168.198.130 DNS 192.168.198.10 NFS 192.168. ...