
Kafka源码分析(二) - 生产者
系列文章目录
https://zhuanlan.zhihu.com/p/367683572
一. 使用方式
show the code.
public class KafkaProducerDemo {

    public static void main(String[] args) {

        // step 1: 设置必要参数

        Properties config = new Properties();

        config.setProperty(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,

                "127.0.0.1:9092,127.0.0.1:9093");

        config.setProperty(ProducerConfig.ACKS_CONFIG, "-1");

        config.setProperty(ProducerConfig.RETRIES_CONFIG, "3");

        // step 2: 创建KafkaProducer

        KafkaProducer<String, String> producer = new KafkaProducer<>(config);

        // step 3: 构造要发送的消息

        String topic = "kafka-source-code-demo-topic";

        String key = "demo-key";

        String value = "村口老张头: This is a demo message.";

        ProducerRecord<String, String> record =

                new ProducerRecord<>(topic, key, value);

        // step 4: 发送消息

        Future<RecordMetadata> future = producer.send(record);

    }

}
step 1: 设置必要参数
代码中涉及的几个配置:
- bootstrap.servers:指定Kafka集群节点列表(全部 or 部分均可),用于KafkaProducer初始获取Server端元数据(如完整节点列表、Partition分布等等);
- acks:指定服务端有多少个副本完成同步,才算该Producer发出的消息写入成功(后面讲副本的文章会深入分析,这里按下不表);
- retries:失败重试次数;
更多参数可以参考ProducerConfig类中的常量列表。
step 2: 创建KafkaProducer
KafkaProducer两个模板参数指定了消息的key和value的类型
step 3:构造要发送的消息
- 确定目标topic;
String topic = "kafka-source-code-demo-topic";
- 确定消息的key
String key = "demo-key";
key用来决定目标Partition,这个下文细聊。
- 确定消息体
String value = "村口老张头: This is a demo message.";
这是待发送的消息内容,传递业务数据。
step 4:发送消息
Future<RecordMetadata> future = producer.send(record);
KafkaProducer中各类send方法均返回Future,并不会直接返回发送结果,其原因便是线程模型设计。
二. 线程模型
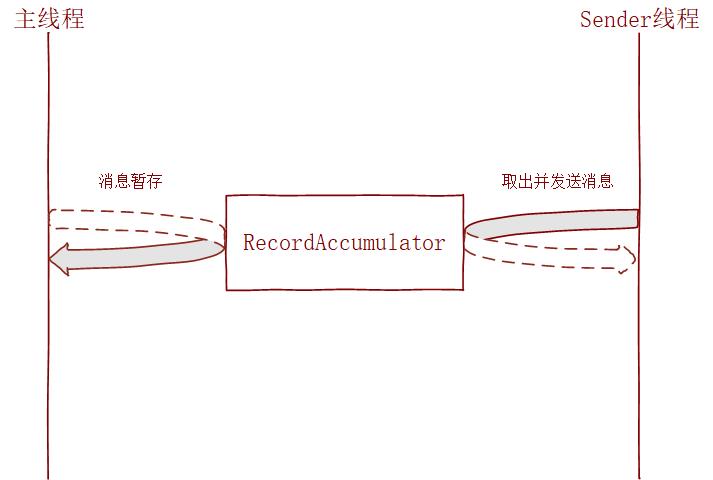
这里主要存在两个线程:主线程 和 Sender线程。主线程即调用KafkaProducer.send方法的线程。当send方法被调用时,消息并没有真正被发送,而是暂存到RecordAccumulator。Sender线程在满足一定条件后,会去RecordAccumulator中取消息并发送到Kafka Server端。
那么为啥不直接在主线程就把消息发送出去,非得搞个暂存呢?为了Kafka的目标之一——高吞吐。具体而言有两点好处:
- 可以将多条消息通过一个ProduceRequest批量发送出去;
- 提高数据压缩效率(一般压缩算法都是数据量越大越能接近预期的压缩效果);
三. 源码分析
先给个整体流程图,然后咱们再逐步分析。
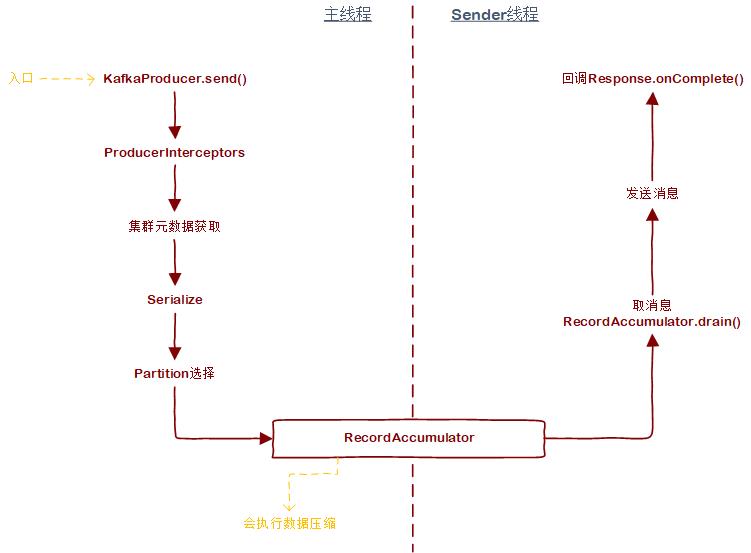
1. 主线程
1.1 KafkaProducer属性分析
这里列出KafkaProducer的核心属性。至于全部属性说明,可参考我的"注释版Kafka源码":https://github.com/Hao1296/kafka
| 字段名 | 字段类型 | 说明 |
|---|---|---|
| clientId | String | 生产者唯一标识 |
| partitioner | Partitioner | 分区选择器 |
| metadata | Metadata | Kafka集群元数据 |
| accumulator | RecordAccumulator | 消息缓存器 |
| sender | Sender | Sender线程业务逻辑封装,继承Runnable |
| ioThread | Thread | Sender线程对应的线程对象 |
| interceptors | ProducerInterceptors | 消息拦截器,下文会说明 |
1.2 ProducerInterceptors
ProducerInterceptors,消息拦截器集合,维护了多个ProducerInterceptor对象。用于在消息发送前对消息做额外的业务操作。使用时可按如下方式设置:
Properties config = new Properties();

// interceptor.classes

config.setProperty(ProducerConfig.INTERCEPTOR_CLASSES_CONFIG,

              "com.kafka.demo.YourProducerInterceptor,com.kafka.demo.InterceptorImpl2");

KafkaProducer<String, String> producer = new KafkaProducer<>(config);
ProducerInterceptor本身是一个接口:
public interface ProducerInterceptor<K, V> extends Configurable {

    ProducerRecord<K, V> onSend(ProducerRecord<K, V> record);

    void onAcknowledgement(RecordMetadata metadata, Exception exception);

    void close();

}
其中,onAcknowledgement是得到Server端正确响应时的回调,后面再细说。onSend是消息在发送前的回调,可在这里做一些消息变更逻辑(如加减字段等)。输入原始消息,输出变更后的消息。KafkaProducer的send方法第一步就是执行ProducerInterceptor:
@Override

public Future<RecordMetadata> send(ProducerRecord<K, V> record, Callback callback) {

    // intercept the record, which can be potentially modified;

    // this method does not throw exceptions

    // 关注这里

    ProducerRecord<K, V> interceptedRecord = this.interceptors.onSend(record);

    return doSend(interceptedRecord, callback);

}

// 该send方法重载核心逻辑仍是上面的send方法

@Override

public Future<RecordMetadata> send(ProducerRecord<K, V> record) {

    return send(record, null);

}
1.3 元数据获取
接上文,ProducerInterceptors执行完毕后会直接调用doSend方法执行发送相关的逻辑。到这为止有个问题,我们并不知道目标Topic下有几个Partition,分别分布在哪些Broker上;故,我们也不知道消息该发给谁。所以,doSend方法第一步就是搞清楚消息集群结构,即获取集群元数据:
private Future<RecordMetadata> doSend(ProducerRecord<K, V> record, Callback callback) {

    TopicPartition tp = null;

    try {

        throwIfProducerClosed();

        ClusterAndWaitTime clusterAndWaitTime;

        try {

            // 获取集群元数据

            clusterAndWaitTime = waitOnMetadata(record.topic(), record.partition(), maxBlockTimeMs);

        } catch (KafkaException e) {

            if (metadata.isClosed())

                throw new KafkaException("Producer closed while send in progress", e);

            throw e;

        }

        ... ...

    }
waiteOnMetadata方法内部大体分为2步:
private ClusterAndWaitTime waitOnMetadata(String topic, Integer partition, long maxWaitMs) throws InterruptedException {

    // 第1步, 判断是否已经有了对应topic&partition的元数据

    Cluster cluster = metadata.fetch();

    Integer partitionsCount = cluster.partitionCountForTopic(topic);

    if (partitionsCount != null && (partition == null || partition < partitionsCount))

        // 若已存在, 则直接返回

        return new ClusterAndWaitTime(cluster, 0);

    // 第2步, 获取元数据

    do {

        ... ...

        // 2.1 将目标topic加入元数据对象

        metadata.add(topic);

        // 2.3 将元数据needUpdate字段置为true, 并返回当前元数据版本

        int version = metadata.requestUpdate();

        // 2.4 唤醒Sender线程

        sender.wakeup();

        // 2.5 等待已获取的元数据版本大于version时返回, 等待时间超过remainingWaitMs时抛异常

        try {

            metadata.awaitUpdate(version, remainingWaitMs);

        } catch (TimeoutException ex) {

            throw new TimeoutException(

                String.format("Topic %s not present in metadata after %d ms.",

                    topic, maxWaitMs));

        }

        // 2.6 检查新版本元数据是否包含目标partition;

        // 若包含, 则结束循环; 若不包含, 则进入下一个迭代, 获取更新版本的元数据

        cluster = metadata.fetch();

        ......

        partitionsCount = cluster.partitionCountForTopic(topic);

    } while (partitionsCount == null || (partition != null && partition >= partitionsCount));

    return new ClusterAndWaitTime(cluster, elapsed);

}
我们看到,waitOnMetadata的思想也和简单,即:唤醒Sender线程来更新元数据,然后等待元数据更新完毕。至于Sender线程是如何更新元数据的,放到下文详解。
1.4 Serialize
这一步是用通过"key.serializer"和"value.serializer"两个配置指定的序列化器分别来序列化key和value
private Future<RecordMetadata> doSend(ProducerRecord<K, V> record, Callback callback) {

    .....

    // key序列化

    byte[] serializedKey;

    try {

        serializedKey = keySerializer.serialize(record.topic(), record.headers(), record.key());

    } catch (ClassCastException cce) {

        throw new SerializationException("Can't convert key of class " + record.key().getClass().getName() +

                " to class " + producerConfig.getClass(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG).getName() +

                " specified in key.serializer", cce);

    }

    // value序列化

    byte[] serializedValue;

    try {

        serializedValue = valueSerializer.serialize(record.topic(), record.headers(), record.value());

    } catch (ClassCastException cce) {

        throw new SerializationException("Can't convert value of class " + record.value().getClass().getName() +

                " to class " + producerConfig.getClass(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG).getName() +

                " specified in value.serializer", cce);

    }

    ......

}
Kafka内置了几个Serializer,如果需要的话,诸君也可以自定义:
org.apache.kafka.common.serialization.StringSerializer;
org.apache.kafka.common.serialization.LongSerializer;
org.apache.kafka.common.serialization.IntegerSerializer;
org.apache.kafka.common.serialization.ShortSerializer;
org.apache.kafka.common.serialization.FloatSerializer;
org.apache.kafka.common.serialization.DoubleSerializer;
org.apache.kafka.common.serialization.BytesSerializer;
org.apache.kafka.common.serialization.ByteBufferSerializer;
org.apache.kafka.common.serialization.ByteArraySerializer;
1.5 Partition选择
到这里,我们已经有了Topic相关的元数据,但也很快遇到了一个问题:Topic下可能有多个Partition,作为生产者,该将待发消息发给哪个Partition?这就用到了上文提到过的KafkaProducer的一个属性——partitioner。
private Future<RecordMetadata> doSend(ProducerRecord<K, V> record, Callback callback) {

    ......

    // 确定目标Partition

    int partition = partition(record, serializedKey, serializedValue, cluster);

    ......

}

private int partition(ProducerRecord<K, V> record, byte[] serializedKey, byte[] serializedValue, Cluster cluster) {

    // 若ProducerRecord中强制指定了partition, 则以该值为准

    Integer partition = record.partition();

    // 否则调用Partitioner动态计算对应的partition

    return partition != null ?

            partition :

            partitioner.partition(

                    record.topic(), record.key(), serializedKey, record.value(), serializedValue, cluster);

}
在创建KafkaProducer时,可以通过"partitioner.class"配置来指定Partitioner的实现类。若未指定,则使用Kafka内置实现类——DefaultPartitioner。DefaultPartitioner的策略也很简单:若未指定key,则在Topic下多个Partition间Round-Robin;若指定了key,则通过key来hash到一个partition。
public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) {

    List<PartitionInfo> partitions = cluster.partitionsForTopic(topic);

    int numPartitions = partitions.size();

    if (keyBytes == null) {

        // 若未指定key

        int nextValue = nextValue(topic);

        List<PartitionInfo> availablePartitions = cluster.availablePartitionsForTopic(topic);

        if (availablePartitions.size() > 0) {

            int part = Utils.toPositive(nextValue) % availablePartitions.size();

            return availablePartitions.get(part).partition();

        } else {

            // no partitions are available, give a non-available partition

            return Utils.toPositive(nextValue) % numPartitions;

        }

    } else {

        // hash the keyBytes to choose a partition

        return Utils.toPositive(Utils.murmur2(keyBytes)) % numPartitions;

    }

}
2. RecordAccumulator
RecordAccumulator作为消息暂存者,其思想是将目的地Partition相同的消息放到一起,并按一定的"规格"(由"batch.size"配置指定)划分成多个"批次"(ProducerBatch),然后以批次为单位进行数据压缩&发送。示意图如下:
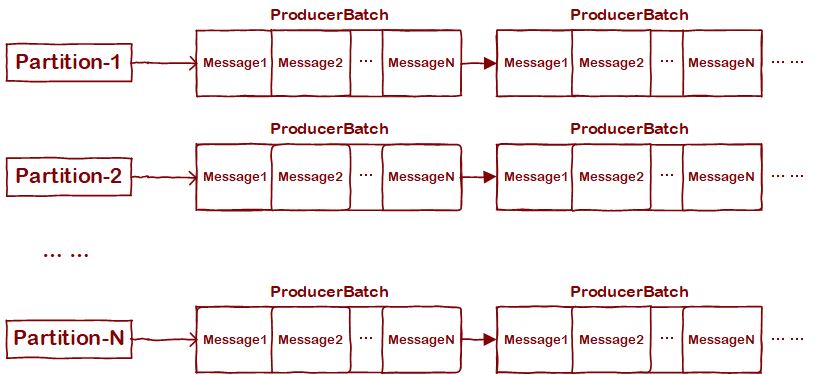
RecordAccumulator核心属性如下:
| 字段名 | 字段类型 | 说明 |
|---|---|---|
| batches | ConcurrentMap<TopicPartition, Deque<ProducerBatch>> | 按Partition维度存储消息数据, 即上文示意图描述的结构 |
| compression | CompressionType | 数据压缩算法 |
RecordAccumulator有两个核心方法,分别对应"存"和"取":
/**

 * 主线程会调用此方法追加消息

 */

public RecordAppendResult append(TopicPartition tp,

                                 long timestamp,

                                 byte[] key,

                                 byte[] value,

                                 Header[] headers,

                                 Callback callback,

                                 long maxTimeToBlock) throws InterruptedException;

/**

 * Sender线程会调用此方法提取消息

 */

public Map<Integer, List<ProducerBatch>> drain(Cluster cluster,

                                               Set<Node> nodes,

                                               int maxSize,

                                               long now);
3. Sender线程
3.1 NetworkClient
在分析Sender线程业务逻辑前,先来说说通信基础类。
NetworkClient有两个核心方法:
public void send(ClientRequest request, long now);

public List<ClientResponse> poll(long timeout, long now);
其中,send方法很有迷惑性。乍一看,觉得其业务逻辑是将request同步发送出去。然而,send方法其实并不实际执行向网络端口写数据的动作,只是将请求"暂存"起来。poll方法才是实际执行读写动作的地方(NIO)。当请求的目标channel可写时,poll方法会实际执行发送动作;当channel有数据可读时,poll方法读取响应,并做对应处理。
NetworkClient有一个核心属性:
/* 实际实现类为 org.apache.kafka.common.network.Selector */

private final Selectable selector;
send和poll方法都是通过selector来完成的:
public void send(ClientRequest request, long now) {

    doSend(request, false, now);

}

private void doSend(ClientRequest clientRequest, boolean isInternalRequest, long now) {

    ... ...

    doSend(clientRequest, isInternalRequest, now, builder.build(version));

}

private void doSend(ClientRequest clientRequest, boolean isInternalRequest, long now, AbstractRequest request) {

    ... ...

    selector.send(send);

}

public List<ClientResponse> poll(long timeout, long now) {

    ... ...

    this.selector.poll(Utils.min(timeout, metadataTimeout, defaultRequestTimeoutMs));

    ... ...

}
org.apache.kafka.common.network.Selector 内部则通过 java.nio.channels.Selector 来实现。
值得关注的一点是,NetworkClient的poll方法在调用Selector的poll方法前还有段业务逻辑:
// 在selector.poll前有此行逻辑

long metadataTimeout = metadataUpdater.maybeUpdate(now);

try {

    this.selector.poll(Utils.min(timeout, metadataTimeout, defaultRequestTimeoutMs));

} catch (IOException e) {

    log.error("Unexpected error during I/O", e);

}
metadataUpdater.maybeUpdate可以看出是为元数据更新服务的。其业务逻辑是:判断是否需要更新元数据;若需要,则通过NetworkClient.send方法将MetadataRequest也加入"暂存",等待selector.poll中被实际发送出去。
3.2 Sender线程业务逻辑
KafkaProducer中,和Sender线程相关的有两个属性:
| 字段名 | 字段类型 | 说明 |
|---|---|---|
| ioThread | Thread | Sender线程实例 |
| sender | Sender | Runnable实例,为Sender线程的具体业务逻辑 |
在KafkaProducer的构造函数中被创建:
KafkaProducer(ProducerConfig config,

                  Serializer<K> keySerializer,

                  Serializer<V> valueSerializer,

                  Metadata metadata,

                  KafkaClient kafkaClient) {

    ... ...

    this.sender = new Sender(logContext,

            client,

            this.metadata,

            this.accumulator,

            maxInflightRequests == 1,

            config.getInt(ProducerConfig.MAX_REQUEST_SIZE_CONFIG),

            acks,

            retries,

            metricsRegistry.senderMetrics,

            Time.SYSTEM,

            this.requestTimeoutMs,

            config.getLong(ProducerConfig.RETRY_BACKOFF_MS_CONFIG),

            this.transactionManager,

            apiVersions);

    String ioThreadName = NETWORK_THREAD_PREFIX + " | " + clientId;

    this.ioThread = new KafkaThread(ioThreadName, this.sender, true);

    this.ioThread.start();

    ... ...

}
Sender线程的业务逻辑也很清晰:
public void run() {

    log.debug("Starting Kafka producer I/O thread.");

    // 主循环

    while (running) {

        try {

            run(time.milliseconds());

        } catch (Exception e) {

            log.error("Uncaught error in kafka producer I/O thread: ", e);

        }

    }

    log.debug("Beginning shutdown of Kafka producer I/O thread, sending remaining records.");

    // 下面是关闭流程

    // okay we stopped accepting requests but there may still be

    // requests in the accumulator or waiting for acknowledgment,

    // wait until these are completed.

    while (!forceClose && (this.accumulator.hasUndrained() || this.client.inFlightRequestCount() > 0)) {

        try {

            run(time.milliseconds());

        } catch (Exception e) {

            log.error("Uncaught error in kafka producer I/O thread: ", e);

        }

    }

    if (forceClose) {

        // We need to fail all the incomplete batches and wake up the threads waiting on

        // the futures.

        log.debug("Aborting incomplete batches due to forced shutdown");

        this.accumulator.abortIncompleteBatches();

    }

    try {

        this.client.close();

    } catch (Exception e) {

        log.error("Failed to close network client", e);

    }

    log.debug("Shutdown of Kafka producer I/O thread has completed.");

}
主循环中仅仅是不断调用另一个run重载,该重载的核心业务逻辑如下:
void run(long now) {

    ... ...

    // 1. 发送请求,并确定下一步的阻塞超时时间

    long pollTimeout = sendProducerData(now);

    // 2. 处理端口事件,poll的timeout为上一步计算结果

    client.poll(pollTimeout, now);

}
其中,sendProducerData会调用RecordAccumulator.drain方法获取待发送消息,然后构造ProduceRequest对象,并调用NetworkClient.send方法"暂存"。sendProducerData方法之后便是调用NetworkClient.poll来执行实际的读写操作。
四. 总结
本文分析了KafkaProducer的业务模型及核心源码实现。才疏学浅,不一定很全面,欢迎诸君随时讨论交流。后续还会有其他模块的分析文章,具体可见系列文章目录: https://zhuanlan.zhihu.com/p/367683572
Kafka源码分析(二) - 生产者的更多相关文章
- Kafka源码分析系列-目录(收藏不迷路)
持续更新中,敬请关注! 目录 <Kafka源码分析>系列文章计划按"数据传递"的顺序写作,即:先分析生产者,其次分析Server端的数据处理,然后分析消费者,最后再补充 ...
- Kafka源码分析(一) - 概述
系列文章目录 https://zhuanlan.zhihu.com/p/367683572 目录 系列文章目录 一. 实际问题 二. 什么是Kafka, 如何解决这些问题的 三. 基本原理 1. 基本 ...
- Kafka源码分析(三) - Server端 - 消息存储
系列文章目录 https://zhuanlan.zhihu.com/p/367683572 目录 系列文章目录 一. 业务模型 1.1 概念梳理 1.2 文件分析 1.2.1 数据目录 1.2.2 . ...
- 多线程之美8一 AbstractQueuedSynchronizer源码分析<二>
目录 AQS的源码分析 该篇主要分析AQS的ConditionObject,是AQS的内部类,实现等待通知机制. 1.条件队列 条件队列与AQS中的同步队列有所不同,结构图如下: 两者区别: 1.链表 ...
- Fresco 源码分析(二) Fresco客户端与服务端交互(1) 解决遗留的Q1问题
4.2 Fresco客户端与服务端的交互(一) 解决Q1问题 从这篇博客开始,我们开始讨论客户端与服务端是如何交互的,这个交互的入口,我们从Q1问题入手(博客按照这样的问题入手,是因为当时我也是从这里 ...
- 框架-springmvc源码分析(二)
框架-springmvc源码分析(二) 参考: http://www.cnblogs.com/leftthen/p/5207787.html http://www.cnblogs.com/leftth ...
- Apache Kafka源码分析 – Broker Server
1. Kafka.scala 在Kafka的main入口中startup KafkaServerStartable, 而KafkaServerStartable这是对KafkaServer的封装 1: ...
- Tomcat源码分析二:先看看Tomcat的整体架构
Tomcat源码分析二:先看看Tomcat的整体架构 Tomcat架构图 我们先来看一张比较经典的Tomcat架构图: 从这张图中,我们可以看出Tomcat中含有Server.Service.Conn ...
- 十、Spring之BeanFactory源码分析(二)
Spring之BeanFactory源码分析(二) 前言 在前面我们简单的分析了BeanFactory的结构,ListableBeanFactory,HierarchicalBeanFactory,A ...
随机推荐
- 设计模式之建造者模式(BuilderPattern)
一.意义 将一个复杂的对象的构建与它的表示分离,使得同样的构建过程可以创建不同的表示. 说明:复杂对象的构建,比如一个对象有几十个成员属性,那么我们在创建这个对象,并给成员属性赋值时,就会很麻烦.采用 ...
- POJ_2752 Seek the Name, Seek the Fame 【KMP】
一.题目 POJ2752 二.分析 比较明显的KMP运用. 但是这题不是只找一个,仔细看题后可以发现相当于是在找到最大的满足条件的后缀后,再在这个后缀里面找满足条件的后缀. 可以不断的运用KMP得出答 ...
- JAVA-常用集合类型转换例子
package com.net.xinfang.reflect; import java.util.ArrayList; import java.util.Arrays; import java.ut ...
- Linux sed 使用笔记
sed 工具使用笔记 Linux中经常需要对一些超大的文本文件进行操作,例如 GB 级别的 CSV.TXT.LOG 文件,如果使用 vi 或者 vim 编辑器操作会非常慢且卡,此时 sed 工具或许可 ...
- Android中的TaskStack及启动模式
目录 前言 如何观察ActivityStack? 几个问题 关键类介绍 ActivityStack的创建与种类 不同启动模式 launchMode Standard SingleTop SingleT ...
- 关于一次配合开发工作而产生的服务器内核参数问题(Android 网络问题)
关于一次配合开发工作而产生的服务器内核参数问题(Android 网络问题) 问题转载(本人与作者遇到了同样的问题) 问题描述 问题描述:在这几年的Android开发中,遇到了一个困扰我好久的问题,有时 ...
- [面试仓库]CSS面试题汇总-定位篇
一,relative.absolute 的区别 我们还是来说常见的地方.首先就是relative,absolute的区别: relative是依据自身来定位的 absolute则是依据离其最近一层 ...
- MySQL数据库高级四:工具拾遗(视图)
视图
- create-react-app 核心思路分析
原文链接:http://axuebin.com/articles/fe-solution/cli/cra.html,转载请联系 Create React App is an officially su ...
- 自学转行JAVA,没有项目经历怎么找工作?
应届生或者是刚参加工作的转行人员都有这样一个疑惑,刚学出来没有工作经验,但是企业又要求你必须要有工作经验,但是刚毕业找不到工作就不可能有工作经验,感觉陷入一个死循环.其实这种情况那些企业是不可能不知道 ...