
spark (三) hadoop上传文件并运行spark
1. 上传文件到hdfs
# 前提挂载了 -v ~/bilibili/input_files:/input_files

# hdfs创建input文件夹

docker exec namenode hdfs dfs -mkdir /input

# 将容器内input_files文件夹下的1.txt上传到 hdfs的 /input下

docker exec namenode hdfs dfs -put /input_files/1.txt /input
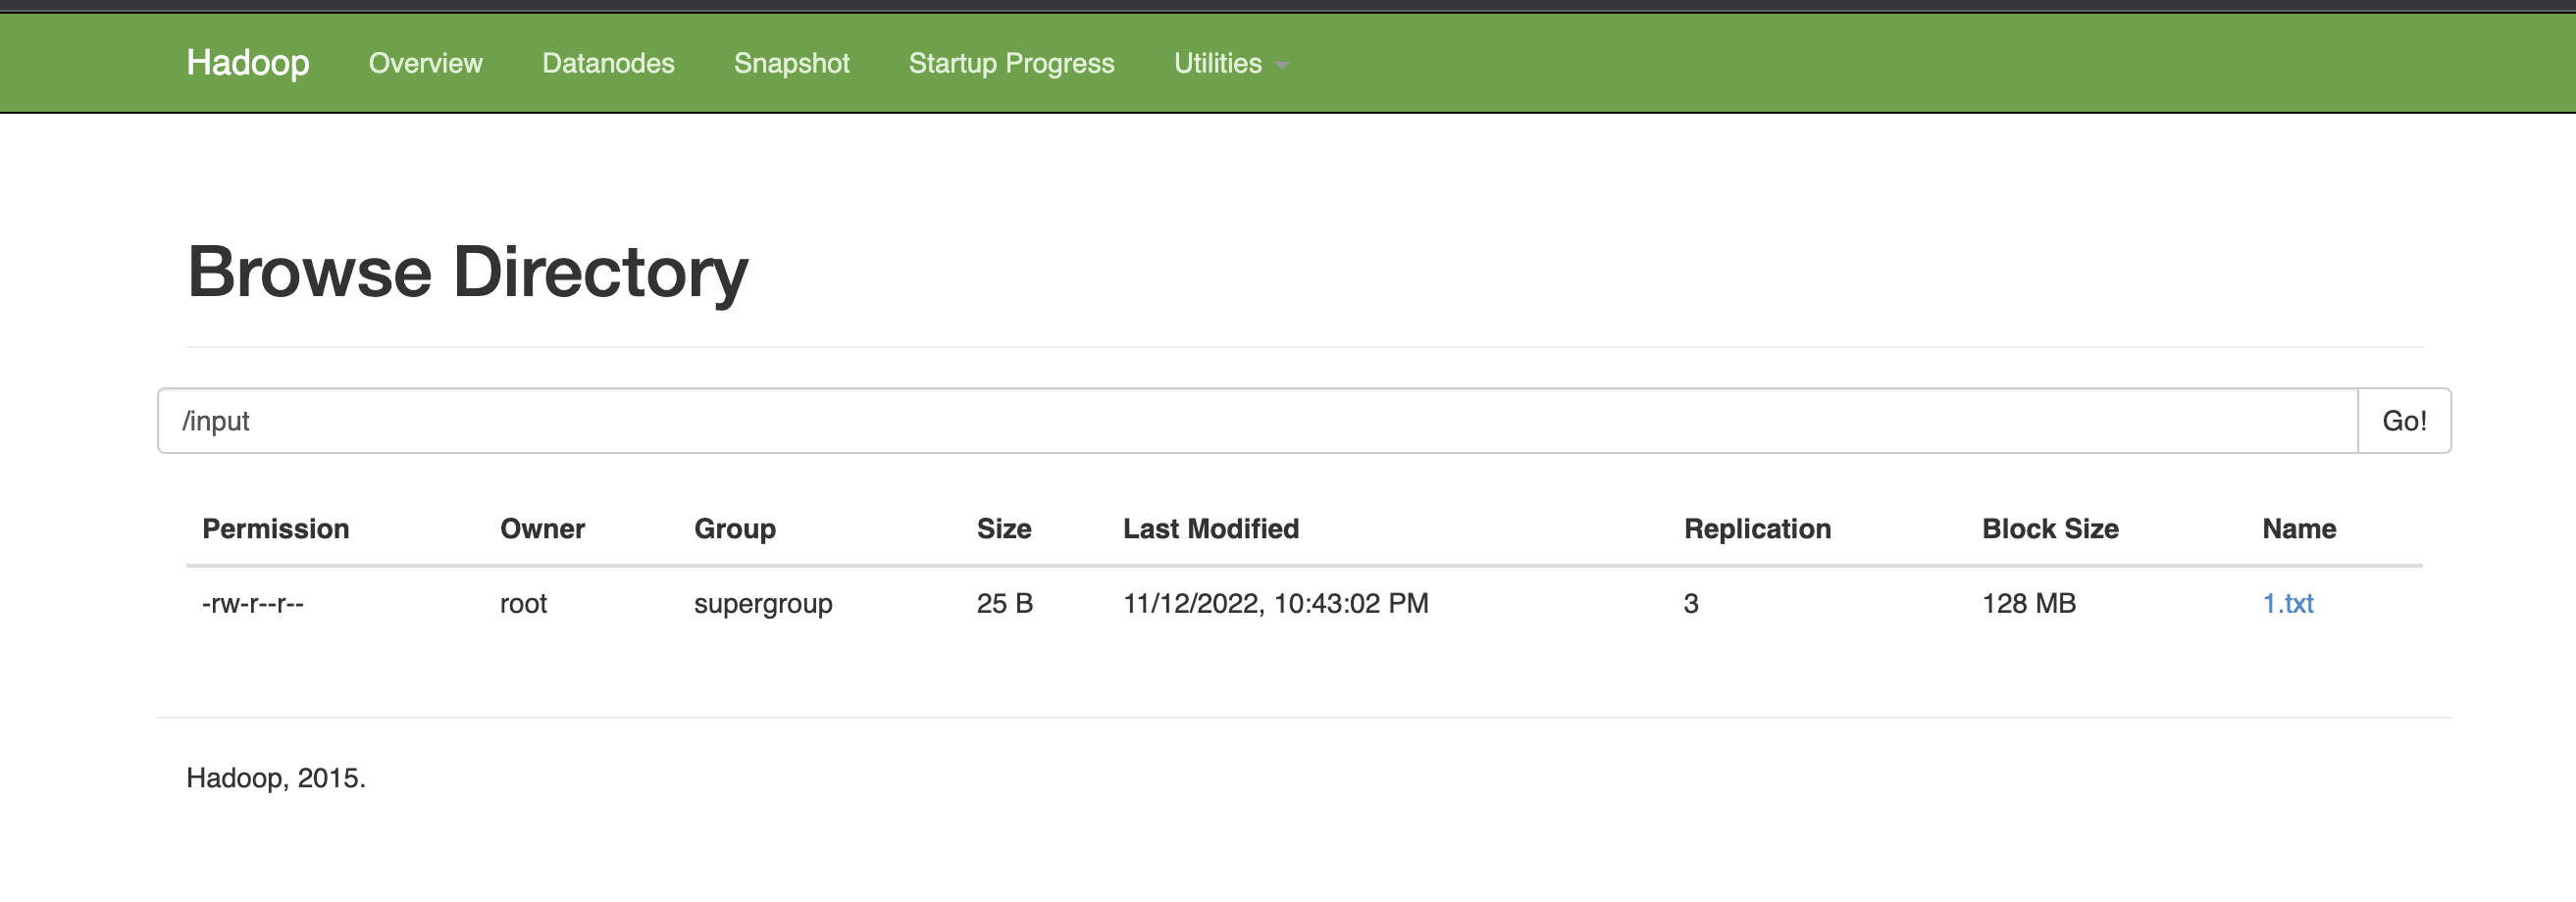
查看浏览器中是否有指定文件
2. 运行wordCount
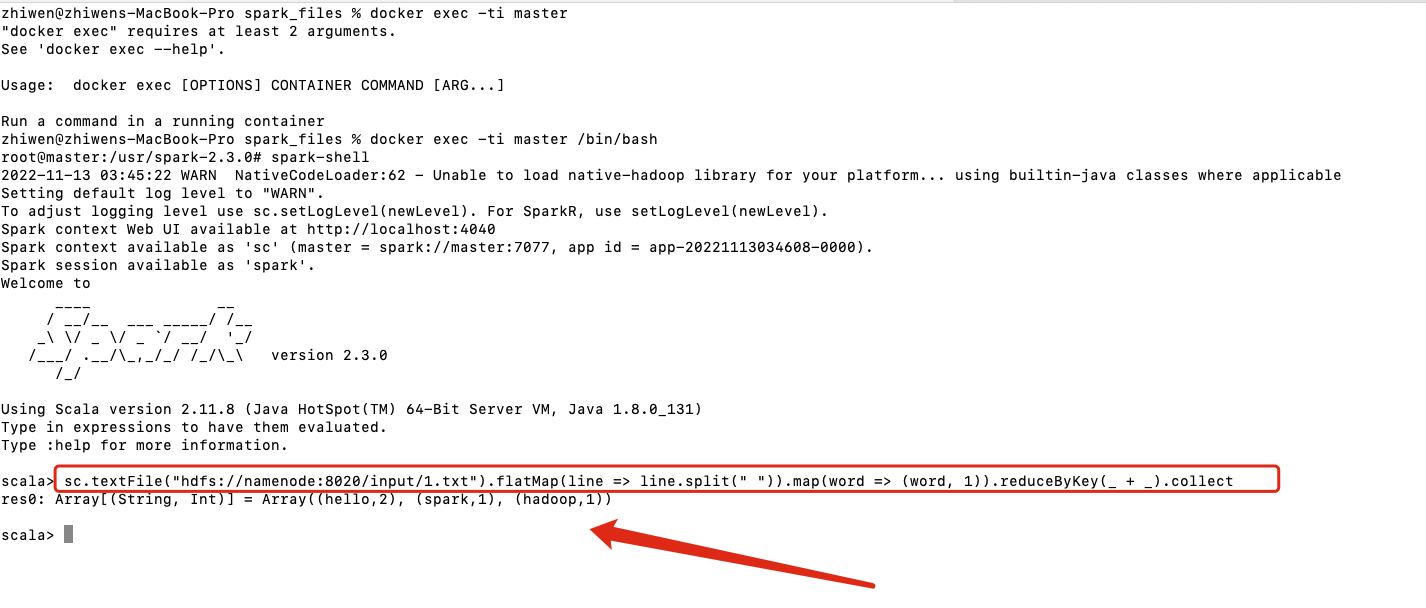
2.1 spark-shell运行
# 进入spark master容器内的spark-shell

docker exec -ti master spark-shell --executor-memory 1024M --total-executor-cores 2

# 执行wordCount

sc.textFile("hdfs://namenode:8020/input/1.txt").flatMap(line => line.split(" ")).map(word => (word, 1)).reduceByKey(_ + _).collect
2.2 spark-submit运行example(stand-alone)
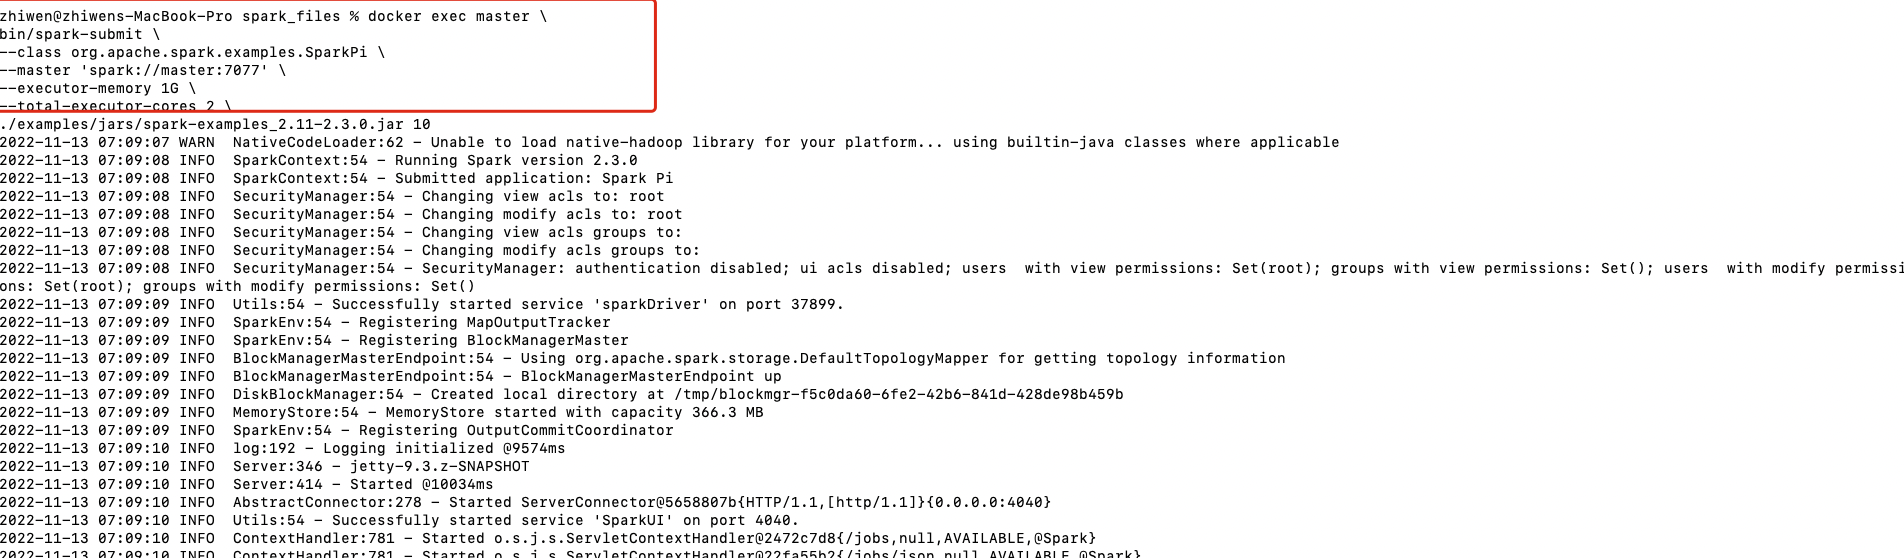
这里使用官方默认的example jar运行
docker exec master \

bin/spark-submit \

--class org.apache.spark.examples.SparkPi \

--master 'spark://master:7077' \

--executor-memory 1G \

--total-executor-cores 2 \

./examples/jars/spark-examples_2.12-3.2.1.jar \

10
| 参数 | 解释 | 可选值 |
|---|---|---|
| --class | Spark程序中包含主函数的类 | |
| --master | Spark程序运行的模式(环境) | local[*] spark://master:7077 yarn |
| --executor-memory | 每个executor可用内存为1G | |
| --total-executor-cores | 所有executor使用的cpu核数 | |
| application-jar | 打包好的应用jar, 包含依赖。这个URL在集群中全局可见 | 本地路径的jar包或者hdfs://路径 |
| application-arguements | 传给程序的参数 |
2.3 spark-submit运行example(yarn)
docker exec master \

bin/spark-submit \

--class org.apache.spark.examples.SparkPi \

--master yarn \

--deploy-mode cluster \

./examples/jars/spark-examples_2.12-3.2.1.jar \

10
2.4 spark-submit运行自定义的jar包(stand-alone)
2.4.1 自定义spark任务
package com.lzw.bigdata.spark.core.wordcount

import org.apache.spark.rdd.RDD

import org.apache.spark.{SparkConf, SparkContext}

object Spark03_WordCount {

  def main(args: Array[String]): Unit = {

    println("---------------start word_count----------------")

    // Spark框架步骤

    // 1. 建立和Spark框架的链接

    val sparkConfig: SparkConf = new SparkConf()

      //      .setMaster("local")

      .setAppName("WordCount")

    val ctx = new SparkContext(sparkConfig)

    println("----------------new SparkContext done---------------")

    // 2. 执行业务逻辑

    // 2.1 读取文件,获取一行一行的数据

    val inputPath: String = args(0)

    val lines: RDD[String] = ctx.textFile(inputPath)

    //    val lines: RDD[String] = ctx.textFile("hdfs://namenode:9000/input")

    println("----------------ctx.textFile done---------------")

    // 2.2 分词,此处按照空格spilt

    val words: RDD[String] = lines.flatMap(line => line.split(" "))

    val wordToOne: RDD[(String, Int)] = words.map(word => (word, 1))

    // Spark框架提供了更多的功能,可以将分组和聚合使用一个方法实现

    // 相同的key会对value做reduce

    val tuple: RDD[(String, Int)] = wordToOne.reduceByKey((t1, t2) => t1 + t2)

    val coll: Array[(String, Int)] = tuple.collect()

    coll.foreach(println)

    println(s"""----------------tuple.foreach(println) done len ${coll.length}---------------""")

    // 3. 关闭连接

    ctx.stop()

    println("----------------ctx.stop() done---------------")

  }

}
2.4.2 生成jar包
2.4.3 复制到挂载的jars文件夹内
2.4.4 运行spark-submit
docker exec master \

bin/spark-submit \

--class com.lzw.bigdata.spark.core.wordcount.Spark03_WordCount \

--master 'spark://master:7077' \

--executor-memory 1G \

--total-executor-cores 2 \

/jars/spark_core.jar \

'hdfs://namenode:9000/input'
spark (三) hadoop上传文件并运行spark的更多相关文章
- hadoop上传文件失败解决办法
hadoop上传文件到web端hdfs显示hadoop could only be replicated to 0 nodes instead of 1解决办法 错误状态:在hadoop-2.7.2目 ...
- 【大数据系列】hadoop上传文件报错_COPYING_ could only be replicated to 0 nodes
使用hadoop上传文件 hdfs dfs -put XXX 17/12/08 17:00:39 WARN hdfs.DFSClient: DataStreamer Exception org.ap ...
- 三种上传文件不刷新页面的方法讨论:iframe/FormData/FileReader
发请求有两种方式,一种是用ajax,另一种是用form提交,默认的form提交如果不做处理的话,会使页面重定向.以一个简单的demo做说明: html如下所示,请求的路径action为"up ...
- 三 : spring-uploadify上传文件
一 : applicationContext.xml中:必须声明不然获取不到<!-- 上传文件的配置 --> <bean id="multipartResolver&quo ...
- Hadoop上传文件时报错: could only be replicated to 0 nodes instead of minReplication (=1)....
问题 上传文件到Hadoop异常,报错信息如下: org.apache.hadoop.ipc.RemoteException(java.io.IOException): File /home/inpu ...
- hadoop上传文件报错
19/06/06 16:09:26 INFO hdfs.DFSClient: Exception in createBlockOutputStream java.io.IOException: Bad ...
- Hadoop上传文件的报错
baidu了很多,都说防火墙,datanode没有正常启动的问题,可是检查了都是正常,后来还是在老外的网站上找到了解决的方法 修改了/etc/security/limits.conf文件,上传成功 这 ...
- hadoop上传文件失败报错(put: Cannot create file/eclipse.desktop._COPYING_. Name node is in safe mode.)
解决办法: 离开安全模式方法:执行以下命令即可 bin/hadoop dfsadmin -safemode leave 若不处理安全模式的话,web服务无法启动,dfsadmin report结果异 ...
- C#远程执行Linux系统中Shell命令和SFTP上传文件
一.工具:SSH.Net 网址:https://github.com/sshnet/SSH.NET 二.调用命令代码: Renci.SshNet.SshClient ssh = "); ss ...
- CentOS7中利用Xshell6向虚拟机本地上传文件
环境交代 Linux系统:CentOS7, Xshell版本:6 操作步骤 下面我们以一个文件上传来演示用法 第一步 建立连接,这里不多说 在Xshell中点击如下图标,或者直接按 Alt+Ctrl+ ...
随机推荐
- java CAS及各种锁
CAS CAS 缺点:循环会耗时:一次性只能保持一个共享变量的原子性:ABA问题 package juc.cas; import java.util.concurrent.atomic.AtomicI ...
- Java统计list集合中重复的元素
本题目能够从宏观上理解list.set.map三大集合的特点: 解决思路是:使用一个map,key用来记录list中的数据,我们知道set集合不允许元素重复,正好在map的jdk8的api中有一个ke ...
- 分支定界方法(branch and cut,branch and price的基础)
分支定界方法(branch and cut,branch and price的基础) 目录 1.基础版的分支定界算法(假设是min问题) 2.分支定界算法的步骤及其注意事项 2.1 具体的分支定界方法 ...
- Win11右键默认显示更多设置
以管理员方式运行CMD,运行: reg.exe add "HKCU\Software\Classes\CLSID\{86ca1aa0-34aa-4e8b-a509-50c905bae2a2} ...
- winform 音乐播放器
引言 本次项目目的主要为了熟悉axWindowsMediaPlayer,treeview等控件使用,以及学习I/O操作. 技术栈 C# winform 实现效果 设计与实现 使用TreeView实现音 ...
- Lncpc2024 游记
Day 0 7:30 起的比较早,和同学xjt约好了一起写作业,起来之后感觉身上有点冷,之前考CSP的时候就有点感冒,所以决定洗个热水澡,出来就写作业了. 9:30 学习状态还可以,比较沉浸式,这个时 ...
- 用“tar | split ”将文件分包压缩
1.一次打包: tar cjf - directory/ | split -b 100m -d -a 1 - filename.tar.bz2. (directory/):待压缩的目录名. (spli ...
- Manjaro/Arch用怎么安装天翼云电脑(Ctyun-cloud-desk)?感谢信创,感谢国家
最近微信出了linux版,用vmware装linux不过瘾,把一台闲置的笔记本装上了Manjaro KDE Plasma,经过一段时间的发展,Linux桌面可用性大大提高. Kindle->Ki ...
- 一个基于 .NET 8.0 构建的简单、跨平台、模块化商城系统
前言 今天给大家分享一个基于 .NET 8.0 构建的开源免费(MIT License).简单.跨平台.模块化的商城系统:Module Shop. 主要功能 销售:订单.物流. 内容:首页配置.评论. ...
- Windows远程登录到VirtualBox安装的Ubuntu11.10
一.环境 本地:Windows xp 虚拟机:VirtualBox 虚拟机的操作系统:Linux-Ubuntu11.10 二.目的 在Windows下通过SecureCRT(putty也可)远程登录到 ...