
HashMap的自定义实现
一、背景:
package com.cy.collection;

public class Wife {

    String name;

    public Wife(String name){

        this.name = name;

    }

    @Override

    public String toString() {

        return "Wife [name=" + name + "]";

    }

}
Map.java:
package com.cy.collection;

/**

 * 自定义实现Map

 */

public class Map {

    private Entry[] arr = new Entry[1000];    //这里暂时不考虑扩容

    private int size;                        //这里都是private的,不暴露size属性

    /**

     * 1.键不能重复,如果含有这个键,就替换value

     * @param key

     * @param value

     */

    public void put(Object key, Object value){

        for(int i=0; i<size; i++){

            if(arr[i].key.equals(key)){

                arr[i].value = value;

                return;

            }

        }

        arr[size++] = new Entry(key, value);

    }

    //根据key获取

    public Object get(Object key){

        for(int i=0; i<size; i++){

            if(arr[i].key.equals(key)){

                return arr[i].value;

            }

        }

        return null;

    }

    //根据key删除

    public boolean remove(Object key){

        boolean success = false;

        for(int i=0;i<size;i++){

            if(arr[i].key.equals(key)){

                success = true;

                remove(i);

            }

        }

        return success;

    }

    private void remove(int i){

        int numMoved = size - i - 1;

        if(numMoved>0){

            System.arraycopy(arr, i+1, arr, i, numMoved);

        }

        arr[--size] = null;        //Let gc do its work

    }

    //containsKey

    public boolean containsKey(Object key){

        for(int i=0; i<size; i++){

            if(arr[i].key.equals(key)){

                return true;

            }

        }

        return false;

    }

    //containsValue 同containsKey

    //size

    public int size(){

        return size;

    }

}

/**

 * 用来存放键值对的条目

 */

class Entry{

    Object key;

    Object value;

    public Entry(Object key, Object value) {

        super();

        this.key = key;

        this.value = value;

    }

}
Test.java测试代码:
package com.cy.collection;

public class Test {

    public static void main(String[] args) {

        Map map = new Map();

        map.put("张三", new Wife("abc"));

        map.put("李四", new Wife("def"));

        map.put("王五", new Wife("ghi"));

        System.out.println(map.get("张三"));

        map.remove("李四");

        System.out.println(map.size());

        map.put("张三", new Wife("aaa"));

        System.out.println(map.get("张三"));

        System.out.println(map.containsKey("张三"));

    }

}

输出:

Wife [name=abc]

2

Wife [name=aaa]

true
二、map改进,哈希算法实现,使用数组和链表
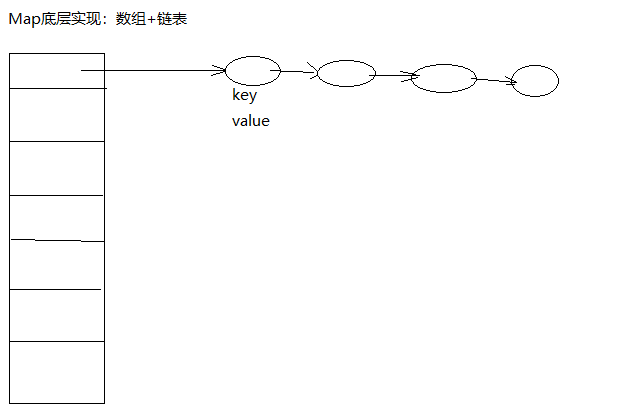
package com.cy.collection;

import java.util.LinkedList;

/**

 * 自定义实现Map升级版

 * 1.提高查询的效率

 */

public class Map {

    private LinkedList[] arr = new LinkedList[1000];    //Map的底层结构就是:数组+链表

    private int size;

    /**

     * 1.键不能重复,如果含有这个键,就替换value

     */

    public void put(Object key, Object value){

        Entry e = new Entry(key, value);

     int hash = key.hashCode();
     hash = hash<0?-hash:hash;
        int a = hash % arr.length;

        if(arr[a]==null){

            LinkedList list = new LinkedList();

            arr[a] = list;

            list.add(e);

        }else{

            LinkedList list = arr[a];

            for(int i=0; i<list.size(); i++){

                Entry en = (Entry) list.get(i);

                if(en.key.equals(key)){

                    en.value = value;            //键值重复,覆盖value

                    return;

                }

            }

            list.add(e);

        }

        size++;

    }

    //根据key获取值

    public Object get(Object key){

        int a = key.hashCode() % arr.length;

        if(arr[a]!=null){

            LinkedList list = arr[a];

            for(int i=0; i<list.size(); i++){

                Entry e = (Entry) list.get(i);

                if(e.key.equals(key)){

                    return e.value;

                }

            }

        }

        return null;

    }

    //size

    public int size(){

        return size;

    }

}

/**

 * 用来存放键值对的条目

 */

class Entry{

    Object key;

    Object value;

    public Entry(Object key, Object value) {

        super();

        this.key = key;

        this.value = value;

    }

}
Test.java
package com.cy.collection;

public class Test {

    public static void main(String[] args) {

        Map map = new Map();

        map.put("张三", new Wife("abc"));

        map.put("李四", new Wife("def"));

        map.put("张三", new Wife("ghi"));

        System.out.println(map.get("张三"));

        System.out.println(map.size());

    }

}

输出:

Wife [name=ghi]

2
HashMap的自定义实现的更多相关文章
- HashMap存储自定义类型键值和LinkedHashMap集合
HashMap存储自定义类型键值 1.当给HashMap中存放自定义对象时,如果自定义对象是键存在,保证键唯一,必须复写对象的hashCode和equals方法. 2.如果要保证map中存放的key和 ...
- 集合框架-Map集合-HashMap存储自定义对象
1 package cn.itcast.p6.hashmap.demo; 2 3 import java.util.HashMap; 4 import java.util.Iterator; 5 im ...
- HashSet的自定义实现
package com.cy.collection; import java.util.HashMap; /** * HashSet自定义实现 * 是使用hashMap实现的 * 可以看一下HashS ...
- Java 集合学习--HashMap
一.HashMap 定义 HashMap 是一个基于散列表(哈希表)实现的键值对集合,每个元素都是key-value对,jdk1.8后,底层数据结构涉及到了数组.链表以及红黑树.目的进一步的优化Has ...
- springboot 简单自定义starter - beetl
使用idea新建springboot项目beetl-spring-boot-starter 首先添加pom依赖 packaging要设置为jar不能设置为pom<packaging>jar ...
- 通过简单的两数相加体会hashmap的好处
目录 引入题目:两数相加 HashMap相关知识: Map集合 Map集合的特点 Map常用子类 HashMap集合 LinkedHashMap集合 Map集合的常用方法 Map集合的第一种遍历方式: ...
- Java 之 HashMap 集合
一.HashMap 概述 java.util.HashMap<k,v> 集合 implements Map<k,v> 接口 HashMap 集合的特点: 1.HashMap 集 ...
- hashmap存储数据
在HashMap中,为什么不能使用基本数据类型作为key? 其实和HashMap底层的存储原理有关,HashMap存储数据的特点是:无序.无索引.不能存储重复元素. 存储元素采用的是hash表存储数据 ...
- HashMap -双列集合的遍历与常用的方法
package cn.learn.Map; /* java.util.Hashtable<k,y> implements Map<k,v> 早期双列集合,jdk1.0开始 同步 ...
随机推荐
- TP thinkphp 权限管理 权限认证 功能
(如有打扰,请忽略)阿里云ECS大羊群,2U4G低至1.4折,限实名新用户,需要的点吧https://promotion.aliyun.com/ntms/act/vm/aliyun-group/tea ...
- 《DSP using MATLAB》Problem 6.6
代码: %% ++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++++ %% Output In ...
- 走进 AQS 瞧一瞧看一看
并发中有一块很重要的东西就是AQS.接下来一周的目标就是它. 看复杂源码时,一眼望过去,这是什么?不要慌,像剥洋葱一样,一层层剥开(哥,喜欢"扒开"这个词). 参考资源: http ...
- SELECT INTO 和 INSERT INTO SELECT 两种表复制语句详解(SQL数据库和Oracle数据库的区别)
https://www.cnblogs.com/mq0036/p/4155136.html 我们经常会遇到需要表复制的情况,如将一个table1的数据的部分字段复制到table2中,或者将整个tabl ...
- JavaScript 缓存基本原理
// 这是个闭包函数,接收一个函数,可以把接收的函数转换成具有缓存能力的函数 var memoize = function(f) { // 使用一个 cache 对象来进行缓存 var cache = ...
- Js 分别取一个数的百位,十位,个位
<!DOCTYPE HTML> <html lang="en-US"> <head> <meta charset="UTF-8& ...
- vuex简介(转载)
安装.使用 vuex 首先我们在 vue.js 2.0 开发环境中安装 vuex : npm install vuex --save 然后 , 在 main.js 中加入 : import vuex ...
- shell入门(二)——面试题实例
[~/shell]$ cat one.sh #!/bin/bash path=/root/shell/test.txt if [ ! -f $path ] //检测文件是否存在,如果不存在,把内容改为 ...
- VxWorks笔记
利用vxWorks可裁减可动态链接特性进行模块调试的分析 a) 首先,可将root.c简化,去掉大部分不需要加载的模块和想要调试的模块,以加快系统启动速度. b) 如果vxworks加载的.o中引用了 ...
- nuxt docker 运行
nuxt 是vue 版的next ,实现的功能还是很方便的,对于需要开发性能要求比较高的web app 是一个很不错的选择 备注: 项目很简单,使用docker && docker-c ...