
mxnet自定义dataloader加载自己的数据
实际上关于pytorch加载自己的数据之前有写过一篇博客,但是最近接触了mxnet,发现关于这方面的教程很少
如果要加载自己定义的数据的话,看mxnet关于mnist基本上能够推测12
看pytorch与mxnet他们加载数据方式的对比
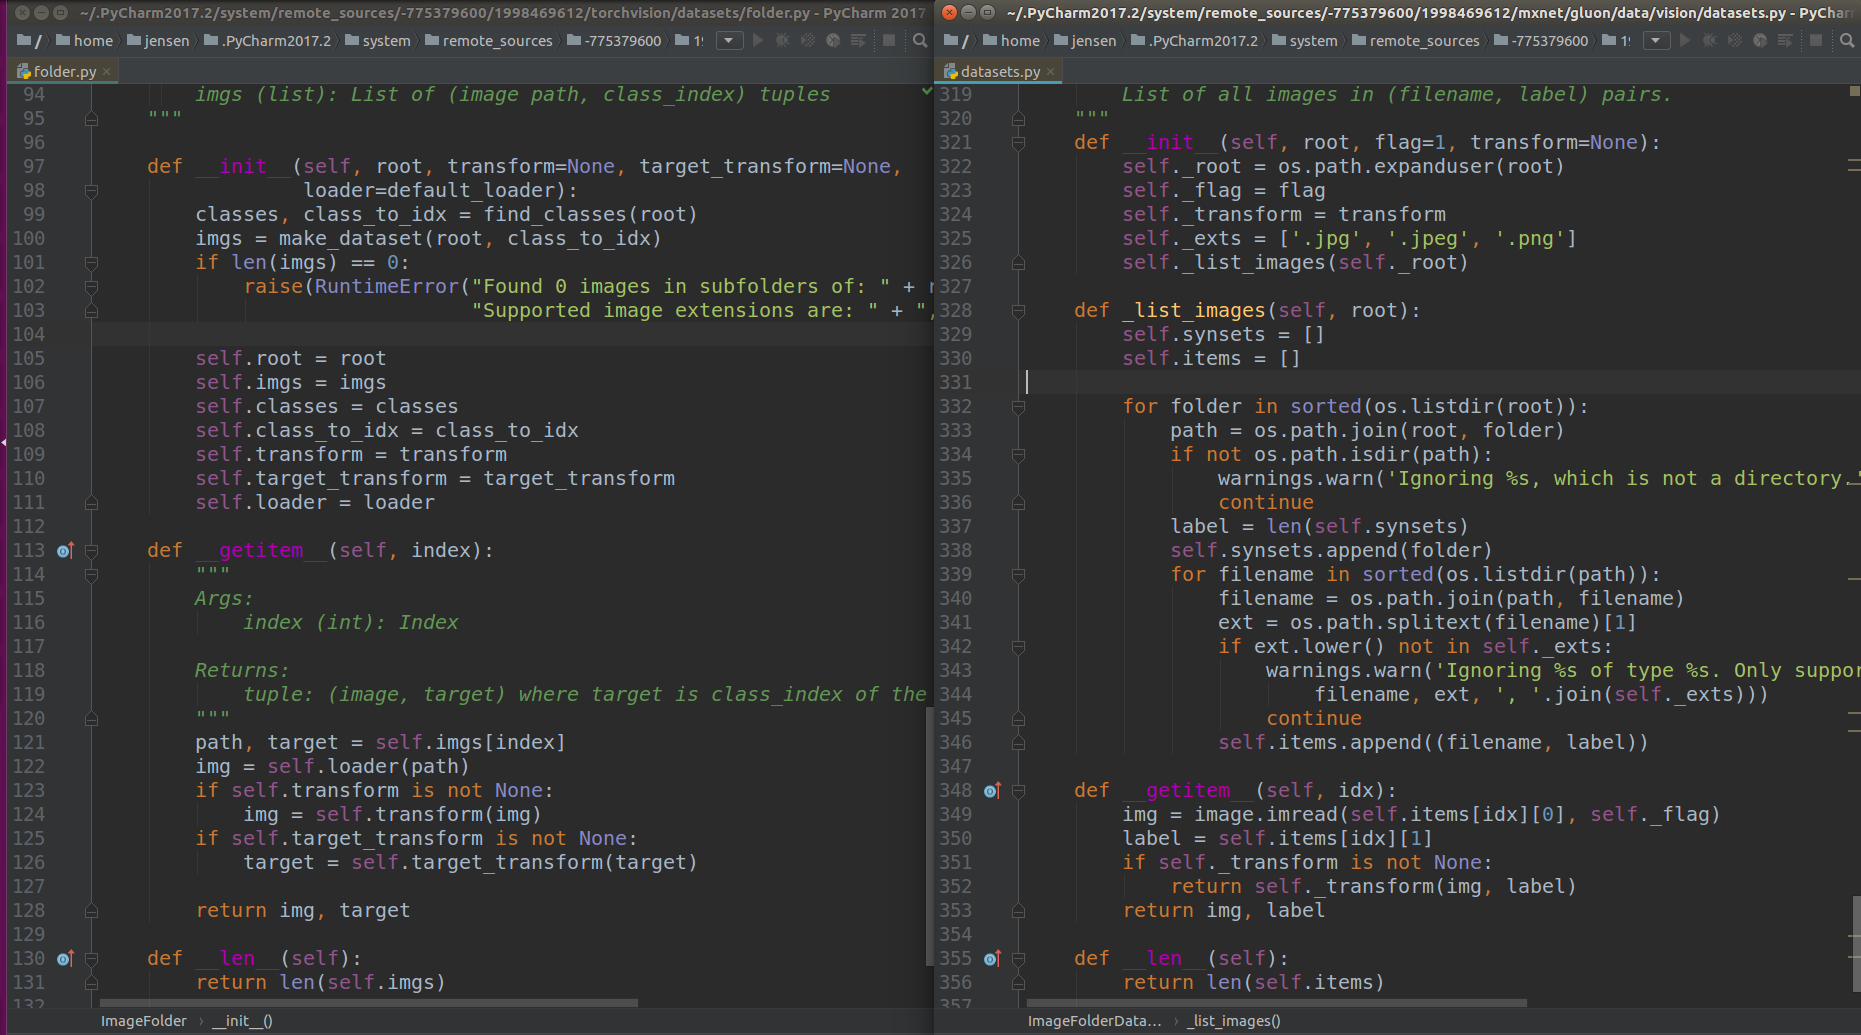
上图左边是pytorch的,右图是mxnet
实际上,mxnet与pytorch他们的datalayer有着相似之处,为什么这样说呢?直接看上面的代码,基本上都是输入图像的路径,然后输出一个可以供loader调用的可以迭代的对象,所以无论是pytorch或者是mxnet,如果要有自己的数据,只需要在自己的数据那一部分继承与修改ImageFolderDataset这个函数就行,就是直接继承dataset.Dataset类即可
对于pytorch而言,它使用了find_class这样一个函数,而对于mxnet而言,实际上它在类内部定义了一个_list_images的函数,事实上我并没有发现这有没有用,只需要get_item这个函数中返回list,list中是一个tuple,一个是文件的名字,另外一个是文件所对应的label即可。
只需要继承这一个类即可
直接撸代码
这个是我参加kaggle比赛的一段代码,尽管并不收敛,但请不要在意这些细节
 # -*-coding:utf-8-*-

 from mxnet import autograd

 from mxnet import gluon

 from mxnet import image

 from mxnet import init

 from mxnet import nd

 from mxnet.gluon.data import vision

 import numpy as np

 from mxnet.gluon.data import dataset

 import os

 import warnings

 import random

 from mxnet import gpu

 from mxnet.gluon.data.vision import datasets

 class MyImageFolderDataset(dataset.Dataset):

     def __init__(self, root, label, flag=1, transform=None):

         self._root = os.path.expanduser(root)

         self._flag = flag

         self._label = label

         self._transform = transform

         self._exts = ['.jpg', '.jpeg', '.png']

         self._list_images(self._root, self._label)

     def _list_images(self, root, label):  # label是一个list

         self.synsets = []

         self.synsets.append(root)

         self.items = []

         #file = open(label)

         #lines = file.readlines()

         #random.shuffle(lines)

         c = 0

         for line in label:

             cls = line.split()

             fn = cls.pop(0)

             fn = fn + '.jpg'

             # print(os.path.join(root, fn))

             if os.path.isfile(os.path.join(root, fn)):

                 self.items.append((os.path.join(root, fn), float(cls[0])))

                 # print((os.path.join(root, fn), float(cls[0])))

             else:

                 print('what')

             c = c + 1

         print('the total image is ', c)

     def __getitem__(self, idx):

         img = image.imread(self.items[idx][0], self._flag)

         label = self.items[idx][1]

         if self._transform is not None:

             return self._transform(img, label)

         return img, label

     def __len__(self):

         return len(self.items)

 def _get_batch(batch, ctx):  # 可以在循环中直接for i, data, label,函数主要把data放在ctx上

     """return data and label on ctx"""

     if isinstance(batch, mx.io.DataBatch):

         data = batch.data[0]

         label = batch.label[0]

     else:

         data, label = batch

     return (gluon.utils.split_and_load(data, ctx),

             gluon.utils.split_and_load(label, ctx),

             data.shape[0])

 def transform_train(data, label):

     im = image.imresize(data.astype('float32') / 255, 256, 256)

     auglist = image.CreateAugmenter(data_shape=(3, 256, 256), resize=0,

                         rand_crop=False, rand_resize=False, rand_mirror=True,

                         mean=None, std=None,

                         brightness=0, contrast=0,

                         saturation=0, hue=0,

                         pca_noise=0, rand_gray=0, inter_method=2)

     for aug in auglist:

         im = aug(im)

     # 将数据格式从"高*宽*通道"改为"通道*高*宽"。

     im = nd.transpose(im, (2, 0, 1))

     return (im, nd.array([label]).asscalar().astype('float32'))

 def transform_test(data, label):

     im = image.imresize(data.astype('float32') / 255, 256, 256)

     im = nd.transpose(im, (2, 0, 1))  # 之前没有运行此变换

     return (im, nd.array([label]).asscalar().astype('float32'))

 batch_size = 16

 root = '/home/ying/data2/shiyongjie/landmark_recognition/data/image'

 def random_choose_data(label_path):

     f = open(label_path)

     lines = f.readlins()

     random.shuffle(lines)

     total_number = len(lines)

     train_number = total_number/10*7

     train_list = lines[:train_number]

     test_list = lines[train_number:]

     return (train_list, test_list)

 label_path = '/home/ying/data2/shiyongjie/landmark_recognition/data/train.txt'

 train_list, test_list = random_choose_data(label_path)

 loader = gluon.data.DataLoader

 train_ds = MyImageFolderDataset(os.path.join(root, 'image'), train_list, flag=1, transform=transform_train)

 test_ds = MyImageFolderDataset(os.path.join(root, 'Testing'), test_list, flag=1, transform=transform_test)

 train_data = loader(train_ds, batch_size, shuffle=True, last_batch='keep')

 test_data = loader(test_ds, batch_size, shuffle=False, last_batch='keep')

 softmax_cross_entropy = gluon.loss.L2Loss()  # 定义L2 loss

 from mxnet.gluon import nn

 net = nn.Sequential()

 with net.name_scope():

     net.add(

         # 第一阶段

         nn.Conv2D(channels=96, kernel_size=11,

                   strides=4, activation='relu'),

         nn.MaxPool2D(pool_size=3, strides=2),

         # 第二阶段

         nn.Conv2D(channels=256, kernel_size=5,

                   padding=2, activation='relu'),

         nn.MaxPool2D(pool_size=3, strides=2),

         # 第三阶段

         nn.Conv2D(channels=384, kernel_size=3,

                   padding=1, activation='relu'),

         nn.Conv2D(channels=384, kernel_size=3,

                   padding=1, activation='relu'),

         nn.Conv2D(channels=256, kernel_size=3,

                   padding=1, activation='relu'),

         nn.MaxPool2D(pool_size=3, strides=2),

         # 第四阶段

         nn.Flatten(),

         nn.Dense(4096, activation="relu"),

         nn.Dropout(.5),

         # 第五阶段

         nn.Dense(4096, activation="relu"),

         nn.Dropout(.5),

         # 第六阶段

         nn.Dense(14950)  # 输出为1个值

     )

 from mxnet import init

 from mxnet import gluon

 import mxnet as mx

 import utils

 import datetime

 from time import time

 ctx = utils.try_gpu()

 net.initialize(ctx=ctx, init=init.Xavier())

 mse_loss = gluon.loss.L2Loss()

 # utils.train(train_data, test_data, net, loss,

 #             trainer, ctx, num_epochs=10)

 #def train(train_data, test_data, net, loss, trainer, ctx, num_epochs, print_batches=None):

 num_epochs = 10

 print_batches = 100

 """Train a network"""

 print("Start training on ", ctx)

 if isinstance(ctx, mx.Context):

     ctx = [ctx]

 def train(net, train_data, valid_data, num_epochs, lr, wd, ctx, lr_period, lr_decay):

     trainer = gluon.Trainer(net.collect_params(), 'sgd',

                             {'learning_rate': lr, 'momentum': 0.9, 'wd': wd})

     prev_time = datetime.datetime.now()

     for epoch in range(num_epochs):

         train_loss = 0.0

         if epoch > 0 and epoch % lr_period == 0:

             trainer.set_learning_rate(trainer.learning_rate*lr_decay)

         for data, label in train_data:

             label = label.as_in_context(ctx)

             with autograd.record():

                 output = net(data.as_in_context(ctx))

                 loss = mse_loss(output, label)

             loss.backward()

             trainer.step(batch_size)  # do the update, Trainer needs to know the batch size of the data to normalize

             # the gradient by 1/batch_size

             train_loss += nd.mean(loss).asscalar()

             print(nd.mean(loss).asscalar())

         cur_time = datetime.datetime.now()

         h, remainder = divmod((cur_time - prev_time).seconds, 3600)

         m, s = divmod(remainder, 60)

         time_str = "Time %02d:%02d:%02d" % (h, m, s)

         epoch_str = ('Epoch %d. Train loss: %f, ' % (epoch, train_loss / len(train_data)))

         prev_time = cur_time

         print(epoch_str + time_str + ', lr' + str(trainer.learning_rate))

     net.collect_params().save('./model/alexnet.params')

 ctx = utils.try_gpu()

 num_epochs = 100

 learning_rate = 0.001

 weight_decay = 5e-4

 lr_period = 10

 lr_decay = 0.1

 train(net, train_data, test_data, num_epochs, learning_rate,

       weight_decay, ctx, lr_period, lr_decay)
请看这一段
 class MyImageFolderDataset(dataset.Dataset):

     def __init__(self, root, label, flag=1, transform=None):

         self._root = os.path.expanduser(root)

         self._flag = flag

         self._label = label

         self._transform = transform

         self._exts = ['.jpg', '.jpeg', '.png']

         self._list_images(self._root, self._label)

     def _list_images(self, root, label):  # label是一个list

         self.synsets = []

         self.synsets.append(root)

         self.items = []

         #file = open(label)

         #lines = file.readlines()

         #random.shuffle(lines)

         c = 0

         for line in label:

             cls = line.split()

             fn = cls.pop(0)

             fn = fn + '.jpg'

             # print(os.path.join(root, fn))

             if os.path.isfile(os.path.join(root, fn)):

                 self.items.append((os.path.join(root, fn), float(cls[0])))

                 # print((os.path.join(root, fn), float(cls[0])))

             else:

                 print('what')

             c = c + 1

         print('the total image is ', c)

     def __getitem__(self, idx):

         img = image.imread(self.items[idx][0], self._flag)

         label = self.items[idx][1]

         if self._transform is not None:

             return self._transform(img, label)

         return img, label

     def __len__(self):

         return len(self.items)

 batch_size = 16

 root = '/home/ying/data2/shiyongjie/landmark_recognition/data/image'

 def random_choose_data(label_path):

     f = open(label_path)

     lines = f.readlins()

     random.shuffle(lines)

     total_number = len(lines)

     train_number = total_number/10*7

     train_list = lines[:train_number]

     test_list = lines[train_number:]

     return (train_list, test_list)

 label_path = '/home/ying/data2/shiyongjie/landmark_recognition/data/train.txt'

 train_list, test_list = random_choose_data(label_path)

 loader = gluon.data.DataLoader

 train_ds = MyImageFolderDataset(os.path.join(root, 'image'), train_list, flag=1, transform=transform_train)

 test_ds = MyImageFolderDataset(os.path.join(root, 'Testing'), test_list, flag=1, transform=transform_test)

 train_data = loader(train_ds, batch_size, shuffle=True, last_batch='keep')

 test_data = loader(test_ds, batch_size, shuffle=False, last_batch='keep')
MyImageFolderDataset是dataset.Dataset的子类,主要是是重载索引运算__getitem__,并且返回image以及其对应的label即可,前面的的_list_image函数只要是能够返回item这个list就行,关于运算符重载给自己挖个坑
可以说和pytorch非常像了,就连沐神在讲课的时候还在说,其实在写mxnet的时候,借鉴了很多pytorch的内容
mxnet自定义dataloader加载自己的数据的更多相关文章
- hive 压缩全解读(hive表存储格式以及外部表直接加载压缩格式数据);HADOOP存储数据压缩方案对比(LZO,gz,ORC)
数据做压缩和解压缩会增加CPU的开销,但可以最大程度的减少文件所需的磁盘空间和网络I/O的开销,所以最好对那些I/O密集型的作业使用数据压缩,cpu密集型,使用压缩反而会降低性能. 而hive中间结果 ...
- [原创.数据可视化系列之三]使用Ol3加载大量点数据
不管是百度地图还是高德地图,都很难得见到在地图上加载大量点要素,比如同屏1000的,因为这样客户端性能会很低,尤其是IE系列的浏览器,简直是卡的要死.但有的时候,还真的需要,比如,我要加载全球的AQI ...
- jsTree 的简单用法--异步加载和刷新数据
首先这两个文件是必须要引用的,还有就是引用 jQuery 文件就不说了: <link href="/css/plugins/jsTree/style.min.css" rel ...
- 使用getJSON()方法异步加载JSON格式数据
使用getJSON()方法异步加载JSON格式数据 使用getJSON()方法可以通过Ajax异步请求的方式,获取服务器中的数组,并对获取的数据进行解析,显示在页面中,它的调用格式为: jQuery. ...
- 异步加载回来的数据不受JS控制了
写成下面这种方式时,异步加载回来的数据不受JS控制 $(."orderdiv").click(function(){ $(this).find(".orderinfo&q ...
- echarts 图表重新加载,原来的数据依然存在图表上
问题 在做一个全国地图上一些饼图,并且向省一级的地图钻取的时候,原来的饼图依然显示 原因 echars所有添加的图表都在一个series属性集合中,并且同一个echars对象默认是合并之前的数据的,所 ...
- 实用ExtJS教程100例-010:ExtJS Form异步加载和提交数据
ExtJS Form 为我们提供了两个方法:load 和 submit,分别用来加载和提交数据,这两个方法都是异步的. 系列ExtJS教程持续更新中,点击查看>>最新ExtJS教程目录 F ...
- HTTP 筛选器 DLL C:\Windows\Microsoft.Net\Framework\v4.0.30319\aspnet_filter.dll 加载失败。数据是错误。
今天在一台win2003的云主机上,安装.net 4.0时,所有的网站都打不开了.打开事件查看器,发现以下错误: HTTP 筛选器 DLL C:\Windows\Microsoft.Net\Frame ...
- Flex 4 自定义预加载器
本示例的目的是在Flash Professional里创建自定义预加载器SWC,并扩展SparkDownloadProgressBar类在Flex 4应用程序中使用. 预加载器显示加载进度百分比 ...
随机推荐
- 使用深度学习检测TOR流量——本质上是在利用报文的时序信息、传输速率建模
from:https://www.jiqizhixin.com/articles/2018-08-11-11 可以通过分析流量包来检测TOR流量.这项分析可以在TOR 节点上进行,也可以在客户端和入口 ...
- 使用JdbcTemplate操作数据库(二十九)
使用JdbcTemplate操作数据库 Spring的JdbcTemplate是自动配置的,你可以直接使用@Autowired来注入到你自己的bean中来使用. 举例:我们在创建User表,包含属性n ...
- pytesseract 验证码识别
以下代码,如有不懂加群讨论# *-* coding:utf-8 *-* #import jsonimport requestsimport pytesseractimport timeimport d ...
- AI工具(缩放工具)(路径查找器)(旋转工具)(镜像工具)5.12
缩放工具:选择图形,点击工具栏缩放工具,”ENTER"输入缩放比例,“复制”完成缩放复制. 路径查找器:选择两个图形,“窗口”“路径查找器”“差集”:大圆减去小圆,留下圆环. “减去顶层”: ...
- 比较不错的几款开源的WPF Charts报表控件
UWP Community Toolkit 1. ModernUIChart Code: http://modernuicharts.codeplex.com/ Available Charts Co ...
- unity中把一个图片切割成两个UI图片
1.在unity3D的Project视图下选中需要更改的图片,将图片的Texture Type更改为Sprite (2D and UI),点击Apply即可.操作如图所示: 2.完成步骤一,点击App ...
- fk的使用细节
在seiman的博客fk2.3的用法笔记一文中,介绍了当震中距很大时,fk在使用时需要加上-f,这一展平变换的选项. 另外,nt*dt为最终数据的总长度,当震中距为远震范围时,such as:40°, ...
- L300 3月英语课下
重音 句中的实词(内容词)要被重读,读得重.长一点.句中的虚词(功能词)要被轻读或弱读,读得轻.短一点口语交流中,当虚词的在句中起到重要的表意作用时,会被重读. 连读 连读:把一个单词的尾音同下一个单 ...
- 2019-02-25 EST 科技文翻译
The Definition of Theme and Rheme The point of departure is equally presented to the speaker and to ...
- ESP8266 上线
1.首先配置esp8266 WIFI模块 使用USB转 TTL 连接 esp8266 WIFI模块,波特率115200 //查询固件版本 AT+GMR //设置WiFi应用模式为Station AT+ ...