
Spark2.4.0伪分布式环境搭建
一、搭建环境的前提条件
环境:ubuntu-16.04
hadoop-2.6.0
jdk1.8.0_161。
spark-2.4.0-bin-hadoop2.6。这里的环境不一定需要和我一样,基本版本差不多都ok的,但注意这里spark要和hadoop版本相对应。所需安装包和压缩包自行下载即可。
因为这里是配置spark的教程,首先必须要配置Hadoop,配置Hadoop的教程在Hadoop2.0伪分布式平台环境搭建。配置Java以及安装VMware Tools就自行百度解决哈,这里就不写了(因为教程有点长,可能有些地方有些错误,欢迎留言评论,我会在第一时间修改的)。
二、搭建的详细步骤
1、首先确保Hadoop伪分布式环境正在运行
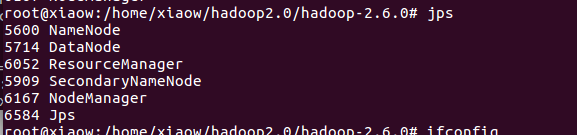
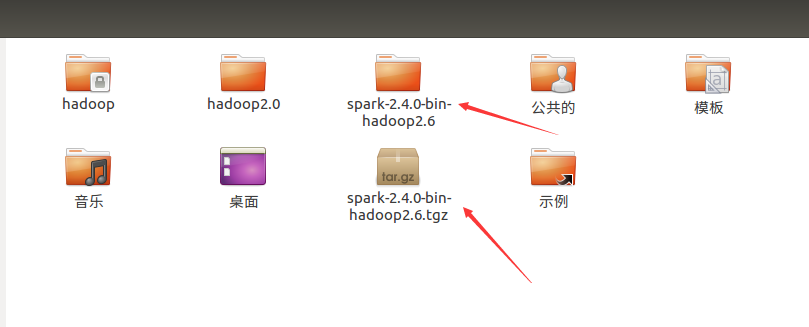
2、首先对spark安装包解压缩
tar -zxvf spark-2.4.0-bin-hadoop2.6
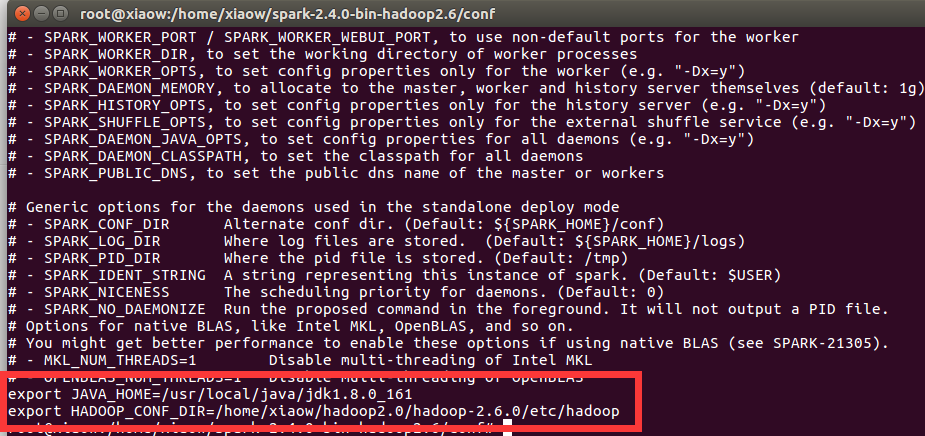
3、进入spark/conf修改配置文件
cd spark-2.4.0-bin-hadoop2.6/

cd conf/

cp spark-env.sh.template spark-env.sh
然后在spark-env.sh文件最后添加内容
vim spark-env.sh
4、配置环境变量
vim ~/.bashrc
在文件最后加入spark的路径

保存使其立即生效。
source ~/.bashrc
5、启动spark
cd ..

sbin/start-all.sh
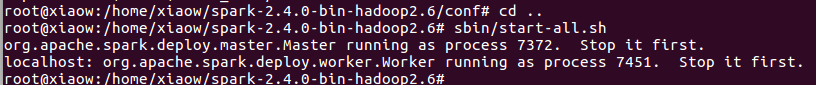
jps查看进程
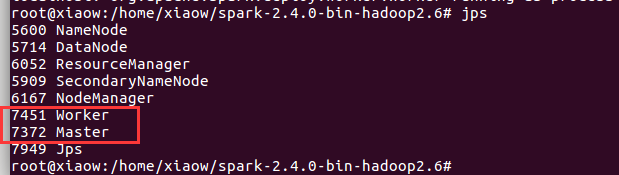
出现上面这些节点说明搭建成功。
6、webUI查看
http://localhost:8080/

7、若搭建成功的命令行界面,注意路径

退出命令为 :quit 。
Spark2.4.0伪分布式环境搭建的更多相关文章
- Hadoop2.7.3+Spark2.1.0 完全分布式环境 搭建全过程
一.修改hosts文件 在主节点,就是第一台主机的命令行下; vim /etc/hosts 我的是三台云主机: 在原文件的基础上加上; ip1 master worker0 namenode ip2 ...
- Hadoop2.5.0伪分布式环境搭建
本章主要介绍下在Linux系统下的Hadoop2.5.0伪分布式环境搭建步骤.首先要搭建Hadoop伪分布式环境,需要完成一些前置依赖工作,包括创建用户.安装JDK.关闭防火墙等. 一.创建hadoo ...
- hive-2.2.0 伪分布式环境搭建
一,实验环境: 1, ubuntu server 16.04 2, jdk,1.8 3, hadoop 2.7.4 伪分布式环境或者集群模式 4, apache-hive-2.2.0-bin.tar. ...
- 在Win7虚拟机下搭建Hadoop2.6.0伪分布式环境
近几年大数据越来越火热.由于工作需要以及个人兴趣,最近开始学习大数据相关技术.学习过程中的一些经验教训希望能通过博文沉淀下来,与网友分享讨论,作为个人备忘. 第一篇,在win7虚拟机下搭建hadoop ...
- 【Hadoop】伪分布式环境搭建、验证
Hadoop伪分布式环境搭建: 自动部署脚本: #!/bin/bash set -eux export APP_PATH=/opt/applications export APP_NAME=Ares ...
- 大数据:Hadoop(JDK安装、HDFS伪分布式环境搭建、HDFS 的shell操作)
所有的内容都来源与 Hadoop 官方文档 一.Hadoop 伪分布式安装步骤 1)JDK安装 解压:tar -zxvf jdk-7u79-linux-x64.tar.gz -C ~/app 添加到系 ...
- 【Hadoop离线基础总结】CDH版本Hadoop 伪分布式环境搭建
CDH版本Hadoop 伪分布式环境搭建 服务规划 步骤 第一步:上传压缩包并解压 cd /export/softwares/ tar -zxvf hadoop-2.6.0-cdh5.14.0.tar ...
- CentOS7下Hadoop伪分布式环境搭建
CentOS7下Hadoop伪分布式环境搭建 前期准备 1.配置hostname(可选,了解) 在CentOS中,有三种定义的主机名:静态的(static),瞬态的(transient),和灵活的(p ...
- HDFS 伪分布式环境搭建
HDFS 伪分布式环境搭建 作者:Grey 原文地址: 博客园:HDFS 伪分布式环境搭建 CSDN:HDFS 伪分布式环境搭建 相关软件版本 Hadoop 2.6.5 CentOS 7 Oracle ...
随机推荐
- 用尽洪荒之力学习Flask源码
WSGIapp.run()werkzeug@app.route('/')ContextLocalLocalStackLocalProxyContext CreateStack pushStack po ...
- SOFA 源码分析 — 链路数据透传
前言 SOFA-RPC 支持数据链路透传功能,官方解释: 链路数据透传功能支持应用向调用上下文中存放数据,达到整个链路上的应用都可以操作该数据. 使用方式如下,可分别向链路的 request 和 re ...
- 常用的几个在线生成网址二维码的API接口
原创,转载请注明出处! 用接口的好处就是简单,方便,时时更新,二维码生成以后不用保存在本项目服务器上面,可以减少不必要的开支,无需下载安装什么软件,可简单方便地引用,这才是最便捷的免费网址二维码生成 ...
- Solr(六)Solr索引数据存放到HDFS下
Solr索引数据存放到HDFS下 一 新建solr core hdfs 方法:http://www.cnblogs.com/Matchman/p/7287385.html 二 修改solrconfig ...
- Qt中绘制五子棋棋盘
一个需要做大作业的同学问我相关内容,就顺手写了一个,贴出来. 项目包含头文件 mainwindowh,源文件mainwindow.cpp和主函数main.cpp. 如下: mainwindow.h # ...
- Oracle12c中PL/SQL(DBMS_SQL)新特性之隐式语句结果(DBMS_SQL.RETURN_RESULT and DBMS_SQL.GET_NEXT_RESULT)
隐式数据结果特性将能简化从其他数据库到Oracle12c存储过程迁移.1. 背景T-SQL中允许查询结果的隐式返回.例如:下面T-SQL存储过程隐式返回查询结果.CREATE PROCEDURE Ge ...
- Object类的toString()方法总结
1.java语言很多地方会默认调用对象的toString方法. 注:如果不重写toString方法,将会 使用Object的toString方法,其逻辑为 类名@散列码,toString方法是非常有 ...
- PAT1036:Boys vs Girls
1036. Boys vs Girls (25) 时间限制 400 ms 内存限制 65536 kB 代码长度限制 16000 B 判题程序 Standard 作者 CHEN, Yue This ti ...
- mysql分表经验总结
一.为什么要分表? 当一张的数据达到几百万时,你查询一次所花的时间会变多,如果有联合查询的话,有可能会死在那儿了.分表的目的就在于此,减小数据库的负担,缩短查询时间.根据个人经验,mysql执行一个s ...
- SSM-SpringMVC-32:SpringMVC中灌顶传授文件上传
------------吾亦无他,唯手熟尔,谦卑若愚,好学若饥------------- 我将用自认为最简单的语言,描述Springmvc的文件上传,来将老夫毕生功力灌顶传授给你 首先文件上传,又简至 ...