
UTF-8 <==> unicode(WCHAR)
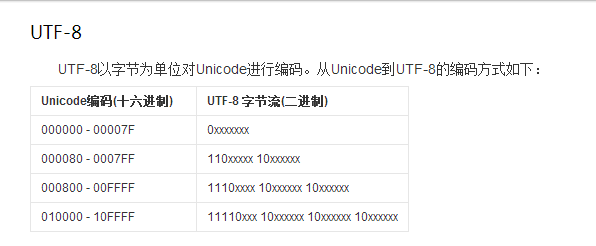
 static int fetchWordFromUTF8(const chConstStringA& strText, WCHAR& result)

 {

     int nLength = strText.length();

     if(nLength <= ) return ;

     LPCSTR lpszTextA = strText.c_ptr();

     BYTE byte = *lpszTextA;

     if ((byte >> ) == 0x00)

     {

         result = (WCHAR)(BYTE)*lpszTextA;

         return ;

     }

     else if ((byte >> ) == 0x06)

     {

         if(nLength >= )

         {

             DWORD dw0 = (DWORD)(BYTE)lpszTextA[];

             DWORD dw1 = (DWORD)(BYTE)lpszTextA[];

             result = (WCHAR)((dw1&0x3F) | ((dw0&0x1F) << ));

             return ;

         }

     }

     else if ((byte >> ) == 0x0E)

     {

         if(nLength >= )

         {

             DWORD dw0 = (DWORD)(BYTE)lpszTextA[];

             DWORD dw1 = (DWORD)(BYTE)lpszTextA[];

             DWORD dw2 = (DWORD)(BYTE)lpszTextA[];

             result = (WCHAR)((dw2&0x3F) | ((dw1&0x3F) << ) | ((dw0&0x0F)<<));

             return ;

         }

     }

     result = '?';

     return ;

 }

 static int fetchUTF8FromWord(const UINT& word, LPSTR szResult)

 {

     if (word < 0x0080)

     {

         szResult[] = (ACHAR)word;

         return ;

     }

     else if (word < 0x0800)

     {

         szResult[] = (ACHAR)(0xC0 | (BYTE)(word>>));

         szResult[] = (ACHAR)(0x80 | (BYTE)(word&0x003F));

         return ;

     }

     else// if (word <= 0xFFFF)

     {

         szResult[] = (ACHAR)(0xE0 | (BYTE)(word>>));

         szResult[] = (ACHAR)(0x80 | (BYTE)((word>>) & 0x3F));

         szResult[] = (ACHAR)(0x80 | (BYTE)(word&0x3F));

         return ;

     }

     szResult[] = '?';

     return ;

 }
UTF-8 <==> unicode(WCHAR)的更多相关文章
- Unicode 与 Unicode Transformation Format(UTF,UTF-8 / UTF-16 / UTF-32)
ASCII(American Standard Code for Information Interchange):早期它使用7 bits来表示一个字符,总共表示27 = 128个字符:后来扩展到8 ...
- Unicode和UTF的关系
目录结构: contents structure [+] 什么是USC UCS的编码方式 Unicode的来源 为什么需要Unicode Unicode的方式 Unicode和UTF UTF和Unic ...
- ASCII UNICODE UTF "口水文"
最近接了一个单是需要把非 UTF-8 (No BOM)编码的文件转换成 UTF-8 (No BOM),若此文件是 UTF-8 但带有 BOM ,需要转换成不带 BOM 的.于是开启了一天的阅读.首先花 ...
- 转:Unicode字符集和多字节字符集关系
原文地址: http://my.oschina.net/alphajay/blog/5691 unicode.ucs-2.ucs-4.utf-16.utf-32.utf-8 http://stallm ...
- Unicode字符集和多字节字符集关系
在计算机中字符通常并不是保存为图像,每个字符都是使用一个编码来表示的,而每个字符究竟使用哪个编码代表,要取决于使用哪个字符集(charset). 在最初的时候,Internet上只有一种字符集—— ...
- Unicode和多字节字符集
今天自己写的发现一个输出路径程序使用unicode字符集只能输出单个的首字符,问了一下同事,改为使用多字节字符集,问题解决了 于是上网看了他们的区别: 很多没看完,但起码了解到字符集的演变过程, 转 ...
- 【转】【编码】ASCII 、UNICODE和UTF-8之二
字符发展 1. 美国 ASCII-(American standard code information interchange) 美国信息互换标准代码 范围:1-127 ; 单字 备注:前部用作控制 ...
- 转: 带你玩转Visual Studio——带你理解多字节编码与Unicode码
上一篇文章带你玩转Visual Studio——带你跳出坑爹的Runtime Library坑帮我们理解了Windows中的各种类型C/C++运行时库及它的来龙去脉,这是C++开发中特别容易误入歧途的 ...
- Unicode、UTF-8、UTF-16和UTF-32的区别
Unicode是一个巨大的字符集,给世界上所有的字符定义了一个唯一编码.其仅仅规定了每个符号的二进制代码,没有制定细化的存储规则.UTF-8.UTF-16.UTF-32才是Unicode的存储格式定义 ...
随机推荐
- 网站tomcat配置
<?xml version='1.0' encoding='utf-8'?> <!-- Licensed to the Apache Software Foundation (ASF ...
- Apache-Maven学习(转)
之前听同学说过关于他们公司使用Maven框架来做项目管理,后来也跟他一起参与过一个小的项目,但没有仔细的去搞,现在好好学习一下. 文章转载自:易百教程 [http:/www.yiibai.com] A ...
- 【uTenux实验】中断处理
中断处理是一个比较有意思的东西.uTenux的中断处理包括了处理外部中断.CPU异常等.他是OS中任务无关部分.因此,当中断到来的时候OS会停止任务调度,不会发生任务切换.直到程序从中断中返回. uT ...
- Web Api 上传图片,解决上传图片无格式
制作这个功能时,找了很多资料,不过忘记了地址,所以就不一一放连接了, 直接上代码吧! 1. 首先新建一个上传的控制器 /// <summary> /// 上传 /// </summa ...
- python(23)re函数:compile、match、search、findall
正则表达式是一个特殊的字符序列,它能帮助你方便的检查一个字符串是否与某种模式匹配. Python 自1.5版本起增加了re 模块,它提供 Perl 风格的正则表达式模式. re 模块使 Python ...
- iOS NSNotification的使用
如果在一个类中想要执行另一个类中的方法可以使用通知 1.创建一个通知对象:使用notificationWithName:object: 或者 notificationWithName:object:u ...
- springmvc跳转和重定向
如果springmvc返回的视图中带有redirect:或者forward:,springmvc会进行特殊处理, redirect:会执行重定向,forward:会执行转发操作! @RequestMa ...
- c# webform网站图片另存代码
好辛苦生成了二维码,然后要实现点击“保存图片”,弹出选择路径进行保存的效果. look: string qrcodeurl = ""; string username = &quo ...
- 移动设备页面高度不足时min-height 的尴尬处理
移动设备页面高度不足时min-height 的尴尬处理 在做html5的页面时,经常遇到页面内容太少撑不起来整个手机屏幕的高度. 我们经常使用min-height来处理,比如min-height:56 ...
- thinkphp关联模型的注意大小写
TP框架报错: think\Model:relation方法不存在 首先检查大小写,尤其是模型名称首字母大写 /**** 模型名字QqModel.class.php ***************** ...