
对HashMap的理解(二):高并发下的HashMap
在分析hashmap高并发场景之前,我们要先搞清楚ReHash这个概念。ReHash是HashMap在扩容时的一个步骤。
HashMap的容量是有限的。当经过多次元素插入,使得HashMap达到一定饱和度时,Key映射位置发生冲突的几率会逐渐提高。这时候,HashMap需要扩展它的长度,也就是进行Resize。
影响发生Resize的因素有两个:
1.Capacity:HashMap的当前长度。上一篇曾经说过,HashMap的长度是2的幂。
2.LoadFactor:HashMap负载因子,默认值为0.75f。
衡量HashMap是否进行Resize的条件如下:
HashMap.Size >= Capacity * LoadFactor
Resize的两个步骤:
1.扩容
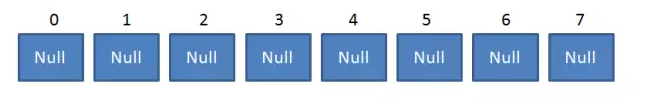
创建一个新的Entry空数组,长度是原数组的2倍。
2.ReHash
遍历原Entry数组,把所有的Entry重新Hash到新数组。为什么要重新Hash呢?因为长度扩大以后,Hash的规则也随之改变。
让我们回顾一下Hash公式:
index = HashCode(Key) & (Length - 1)
当原数组长度为8时,Hash运算是和111B做与运算;新数组长度为16,Hash运算是和1111B做与运算。Hash结果显然不同。
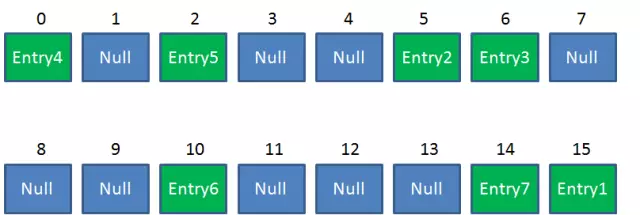
Resize前的HashMap:

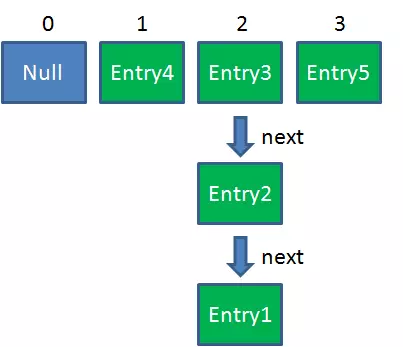
Resize后的HashMap:
ReHash的Java代码如下:
 /**

  * Transfers all entries from current table to newTable.

  */

 void transfer(Entry[] newTable, boolean rehash) {

     int newCapacity = newTable.length;

     for (Entry<K,V> e : table) {

         while(null != e) {

             Entry<K,V> next = e.next;

             if (rehash) {

                 e.hash = null == e.key ? 0 : hash(e.key);

             }

             int i = indexFor(e.hash, newCapacity);

             e.next = newTable[i];

             newTable[i] = e;

             e = next;

         }

     }

 }
上述流程在单线程下执行是没有问题的,但在多线程下,HashMap并非线程安全的。下面在演示在多线程环境下,HashMap的ReHash操作可能带来什么样的问题之前,先说明在单线程下的执行情况。
在说明之前,先将ReHash的代码分为如下三部分:
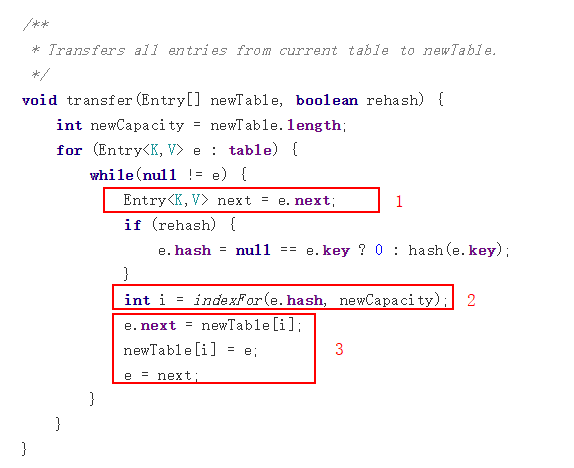
(一)、单线程的情况下:
假设一个HashMap已经到了Resize的临界点:
1. 扩容
2. ReHash
首先遍历Entry4对象:e = Entry4

第8行:next = e.next; => next = null; //此时:e = Entry4, next = null

第12行:假设i = 1;

第13-15行:e.next = newTable[1]; => e.next = null;

          newTable[1] = e; => newTable[1] = Entry4;

          e = next; => e = null;  //此时:e = null, next = null

Entry4放入newTable[1]的位置,结束while循环。开始遍历下一个对象:e = Entry3

第8行:next = e.next; => next = Entry2; //此时:e = Entry3, next = Entry2

第12行:假设i = 3;

第13-15行:e.next = newTable[3]; => e.next = null;  //要插入的结点的next指向newTable[i]

          newTable[3] = e; => newTable[3] = Entry3; //要插入的结点放在newTable[i]处

          e = next; => e = Entry2; //此时:e = Entry2, next = Entry2

Entry3放入newTable[3]的位置,继续while循环,开始遍历下一个对象:e = Entry2

第8行:next = e.next; => next = Entry1; //此时:e = Entry2, next = Entry1

第12行:假设i = 3;

第13-15行:e.next = newTable[3]; => e.next = Entry3;

          newTable[3] = e; => newTable[3] = Entry2;

          e = next; => e = Entry1; //此时:e = Entry1, next = Entry1

Entry2放入newTable[3]的位置,且Entry2.next = Entry3,继续while循环,开始遍历下一个对象:e = Entry1

.....
(二)、多线程的情况下:
1. 假设一个HashMap已经到了Resize的临界点:
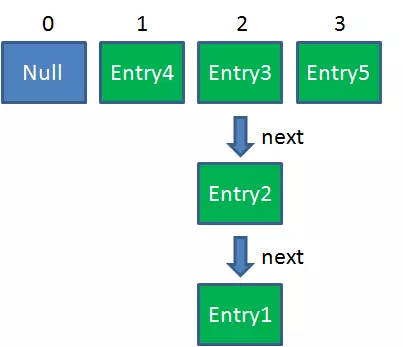
2. 此时有两个线程A和B,在同一时刻对HashMap进行Put操作:
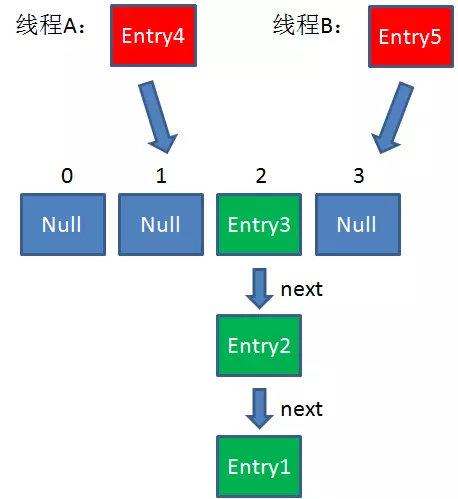
3. 此时达到Resize条件,两个线程各自进行Rezie的第一步,也就是扩容:
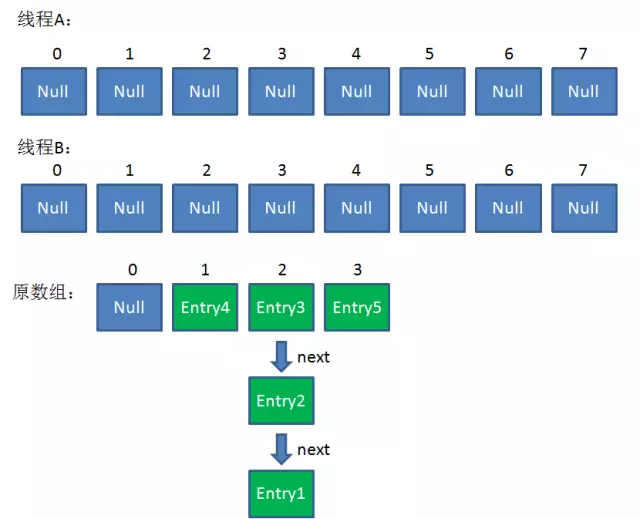
4. 这时候,两个线程都走到了ReHash的步骤。
假如此时线程B遍历到Entry3对象,刚执行完第8行代码,线程就被挂起。对于线程B来说:
e = Entry3

next = Entry2
这时候线程A畅通无阻地进行着Rehash,当ReHash完成后,结果如下(图中的e和next,代表线程B的两个引用):
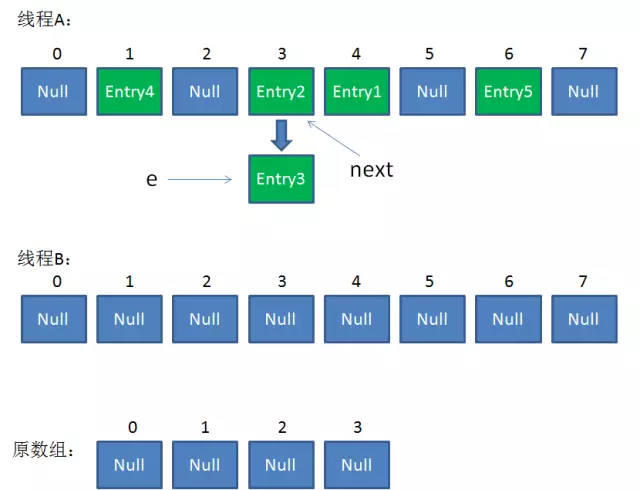
直到这一步,看起来没什么毛病。
5. 接下来线程B恢复,继续执行属于它自己的ReHash。(e = Entry3, next = Entry2)
//线程B继续执行

第12行:i = 3 //因为刚才线程A对于Entry3的hash结果也是3

第13-15行:e.next = newTable[3]; => e.next = null;

          newTable[3] = e; => newTable[3] = Entry3;

          e = next; => e = Entry2; //此时:e = Entry2, next = Entry2

Entry3放入线程B中newTable[3]的位置,继续while循环,开始遍历下一个对象:e = Entry2
整体情况如下:(线程A中e和next都指向Entry2,线程B只有Entry3)
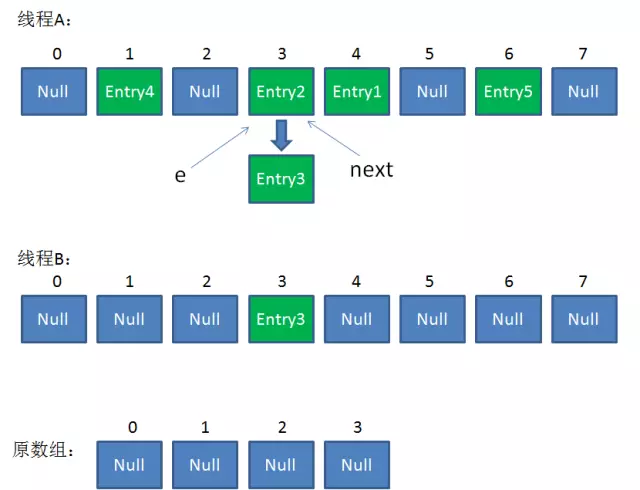
6. 继续执行:
//继续while循环

第8行:next = e.next; => next = Entry3; //此时:e = Entry2, next = Entry3

第12行:i = 3;

第13-15行:e.next = newTable[3]; => e.next = Entry3;

          newTable[3] = e; => newTable[3] = Entry2;

          e = next; => e = Entry3; //此时:e = Entry3, next = Entry3

Entry2放入newTable[3]的位置,且Entry2.next = Entry3,继续while循环,开始遍历下一个对象:e = Entry3
整体情况如下:(线程A中e和next都指向Entry3,线程B有Entry2和Entry3)
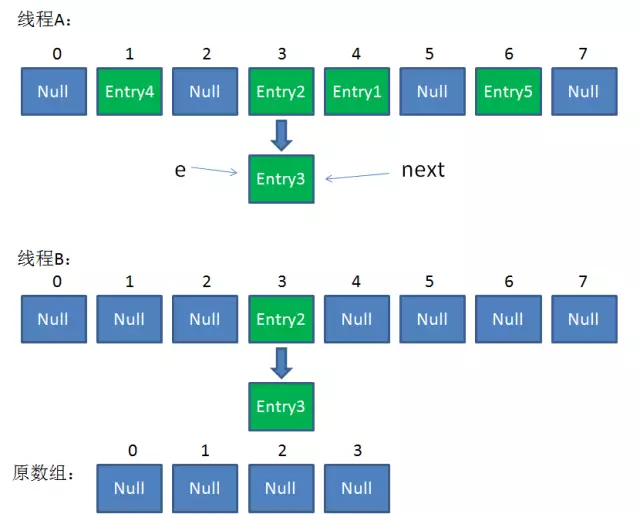
7. 继续执行:
//继续while循环

第8行:next = e.next; => next = null; //此时:e = Entry3, next = null

第9行:i = 3;

第13-15行:e.next = newTable[i]; => e.next = Entry2;

          newTable[3] = e; => newTable[3] = Entry3;

          e = next; => e = null; //此时:e = null, next = null

Entry3放入newTable[3]的位置,且Entry3.next = Entry2,结束while循环。
整体情况如下:(链表出现了环形)

此时,问题还没有直接产生。当调用Get查找一个不存在的Key,而这个Key的Hash结果恰好等于3的时候,由于位置3带有环形链表,所以程序将会进入死循环!
总结:
1.Hashmap在插入元素过多的时候需要进行Resize,Resize的条件是
HashMap.Size >= Capacity * LoadFactor。
2.Hashmap的Resize包含扩容和ReHash两个步骤,ReHash在并发的情况下可能会形成链表环。
来自公众号:

对HashMap的理解(二):高并发下的HashMap的更多相关文章
- JDK1.7 ConcurrentHashMap--解决高并发下的HashMap使用问题
高并发下也可以使用HashTable .Collections.synchronizedMap因为他们是线程安全的,但是却牺牲了性能,无论是读操作.写操作都是给整个集合加锁,导致同一时间内其他操作均为 ...
- JDK1.7 高并发下的HashMap
HashMap的容量是有限的.当经过多次元素插入,使得HashMap达到一定饱和度时,Key映射位置发生冲突的几率会逐渐提高. 这时候,HashMap需要扩展它的长度,也就是进行Resize. 影响发 ...
- 漫画:高并发下的HashMap
这一期我们来讲解高并发环境下,HashMap可能出现的致命问题. HashMap的容量是有限的.当经过多次元素插入,使得HashMap达到一定饱和度时,Key映射位置发生冲突的几率会逐渐提高. 这时候 ...
- 高并发下,HashMap会产生哪些问题?
HashMap在高并发环境下会产生的问题 HashMap其实并不是线程安全的,在高并发的情况下,会产生并发引起的问题: 比如: HashMap死循环,造成CPU100%负载 触发fail-fast 下 ...
- 高并发下的HashMap,ConcurrentHashMap
参照: http://mp.weixin.qq.com/s/dzNq50zBQ4iDrOAhM4a70A http://mp.weixin.qq.com/s/1yWSfdz0j-PprGkDgOomh ...
- 高并发下的Java数据结构(List、Set、Map、Queue)
由于并行程序与串行程序的不同特点,适用于串行程序的一些数据结构可能无法直接在并发环境下正常工作,这是因为这些数据结构不是线程安全的.本节将着重介绍一些可以用于多线程环境的数据结构,如并发List.并发 ...
- HashMap 在高并发下引起的死循环
HashMap 基本实现(JDK 8 之前) HashMap 通常会用一个指针数组(假设为 table[])来做分散所有的 key,当一个 key 被加入时,会通过 Hash 算法通过 key 算出这 ...
- HashMap高并发下存在的问题
原文链接:https://blog.csdn.net/bjwfm2011/article/details/81076736 1.什么是HashMap? HashMap底层原理 HashMap是存储键值 ...
- Java高并发下多线程编程
1.创建线程 Java中创建线程主要有三种方式: 继承Thread类创建线程类: 定义Thread类的子类,并重写该类的run方法,该run方法的方法体就代表了线程要完成的任务.因此也把run方法称为 ...
随机推荐
- POJ--3279(开关问题2个不同时间写的代码)
Fliptile Time Limit: 2000MS Memory Limit: 65536K Total Submissions: 19730 Accepted: 7118 Descrip ...
- 文本编辑器 vi/vim 的使用
文本编辑器 vi/vim 一.启动与退出 1. vim 2. vim 文件名(可以是存在的文件,也可以是不在的文件) 3.退出 :q 或者:x 在非“插入”模式二.vi/vim的工作模式 1.正常 ...
- Tomcat源码学习(3)—— Digester介绍
Digester方法详解: 通读Digester之前先分析下他的结构: 1.1该类继承了方法DefaultHandler2,DefaultHandler2继承了DefaultHandler是和sax解 ...
- SQL ser 进行表中的插入操作时,变量字段名,导致报错时解决办法 :动态SQL
标题不能描述的很清楚,下面具体说所我要描述的问题,和解决的办法. 作为SQL小白一枚,近日在写一段代码,代码如下: 报错显示 变量@vv附近错误. 后来经过了解,原来是因为,这样需要使用 动态SQL去 ...
- Python交互数据库(Mysql | Mongodb | Redis)
数据库 Mysql Mysql MySQL是一个关系型数据库管理系统,由瑞典MySQL AB公司开发,后来被Sun公司收购,Sun公司后来又被Oracle公司收购,目前属于Oracle旗下产品 MyS ...
- python正则表达式,以及应用[下载图片]
regular expresion由一系列特定字符及其组合成的字符串,用来对目标字符串进行过滤操作.. re相关知识点 python正则表达式库为re,用import re导入,在然后用re.comp ...
- Visual Studio AI 离线模型训练(window 7)
本篇博客用tensorflow训练自带的数据mnist,参考自博客. 背景: 搭建好AI环境:查看 window 7 64位 准备工作: 在搭建AI环境过程中下载的samples-for-ai不是最新 ...
- [BUAA软工]第零次博客作业---问题回答
[BUAA软工]第0次博客作业 项目 内容 这个作业属于哪个课程 北航软工 这个作业的要求在哪里 第0次个人作业 我在这个课程的目标是 学习如何以团队的形式开发软件,提升个人软件开发能力 这个作业在哪 ...
- 第三次实验报告 敏捷开发与XP实践
一. 实验内容 (一)敏捷开发与XP 摘要:一项实践在XP环境中成功使用的依据通过XP的法则呈现,包括:快速反馈.假设简单性.递增更改.提倡更改.优质工作.XP软件开发的基石是XP的活动,包括:编码 ...
- 针对网站的UI分析
PM对项目所有功能的把握,特别是UI 最差的UI,体现了团队的组织架构.其次,体现了产品的内部结构.最好,体现了用户的自然需求. 对于几种浏览器分别进行UI分析, (1)360的界面如今看来比较大众化 ...