
[]转帖] 浅谈Linux下的五种I/O模型
浅谈Linux下的五种I/O模型
https://www.cnblogs.com/chy2055/p/5220793.html
一、关于I/O模型的引出
我们都知道,为了OS的安全性等的考虑,进程是无法直接操作I/O设备的,其必须通过系统调用请求内核来协助完成I/O动作,而内核会为每个I/O设备维护一个buffer。如下图所示:
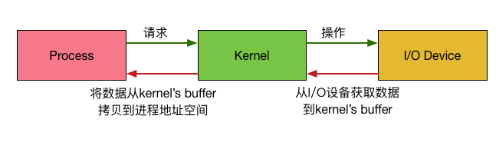
整个请求过程为: 用户进程发起请求,内核接受到请求后,从I/O设备中获取数据到buffer中,再将buffer中的数据copy到用户进程的地址空间,该用户进程获取到数据后再响应客户端。
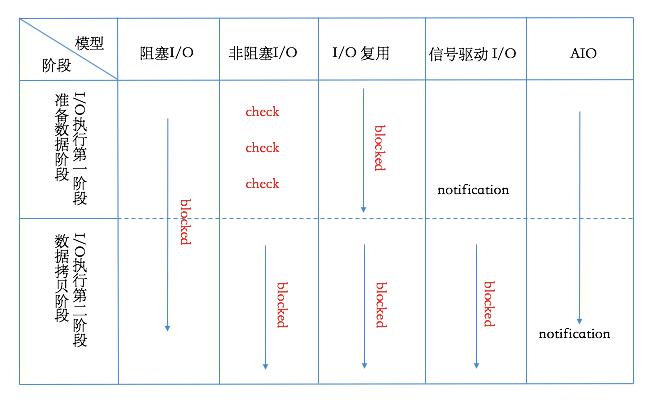
在整个请求过程中,数据输入至buffer需要时间,而从buffer复制数据至进程也需要时间。因此根据在这两段时间内等待方式的不同,I/O动作可以分为以下五种模式:
(1) 阻塞I/O (Blocking I/O)
(2) 非阻塞I/O (Non-Blocking I/O)
(3) I/O复用(I/O Multiplexing)
(4) 信号驱动的I/O (Signal Driven I/O)
(5) 异步I/O (Asynchrnous I/O)
二、关于I/O模型的划分
阻塞:调用的进程一直处于等待状态,直到操作完成。
非阻塞:在内核的数据还未准备好时,会立即返回,进程可以去干其他事情。
从同步异步,以及阻塞、非阻塞两个维度来划分来看:

三、I/O模型分述
1、阻塞I/O
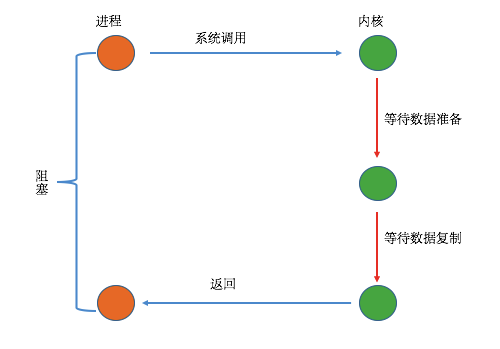
从上图可以看到在整个过程中,当用户进程进行系统调用时,内核就开始了I/O的第一个阶段,准备数据到缓冲区中,当数据都准备完成后,则将数据从内核缓冲区中拷贝到用户进程的内存中,这时用户进程才解除block的状态重新运行。
所以,Blocking I/O的特点就是在I/O执行的两个阶段都被block了。
2、非阻塞I/O

从上图可以看到在I/O执行的两个阶段中,用户进程只有在第二个阶段被阻塞了,而第一个阶段没有阻塞,但是在第一个阶段中,用户进程需要盲等,不停的去轮询内核,看数据是否准备好了,因此该模型是比较消耗CPU的。
3、I/O复用

从上图可以看到在I/O复用模型中,I/O执行的两个阶段都是用户进程都是阻塞的,但是两个阶段是独立的,在一次完整的I/O操作中,该用户进程是发起了两次系统调用。
4、信号驱动的I/O
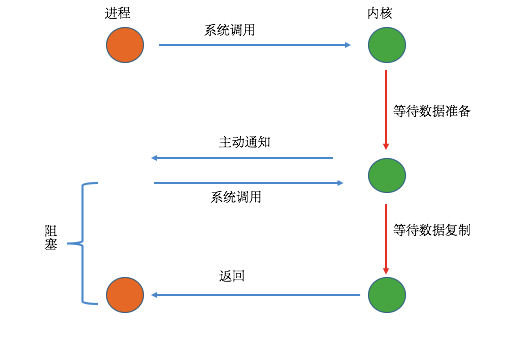
该模型也叫作基于事件驱动的I/O模型,可以看到该模型中,只有在I/O执行的第二阶段阻塞了用户进程,而在第一阶段是没有阻塞的。
乍看起来感觉和非阻塞模型很相似,其实不同之处就在于,该模型在I/O执行的第一阶段,当数据准备完成之后,会主动的通知用户进程数据已经准备完成,即对用户进程做一个回调。该通知分为两种,一为水平触发,即如果用户进程不响应则会一直发送通知,二为边缘触发,即只通知一次。
5、异步I/O

在该模型中,当用户进程发起系统调用后,立刻就可以开始去做其它的事情,然后直到I/O执行的两个阶段都完成之后,内核会给用户进程发送通知,告诉用户进程操作已经完成了。
四、五种模型总结
[]转帖] 浅谈Linux下的五种I/O模型的更多相关文章
- 浅谈Linux下的五种I/O模型 两篇别人的博客
http://blog.csdn.net/sinat_34990639/article/details/52778562 http://www.cnblogs.com/chy2055/p/5220 ...
- 浅谈Linux下的五种I/O模型
一.关于I/O模型的引出 我们都知道,为了OS的安全性等的考虑,进程是无法直接操作I/O设备的,其必须通过系统调用请求内核来协助完成I/O动作,而内核会为每个I/O设备维护一个buffer.如下图所 ...
- Linux下的五种I/O模型
堵塞I/O(blocking I/O) 非堵塞I/O (nonblocking I/O) I/O复用(select 和poll) (I/O multiplexing) 信号驱动I/O (signal ...
- Linux下的5种I/O模型(转)
Linux下的五种I/O模型: l 阻塞I/O l 非阻塞I/O l I/O复用(select.poll.epoll) l 信号驱动I/ ...
- Linux下的5种I/O模型与3组I/O复用
引言 上一篇文章中介绍了一些无缓冲文件I/O函数,但应该什么时机调用这些函数,调用这些I/O函数时进程和内核的行为如何,如何高效率地实现I/O?这篇文章就来谈一谈Linux下的5种I/O模型,以及高性 ...
- 浅谈Linux下/etc/passwd文件
浅谈Linux 下/etc/passwd文件 看过了很多渗透测试的文章,发现在很多文章中都会有/etc/passwd这个文件,那么,这个文件中到底有些什么内容呢?下面我们来详细的介绍一下. 在Linu ...
- Linux 下的五种 IO 模型
概念说明 用户空间与内核空间 现在操作系统都是采用虚拟存储器,那么对32位操作系统而言,它的寻址空间(虚拟存储空间)为4G(2的32次方).操作系统的核心是内核,独立于普通的应用程序,可以访问受保护的 ...
- 浅谈Linux下如何修改IP
linux 下命令之浅谈//cd .. //返回上一级//创建文件夹touch test.txt//Linux不区分大小写//往一个文件中追加内容echo "****" > ...
- 浅谈Linux下CPU利用率和CPU负载【转】
转自:https://blog.csdn.net/Alisa_xf/article/details/71430406 在Linux/Unix下,CPU利用率(CPU utilization)分为用户态 ...
随机推荐
- jquery $("[id$='d']").val();这句话什么意思?
获得id后缀为d字符的值.应该是属于input标签.谢谢 匹配给定的属性是以某些值结尾的元素,比如<span id="ad">test</span>< ...
- MP实战系列(二)之集成swagger
其实与spring+springmvc+mybatis集成swagger没什么区别,只是之前写的太不好了,所以这次决定详细写. 提到swagger不得不提rest,rest是一种架构风格,里面有对不同 ...
- sparse 稀疏函数的用法
sparse函数 功能:创建稀疏矩阵 用法1:S=sparse(X)—将矩阵X转化为稀疏矩阵的形式,即矩阵X中任何零元素去除,非零元素及其下标(索引)组成矩阵S. 如果X本身是稀疏的,sparse(X ...
- python基础学习第五天
li=[1,2,33,-1,'dbssd',[4,5,6],{4:'rfw',5:'re'}]del(li[1])print(li)print(type(li))#访问元素print(li[0])pr ...
- ASP 基础二 内置对象
一 Request 二 Response 三 Application 四 Session 五 Server <script language="vbscript" runat ...
- React-使用redux-immutable统一数据格式
在header的reducer.js里把header变成immutable对象之后,在组件里获取focused属性就得这样获取: focused:state.header.get('focused') ...
- RabbmitMQ-Publish/Subscribe
之前的学习中,我们了解的工作队列实现的是:一个消息只发送到一个消费者. 现在我们来学习一下新模式:发布/订阅模式 之前我们在原理中介绍了exchange,但好像并没有使用.而是直接往队列里发消息和取消 ...
- Html页面雪花效果的实现
简单介绍 昨天修改了一下博客所用的模板,冬天来了,给自己的博客加点雪花,感觉更有意境. 百度找到了非常多的结果,最终还是选用了cfs.snow.js,很赞压缩之后只有1kb左右,而且不会影响页面使用, ...
- R实战 第十篇:列联表和频数表
列联表是观测数据按两个或更多属性(定性变量)分类时所列出的频数分布表,它是由两个以上的变量进行交叉分类的频数分布表.交互分类的目的是将两变量分组,然后比较各组的分布状况,以寻找变量间的关系. 按两个变 ...
- MVC使用Redis实现分布式锁
使用场景 在做Web项目的时候,有很多特殊的场景要使用到锁 比如说抢红包,资源分配,订单支付等场景 就拿抢红包来说,如果一个红包有5份,同时100个人抢如果没有用到锁的话 100个人同时并发都抢成功, ...