
Apache Spark 2.2中基于成本的优化器(CBO)(转载)
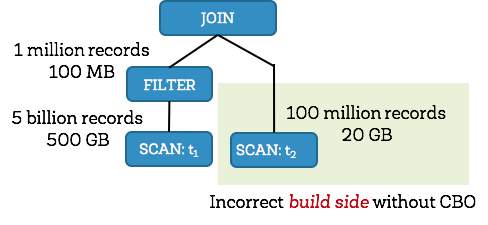
一个启发性的例子
统计信息收集框架
ANALYZE TABLE 命令
ANALYZE TABLE table_name COMPUTE STATISTICS
上面的 SQL 语句可以收集表级的统计信息,例如记录数、表大小(单位是byte)。这里需要注意的是ANALYZE, COMPUTE, and STATISTICS都是保留的关键字,他们已特定的列名为入参,在metastore中保存表级的统计信息。
ANALYZE TABLE table_name COMPUTE STATISTICS FOR COLUMNS column-name1, column-name2, ….
需要注意的是在ANALYZE 语句中没必要指定表的每个列-只要指定那些在过滤/join条件或group by等中涉及的列
统计信息类型

过滤选择
- 对于逻辑表达式AND,他的过滤选择是左条件的选择乘以右条件选择,例如fs(a AND b) = fs(a) * fs (b)。
- 对于逻辑表达式OR,他的过滤选择是左条件的选择加上右条件选择并减去左条件中逻辑表达式AND的选择,例如 fs (a OR b) = fs (a) + fs (b) - fs (a AND b) = fs (a) + fs (b) – (fs (a) * fs (b))
- 对于逻辑表达式NOT,他的过滤因子是1.0 减去原表达式的选择,例如 fs (NOT a) = 1.0 - fs (a)
- 等于操作符 (=) :我们检查条件中的字符串常量值是否落在列的当前最小值和最大值的区间内 。这步是必要的,因为如果先使用之前的条件可能会导致区间改变。如果常量值落在区间外,那么过滤选择就是 0.0。否则,就是去重后值的反转(注意:不包含额外的柱状图信息,我们仅仅估计列值的统一分布)。后面发布的版本将会均衡柱状图来优化估计的准确性。
- 小于操作符 (<) :检查条件中的字符串常量值落在哪个区间。如果比当前列值的最小值还小,那么过滤选择就是 0.0(如果大于最大值,选择即为1.0)。否则,我们基于可用的信息计算过滤因子。如果没有柱状图,就传播并把过滤选择设置为: (常量值– 最小值) / (最大值 – 最小值)。另外,如果有柱状图,在计算过滤选择时就会加上在当前列最小值和常量值之间的柱状图桶密度 。同时,注意在条件右边的常量值此时变成了该列的最大值。
Join基数
- 左外连接(Left-Outer Join): num(A LOJ B) = max(num(A IJ B),num(A)) 是指内连接输出基和左外连接端A的基之间较大的值。这是因为我们需要把外端的每条纪录计入,虽然他们没有出现在join输出纪录内。
- Right-Outer Join: num(A ROJ B) = max(num(A IJ B),num(B))
- Full-Outer Join: num(A FOJ B) = num(A LOJ B) + num(A ROJ B) - num(A IJ B)
最优计划选择
查询的性能测试和分析
配置及方法学
 SELECT

  i_item_id,

  i_item_desc,

  s_store_id,

  s_store_name,

  sum(ss_net_profit) AS store_sales_profit,

  sum(sr_net_loss) AS store_returns_loss,

  sum(cs_net_profit) AS catalog_sales_profit

 FROM

  store_sales, store_returns, catalog_sales, date_dim d1, date_dim d2, date_dim d3,

  store, item

 WHERE

  d1.d_moy = 4

    AND d1.d_year = 2001

    AND d1.d_date_sk = ss_sold_date_sk

    AND i_item_sk = ss_item_sk

    AND s_store_sk = ss_store_sk

    AND ss_customer_sk = sr_customer_sk

    AND ss_item_sk = sr_item_sk

    AND ss_ticket_number = sr_ticket_number

    AND sr_returned_date_sk = d2.d_date_sk

    AND d2.d_moy BETWEEN 4 AND 10

    AND d2.d_year = 2001

    AND sr_customer_sk = cs_bill_customer_sk

    AND sr_item_sk = cs_item_sk

    AND cs_sold_date_sk = d3.d_date_sk

    AND d3.d_moy BETWEEN 4 AND 10

    AND d3.d_year = 2001

 GROUP BY

  i_item_id, i_item_desc, s_store_id, s_store_name

 ORDER BY

  i_item_id, i_item_desc, s_store_id, s_store_name

 LIMIT 100
没使用CBO的Q25
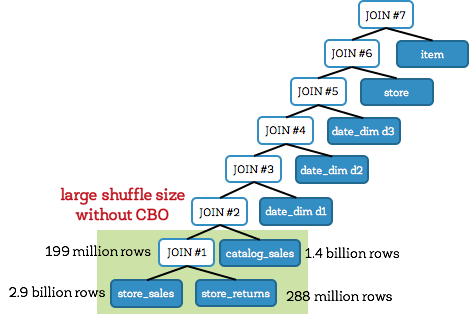
使用了CBO的Q25

TPC-DS 查询性能


结论
延伸阅读
- 原理就是较小的关系更容易放到内存
- <=> 表示‘安全的空值相等’ ,如果两边的结果都是null就返回true,如果只有一边是null就返回false
- P. Griffiths Selinger, M. M. Astrahan, D. D. Chamberlin, R. A. Lorie, T. G. Price, “Access Path Selection in a Relational Database Management System”, Proceedings of ACM SIGMOD conference, 1979
- weight(权值)是调优参数,可以通过配置 spark.sql.cbo.joinReorder.card.weight (默认是0.7)
转载自 http://www.aboutyun.com/thread-22746-1-1.html
英文博客地址 https://databricks.com/blog/2017/08/31/cost-based-optimizer-in-apache-spark-2-2.html
Apache Spark 2.2中基于成本的优化器(CBO)(转载)的更多相关文章
- CBO 基于成本的优化器[基础]
转载:CBO基于成本的优化器 ----------------------------------2013/10/02 CBO基于成本的优化器:让oracle获取所有执行计划的相关信息,通过对这些信息 ...
- 如果Apache Spark集群中没有分布式系统,则会?
若当连接到Spark的master之后,若集群中没有分布式文件系统,Spark会在集群中每一台机器上加载数据,所以要确保Spark集群中每个节点上都有完整数据. 通常可以选择把数据放到HDFS.S3或 ...
- Introducing Apache Spark Datasets(中英双语)
文章标题 Introducing Apache Spark Datasets 作者介绍 Michael Armbrust, Wenchen Fan, Reynold Xin and Matei Zah ...
- Apache Spark on K8s的安全性和性能优化
前言 Apache Spark是目前最为流行的大数据计算框架,与Hadoop相比,它是替换MapReduce组件的不二选择,越来越多的企业正在从传统的MapReduce作业调度迁移到Spark上来,S ...
- MySQL 并行复制演进及 MySQL 8.0 中基于 WriteSet 的优化
MySQL 8.0 可以说是MySQL发展历史上里程碑式的一个版本,包括了多个重大更新,目前 Generally Available 版本已经已经发布,正式版本即将发布,在此将介绍8.0版本中引入的一 ...
- Apache Spark 2.2.0 中文文档
Apache Spark 2.2.0 中文文档 - 快速入门 | ApacheCN Geekhoo 关注 2017.09.20 13:55* 字数 2062 阅读 13评论 0喜欢 1 快速入门 使用 ...
- Apache Spark 2.2.0 中文文档 - Spark SQL, DataFrames and Datasets Guide | ApacheCN
Spark SQL, DataFrames and Datasets Guide Overview SQL Datasets and DataFrames 开始入门 起始点: SparkSession ...
- A Tale of Three Apache Spark APIs: RDDs, DataFrames, and Datasets(中英双语)
文章标题 A Tale of Three Apache Spark APIs: RDDs, DataFrames, and Datasets 且谈Apache Spark的API三剑客:RDD.Dat ...
- Apache Spark 2.2.0 中文文档 - Spark SQL, DataFrames and Datasets
Spark SQL, DataFrames and Datasets Guide Overview SQL Datasets and DataFrames 开始入门 起始点: SparkSession ...
随机推荐
- Unable to load DLL 'SQLite.Interop.dll': The specified module could not be found. (Exception from HRESULT: 0x8007007E)
在主工程(ASP.NET WEB/WCF等)的NuGet里引用 System.Data.SQLite.Core 不仅仅是Service需要引用,主工程即使不直接使用SQLite的库,也需要引用. 若使 ...
- Ubuntu18.04 更换源
在虚拟机新建一个Ubuntu18.04.1-live-server-amd64当做服务器 在安装软件时报错: slave@slave:~$ sudo -s[sudo] password for sla ...
- Python基础知识:字符串
1.Python中大写字母命名的变量,默认为常量,不可修改:列如:MYSQL_CONNECTION = '192.168.1.1' 2.字符串换行输入格式:换行用\隔开,两行分别用引号,制表符\t,换 ...
- MATLAB三维作图——隐函数
MATLAB三维作图——隐函数 作者:凯鲁嘎吉 - 博客园http://www.cnblogs.com/kailugaji/ 对于三维隐函数,没有显式表达式,无法通过Matlab现成的3-D画图函数 ...
- 在CDS(Core Data Services)中使用DCL(Data Control Language)
最近,我在玩ABAP CDS视图,并且遇到了一些权限方面的挑战.我在网上没看到有多少有关CDS开发的文档,因为它是个相当新的东西.因此,我决定写下这篇博客,也许我的想法可以帮助到一些人. 和你已经意识 ...
- 使用CefSharp跳转页面不弹出页面:
using CefSharp; using CefSharp.Wpf; namespace Common.Control { internal class CefSharpOpenPageSelf : ...
- 解决Could not load file or assembly CefSharp.Core.dll的问题
这个问题的中文提示是: 未能加载文件或程序集“CefSharp.Core.dll”或它的某一个依赖项.找不到指定的模块 具体原因是因为CefSharp运行时需要Visual C++ Redistrib ...
- pThreads线程(一) 基本API
1.创建线程 int pthread_create(pthread_t *restrict_ptid, const pthread_attr_t *restrict_att ...
- Nginx SSL TLS部署最佳实践
本文介绍nginx在提供HTTPS时使用的一些其他配置选项. 虽然这些功能有助于优化nginx的SSL和TLS,但这不是一个完整对加固nginx的介绍. 确保您的服务器安全的最佳方法是不仅需要正确的配 ...
- web笔试
类型判断用到哪些方法? typeof和instanceof 值类型和引用类型的区别? 根据 JavaScript中的变量类型传递方式,又分为值类型和引用类型,在参数传递方式上,值类型是按值传递,引用类 ...