
剖析Disruptor:为什么会这么快?(二)神奇的缓存行填充
原文链接:http://mechanitis.blogspot.com/2011/07/dissecting-disruptor-why-its-so-fast_22.html 需翻墙
计算机入门
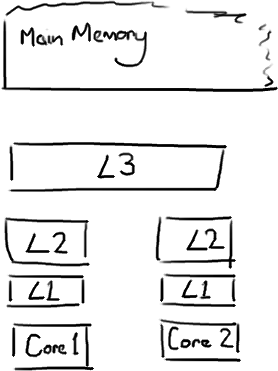
Martin 和 Mike 的 QCon presentation演讲中给出了一些缓存未命中的消耗数据:
| 从CPU到 | 大约需要的 CPU 周期 | 大约需要的时间 |
| 主存 | 约60-80纳秒 | |
| QPI 总线传输 (between sockets, not drawn) |
约20ns | |
| L3 cache | 约40-45 cycles, | 约15ns |
| L2 cache | 约10 cycles, | 约3ns |
| L1 cache | 约3-4 cycles, | 约1ns |
| 寄存器 | 1 cycle |
缓存行
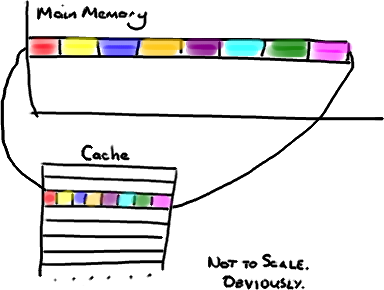
head;同时你的类中有另一个变量紧挨着它,暂时称它为tail。现在,当你加载head到缓存的时候,你也免费加载了tail。
head中保存的内容也正被消费者(译注:和生产者不在同一个内核中)消费。这两个变量并无直接联系,但需要被这两个线程使用,且这两个线程运行在不同的内核(译注:这里是指物理上的内核,即多核CPU)中。head的值。缓存中的值和内存中的值都被更新了,而其他所有存储head的缓存行都会都会失效,因为其它缓存中head不是最新值了。而我们必须以整个缓存行作为单位来处理,不能只把head标记为无效。
head你也会得到tail,而且每次你访问tail,你也会得到head。这一切都在后台发生,并且没有任何编译警告会告诉你,你正在写一个并发访问效率很低的代码。解决方案-神奇的缓存行填充
public long p1, p2, p3, p4, p5, p6, p7; // cache line padding

private volatile long cursor = INITIAL_CURSOR_VALUE;

public long p8, p9, p10, p11, p12, p13, p14; // cache line padding
(译注:前后各七位填充字段,保证cursor[1]在缓冲行中任意位置,其周围都有足够的填充字段)
Entry类中也值得这样做,如果你有不同的消费者往不同的字段写入,你需要确保各个字段间不会出现伪共享。剖析Disruptor:为什么会这么快?(二)神奇的缓存行填充的更多相关文章
- 从缓存行出发理解volatile变量、伪共享False sharing、disruptor
volatilekeyword 当变量被某个线程A改动值之后.其他线程比方B若读取此变量的话,立马能够看到原来线程A改动后的值 注:普通变量与volatile变量的差别是volatile的特殊规则保证 ...
- Spring Boot 揭秘与实战(二) 数据缓存篇 - Guava Cache
文章目录 1. Guava Cache 集成 2. 个性化配置 3. 源代码 本文,讲解 Spring Boot 如何集成 Guava Cache,实现缓存. 在阅读「Spring Boot 揭秘与实 ...
- 二、Memcached缓存穿透、缓存雪崩
二.Memcached缓存穿透.缓存雪崩 1. 缓存雪崩 可能是数据魏加载到缓存中,或者缓存同一时间大面积失效,导致大量请求去数据库查询的过程,数据库过载,崩溃. 解决方法: 1 采用加锁计数,使用合 ...
- 使用本地缓存快还是使用redis缓存好?
使用本地缓存快还是使用redis缓存好? Redis早已家喻户晓,其性能自不必多说. 但是总有些时候,我们想把性能再提升一点,想着redis是个远程服务,性能也许不够,于是想用本地缓存试试!想法是不错 ...
- 一.rest-framework之版本控制 二、Django缓存 三、跨域问题 四、drf分页器 五、响应器 六、url控制器
一.rest-framework之版本控制 1.作用 用于版本的控制 2.内置的版本控制 from rest_framework.versioning import QueryParameterVer ...
- {MySQL的库、表的详细操作}一 库操作 二 表操作 三 行操作
MySQL的库.表的详细操作 MySQL数据库 本节目录 一 库操作 二 表操作 三 行操作 一 库操作 1.创建数据库 1.1 语法 CREATE DATABASE 数据库名 charset utf ...
- Spring Boot 揭秘与实战(二) 数据缓存篇 - Redis Cache
文章目录 1. Redis Cache 集成 2. 源代码 本文,讲解 Spring Boot 如何集成 Redis Cache,实现缓存. 在阅读「Spring Boot 揭秘与实战(二) 数据缓存 ...
- Spring Boot 揭秘与实战(二) 数据缓存篇 - EhCache
文章目录 1. EhCache 集成 2. 源代码 本文,讲解 Spring Boot 如何集成 EhCache,实现缓存. 在阅读「Spring Boot 揭秘与实战(二) 数据缓存篇 - 快速入门 ...
- Spring Boot 揭秘与实战(二) 数据缓存篇 - 快速入门
文章目录 1. 声明式缓存 2. Spring Boot默认集成CacheManager 3. 默认的 ConcurrenMapCacheManager 4. 实战演练5. 扩展阅读 4.1. Mav ...
随机推荐
- bzoj1006 神奇的国度
Description K国是一个热衷三角形的国度,连人的交往也只喜欢三角原则.他们认为三角关系:即AB相互认识,BC相互认识,CA相互认识,是简洁高效的.为了巩固三角关系,K国禁止四边关系,五边关系 ...
- erlang远程加载模块须知
erlang加载本地beam到远程节点,需要把依赖库一个个手动加载,否则他不会自动加载. 另外,创建lib的话,使用 rebar-creator create-lib
- vs 引用sqlite的问题
错误 4 未能找到类型或命名空间名称“SQLiteCommand”(是否缺少 using 指令或程序集引用?) D:\01学习\SQLite\HBZCSCXT_Mobile\SqlLiteHelper ...
- [系统开发] Bind DNS 管理系统
一.问题的产生 很多公司的 DNS 是用 BIND 建立的:DNS 服务非常重要,BIND 功能虽然强大,但是是基于配置文件进行管理的,管理员对 DNS 进行的任何操作都要通过修改配置文件来实现,稍不 ...
- abstract 与 interface
接口和抽象类: 最本质的区别:抽象类是一个不完全的类,是对对象的抽象,而接口是一种行为规范. a. interface中不能有字段,abstract class则可以:b. interface可以被多 ...
- VisualStudio 调试不提示调试错误
尝试办法: 1.工具->选项->调试->启用异常助手;2.调试->异常; 解决办法: 把2.调试->异常; 下地全部钩上异常就弹出来了
- ScalaTour 2.函数
/** * 1. case class与模式匹配 */ object TestFunction extends App{ def value(expr:Expr): Int = expr match ...
- 在DataList、Repeater的HeaderTemplate和FooterTemplate模板中寻找控件FindControl
[程序代码] <asp:Repeater ID="Repeater1" runat="server"> <HeaderTemplate> ...
- PLSQL_基础系列10_子查询WITH AS(案例)
2015-05-29 Created By BaoXinjian
- CF 500 C. New Year Book Reading 贪心 简单题
New Year is coming, and Jaehyun decided to read many books during 2015, unlike this year. He has n b ...