
python 序列化之JSON和pickle详解
JSON模块
JSON(JavaScript Object Notation) 是一种轻量级的数据交换格式。它基于ECMAScript的一个子集。 JSON采用完全独立于语言的文本格式,但是也使用了类似于C语言家族的习惯(包括C、C++、Java、JavaScript、Perl、Python等)。这些特性使JSON成为理想的数据交换语言。易于人阅读和编写,同时也易于机器解析和生成(一般用于提升网络传输速率)。
JSON在python中分别由list和dict组成。
一、python类型数据和JSON数据格式互相转换
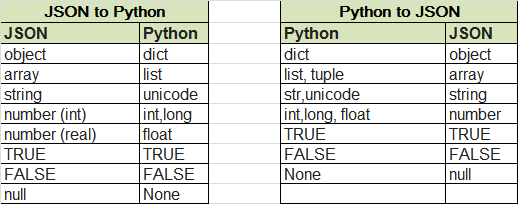
pthon 中str类型到JSON中转为unicode类型,None转为null,dict对应object
二、数据encoding和decoding
1、简单类型数据编解码
所谓简单类型就是指上表中出现的python类型。
dumps: 将对象序列化
#coding:utf-8

import json

# 简单编码===========================================

print json.dumps(['foo', {'bar': ('baz', None, 1.0, 2)}])

# ["foo", {"bar": ["baz", null, 1.0, 2]}]

#字典排序

print json.dumps({"c": 0, "b": 0, "a": 0}, sort_keys=True)

# {"a": 0, "b": 0, "c": 0}

#自定义分隔符

print json.dumps([1,2,3,{'': 5, '': 7}], sort_keys=True, separators=(',',':'))

# [1,2,3,{"4":5,"6":7}]

print json.dumps([1,2,3,{'': 5, '': 7}], sort_keys=True, separators=('/','-'))

# [1/2/3/{"4"-5/"6"-7}]

#增加缩进,增强可读性,但缩进空格会使数据变大

print json.dumps({'': 5, '': 7}, sort_keys=True,indent=2, separators=(',', ': '))

# {

#   "4": 5,

#   "6": 7

# }
# 另一个比较有用的dumps参数是skipkeys,默认为False。
# dumps方法存储dict对象时,key必须是str类型,如果出现了其他类型的话,那么会产生TypeError异常,如果开启该参数,设为True的话,会忽略这个key。
data = {'a':1,(1,2):123}
print json.dumps(data,skipkeys=True)
#{"a": 1}
dump: 将对象序列化并保存到文件
#将对象序列化并保存到文件

obj = ['foo', {'bar': ('baz', None, 1.0, 2)}]

with open(r"c:\json.txt","w+") as f:

    json.dump(obj,f)
loads: 将序列化字符串反序列化
import json

obj = ['foo', {'bar': ('baz', None, 1.0, 2)}]

a= json.dumps(obj)

print json.loads(a)

# [u'foo', {u'bar': [u'baz', None, 1.0, 2]}]
load: 将序列化字符串从文件读取并反序列化
with open(r"c:\json.txt","r") as f:

    print json.load(f)
三、自定义复杂数据类型编解码
例如我们碰到对象datetime,或者自定义的类对象等json默认不支持的数据类型时,我们就需要自定义编解码函数。有两种方法来实现自定义编解码。
1、方法一:自定义编解码函数
#! /usr/bin/env python

# -*- coding:utf-8 -*-

# __author__ = "TKQ"

import datetime,json

dt = datetime.datetime.now()

def time2str(obj):

    #python to json

    if isinstance(obj, datetime.datetime):

        json_str = {"datetime":obj.strftime("%Y-%m-%d %X")}

        return json_str

    return obj

def str2time(json_obj):

    #json to python

    if "datetime" in json_obj:

        date_str,time_str = json_obj["datetime"].split(' ')

        date = [int(x) for x in date_str.split('-')]

        time = [int(x) for x in time_str.split(':')]

        dt = datetime.datetime(date[0],date[1], date[2], time[0],time[1], time[2])

        return dt

    return json_obj

a = json.dumps(dt,default=time2str)

print a

# {"datetime": "2016-10-27 17:38:31"}

print json.loads(a,object_hook=str2time)

# 2016-10-27 17:38:31
2、方法二:继承JSONEncoder和JSONDecoder类,重写相关方法
#! /usr/bin/env python

# -*- coding:utf-8 -*-

# __author__ = "TKQ"

import datetime,json

dt = datetime.datetime.now()

dd = [dt,[1,2,3]]

class MyEncoder(json.JSONEncoder):

    def default(self,obj):

        #python to json

        if isinstance(obj, datetime.datetime):

            json_str = {"datetime":obj.strftime("%Y-%m-%d %X")}

            return json_str

        return obj

class MyDecoder(json.JSONDecoder):

    def __init__(self):

        json.JSONDecoder.__init__(self, object_hook=self.str2time)

    def str2time(self,json_obj):

        #json to python

        if "datetime" in json_obj:

            date_str,time_str = json_obj["datetime"].split(' ')

            date = [int(x) for x in date_str.split('-')]

            time = [int(x) for x in time_str.split(':')]

            dt = datetime.datetime(date[0],date[1], date[2], time[0],time[1], time[2])

            return dt

        return json_obj

# a = json.dumps(dt,default=time2str)

a =MyEncoder().encode(dd)

print a

# [{"datetime": "2016-10-27 18:14:54"}, [1, 2, 3]]

print MyDecoder().decode(a)

# [datetime.datetime(2016, 10, 27, 18, 14, 54), [1, 2, 3]]
===========================================================
pickle模块
python的pickle模块实现了python的所有数据序列和反序列化。基本上功能使用和JSON模块没有太大区别,方法也同样是dumps/dump和loads/load。cPickle是pickle模块的C语言编译版本相对速度更快。
与JSON不同的是pickle不是用于多种语言间的数据传输,它仅作为python对象的持久化或者python程序间进行互相传输对象的方法,因此它支持了python所有的数据类型。
pickle反序列化后的对象与原对象是等值的副本对象,类似与deepcopy。
dumps/dump序列化
from datetime import date

try:

    import cPickle as pickle    #python 2

except ImportError as e:

    import pickle   #python 3

src_dic = {"date":date.today(),"oth":([1,"a"],None,True,False),}

det_str = pickle.dumps(src_dic)

print det_str

# (dp1

# S'date'

# p2

# cdatetime

# date

# p3

# (S'\x07\xe0\n\x1b'

# tRp4

# sS'oth'

# p5

# ((lp6

# I1

# aS'a'

# aNI01

# I00

# tp7

# s.

with open(r"c:\pickle.txt","w") as f:

    pickle.dump(src_dic,f)
loads/load反序列化
from datetime import date

try:

    import cPickle as pickle    #python 2

except ImportError as e:

    import pickle   #python 3

src_dic = {"date":date.today(),"oth":([1,"a"],None,True,False),}

det_str = pickle.dumps(src_dic)

with open(r"c:\pickle.txt","r") as f:

    print pickle.load(f)

# {'date': datetime.date(2016, 10, 27), 'oth': ([1, 'a'], None, True, False)}
JSON和pickle模块的区别
1、JSON只能处理基本数据类型。pickle能处理所有Python的数据类型。
2、JSON用于各种语言之间的字符转换。pickle用于Python程序对象的持久化或者Python程序间对象网络传输,但不同版本的Python序列化可能还有差异。
python 序列化之JSON和pickle详解的更多相关文章
- Python序列化之json与pickle
1.json介绍 JSON(JavaScript Object Notation) 是一种轻量级的数据交换格式. 易于人阅读和编写.同时也易于机器解析和生成. 它基于JavaScript Progra ...
- python序列化模块json和pickle
序列化相关 1. json 应用场景: json模块主要用于处理json格式的数据,可以将json格式的数据转化为python的字典,便于python处理,同时也可以将python的字典或列表等对象转 ...
- 【转】Python之数据序列化(json、pickle、shelve)
[转]Python之数据序列化(json.pickle.shelve) 本节内容 前言 json模块 pickle模块 shelve模块 总结 一.前言 1. 现实需求 每种编程语言都有各自的数据类型 ...
- Python序列化,json&pickle&shelve模块
1. 序列化说明 序列化可将非字符串的数据类型的数据进行存档,如字典.列表甚至是函数等等 反序列化,将通过序列化保存的文件内容反序列化即可得到数据原本的样子,可直接使用 2. Python中常用的序列 ...
- kafka实战教程(python操作kafka),kafka配置文件详解
kafka实战教程(python操作kafka),kafka配置文件详解 应用往Kafka写数据的原因有很多:用户行为分析.日志存储.异步通信等.多样化的使用场景带来了多样化的需求:消息是否能丢失?是 ...
- python 3.x 爬虫基础---Urllib详解
python 3.x 爬虫基础 python 3.x 爬虫基础---http headers详解 python 3.x 爬虫基础---Urllib详解 前言 爬虫也了解了一段时间了希望在半个月的时间内 ...
- python+requests接口自动化测试框架实例详解
python+requests接口自动化测试框架实例详解 转自https://my.oschina.net/u/3041656/blog/820023 摘要: python + requests实 ...
- python中requests库使用方法详解
目录 python中requests库使用方法详解 官方文档 什么是Requests 安装Requests库 基本的GET请求 带参数的GET请求 解析json 添加headers 基本POST请求 ...
- Python爬虫之selenium库使用详解
Python爬虫之selenium库使用详解 本章内容如下: 什么是Selenium selenium基本使用 声明浏览器对象 访问页面 查找元素 多个元素查找 元素交互操作 交互动作 执行JavaS ...
随机推荐
- MySQL游标学习总结
游标的概念 在数据库中,游标是一个十分重要的概念.游标提供了一种对从表中检索出的数据进行操作的灵活手段,就本质而言,游标实际上是一种能从包括多条数据记录的结果集中每次提取一条记录的机制.游标总是与一条 ...
- Spring 配置文件详解 http://www.blogjava.net/hellxoul/archive/2011/11/19/364324.html
1.基本配置: <?xml version="1.0" encoding="UTF-8"?> <beans xmlns="http: ...
- 双系统下恢复Ubuntu引导菜单
引言 使用双系统的时候,我们经常重装Windows!那么有没有一种办法:只重装Windows而不重装Ubuntu呢? 在使用Win XP/Ubuntu双系统时,这个问题很好解决!但是在使用Win7(包 ...
- 使用Spring的Property文件存储测试数据 - 编写测试和调用测试数据
准备好测试数据后,我们可以开始编写测试了,在测试用例中调用我们property文件中的测试数据. 我自己写了一个TestCase作为所有测试类基类,基类中定义了两个变量来代表之前建好的两个测试数据文件 ...
- Android开发-API指南-<provider>
<provider> 英文原文:http://developer.android.com/guide/topics/manifest/provider-element.html 采集(更新 ...
- Centos7 install Openstack - (第四节)添加计算服务(Nova)
Centos7 install Openstack - (第四节)添加计算服务(Nova) 我的blog地址:http://www.cnblogs.com/caoguo 该文根据openstack官方 ...
- 记录网上资源URL
FQ(使用路由器): http://kennylee26.iteye.com/blog/1887753 http://www.iteye.com/search?type=all&query=s ...
- OS版本调研
1引言 1.1 编写目的 本文的主要目的是通过对当前项目中使用的各种版本的操作系统进行比较,分析各自特性和稳定程度,最终推荐合适的版本作为当前的标准系统. 1.2 背景 当前,部门负责管理维护的现网使 ...
- .NET的三种缓存(页面缓存,控件缓存,自定义缓存)
BLL.Area bll = new BLL.Area(); protected void Page_Load(object sender, EventArgs e) { if (Cache[&quo ...
- C# 扩展
“扩展方法使您能够向现有类型“添加”方法,而无需创建新的派生类型.重新编译或以其他方式修改原始类型.” 这是msdn上说的,也就是你可以对String,Int,DataRow,DataTable等这些 ...