
统计学习三:2.K近邻法代码实现(以最近邻法为例)
通过上文可知k近邻算法的基本原理,以及算法的具体流程,kd树的生成和搜索算法原理。本文实现了kd树的生成和搜索算法,通过对算法的具体实现,我们可以对算法原理有进一步的了解。具体代码可以在我的github上查看。
代码
#!/usr/bin/python3

# -*- coding:utf-8 -*-

import sys

import numpy as np

class Kdtree(object):

    '''

    类名: Kdtree

    用于存储kd树的数据

    成员:

    __value: 训练数据,保存数据点的坐标

     __type: 保存点对应的类型

      __dim: 保存当前kd树节点的切分平面维度

       left: 左子树

      right: 右子树

    '''

    def __init__(self, node = None, node_type = -1, dim = 0, left = None, right = None):

        self.__value = node

        self.__type  = node_type

        self.__dim   = dim

        self.left    = left

        self.right   = right

    @property

    def type(self):

        return self.__type

    @property

    def value(self):

        return self.__value

    @property

    def dim(self):

        return self.__dim

    def distance(self, node):

        '''

        计算当前节点与传入节点之间的距离

        参数:

        node: 需要计算距离的节点

        '''

        if node == None:

            return sys.maxsize

        dis = 0

        for i in range(len(self.__value)):

            dis = dis + (self.__value[i] - node.__value[i]) ** 2

        return dis

    def build_tree(self, nodes, dim = 0):

        '''

        利用训练数据建立一棵kd树

        参数: nodes: 训练数据集

                dim: 树的切分平面维度

        return: a kd-tree

        '''

        if len(nodes) == 0:

            return None

        elif len(nodes) == 1:

            self.__dim  = dim

            self.__value = nodes[0][:-1]

            self.__type  = nodes[0][-1]

            return self

        #将数据集按照第dim维度的值的大小进行排序

        sortNodes = sorted(nodes, key = lambda x:x[dim], reverse = False)

        #排序后,中间的点为当前节点值

        midNode      = sortNodes[len(sortNodes) // 2]

        sortNodes.remove(midNode)

        self.__value = midNode[:-1]

        self.__type  = midNode[-1]

        self.__dim   = dim

        leftNodes  = list(filter(lambda x: x[dim] < midNode[dim], sortNodes))

        rightNodes = list(filter(lambda x: x[dim] >= midNode[dim], sortNodes))

        nextDim    = (dim + 1) % (len(midNode) - 1)

        self.left  = Kdtree().build_tree(leftNodes, nextDim)

        self.right = Kdtree().build_tree(rightNodes, nextDim)

        return self

    def find_type(self, fnode):

        '''

        在kd树内查找传入点的最近邻点和对应的类型

        参数: fnode: 需要判断类型的点

        return: fnode的最近邻点和其类型

        '''

        if fnode == None:

            return self, -1

        fNode = Kdtree(fnode)

        #首先搜索整棵树到达叶子节点

        path = []

        currentNode = self

        while currentNode != None:

            path.append(currentNode)

            dim   = currentNode.__dim

            if fNode.value[dim] < currentNode.value[dim]:

                currentNode = currentNode.left

            else:

                currentNode = currentNode.right

        #path的最后一个节点即为叶子节点

        nearestNode = path[-1]

        nearestDist = fNode.distance(nearestNode)

        path = path[:-1]

        #向上进行回溯

        while path != None and len(path) > 0:

            currentNode = path[-1]

            path = path[:-1]

            dim  = currentNode.__dim

            #判断当前点是否比最近点更近

            if fNode.distance(currentNode) < nearestDist:

                nearestNode = currentNode

                nearestDist = fNode.distance(currentNode)

            #当前最近点一定存在于当前点的一棵子树上,那么找到它的兄弟子树的节点

            brotherNode = currentNode.left

            if fNode.value[dim] < currentNode.value[dim]:

                brotherNode = currentNode.right

            if brotherNode == None:

                continue

            #若兄弟子树的节点对应的区域与以fnode为圆心,以nearestDist为半径的圆相交,则进入兄弟子树,进行递归查找

            bdim = brotherNode.__dim

            if np.abs(fnode[bdim] - brotherNode.__value[bdim]) < nearestDist:

                cNode, _ = brotherNode.find_type(fnode)

                if fNode.distance(cNode) < nearestDist:

                    nearestDist = fNode.distance(cNode)

                    nearestNode = cNode

        return nearestNode, nearestNode.type

if __name__ == "__main__":

   #训练数据集

   trainArray = [[1.0, 1.0, 'a'], [1.1, 1.1, 'a'], [1.5, 1.5, 'a'], \

           [5.0, 5.0, 'b'], [5.2, 5.2, 'b'], [5.5, 5.5, 'b'], \

           [3.0, 2.5, 'c'], [3.1, 2.8, 'c'], [3.2, 2.4, 'c']]

   kdtree = Kdtree().build_tree(trainArray)

   #test1

   testNode = [1.6, 1.5]

   _, testType = kdtree.find_type(testNode)

   print("the type of ", testNode, "is ", testType)

   #test2

   testNode = [3.5, 2.7]

   _, testType = kdtree.find_type(testNode)

   print("the type of ", testNode, "is ", testType)

   #test3

   testNode = [4.3, 5.1]

   _, testType = kdtree.find_type(testNode)

   print("the type of ", testNode, "is ", testType)
测试结果
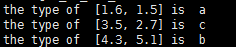
通过测试结果可知,kd树可以有效地对输入数据进行类型的识别。
讨论
虽然通过测试结果正确,但代码依然存在许多需要改进的地方,如kd树的选择,可以通过改进为红黑平衡树,来提高搜索速度。以及对于树的每层切分平面的维度选择,可以选择各维度中方差最大的维度,这样在此维度下的点分布更加分散,使后续的查找难度更小等等。
统计学习三:2.K近邻法代码实现(以最近邻法为例)的更多相关文章
- 统计学习方法三:K近邻
一.什么是K近邻? K近邻是一种基本的分类和回归方法. 在分类时,对新的实例,根据其K个最近邻的训练实例的类别,通过多数表决权等方式预测其类别. 通俗的讲,找K个和其关系最近的邻居,哪个类别的邻居多, ...
- 统计学习笔记之k近邻法
1.kNN算法的思想:给定一个训练数据集,对新的输入实例,在训练集中找到与该实例最近邻的k个实例,这k个实例的多数属于某类,就把输入实例分为这个类. 2.算法 (1)根据给定的距离度量,在训练集T中找 ...
- 4.机器学习——统计学习三要素与最大似然估计、最大后验概率估计及L1、L2正则化
1.前言 之前我一直对于“最大似然估计”犯迷糊,今天在看了陶轻松.忆臻.nebulaf91等人的博客以及李航老师的<统计学习方法>后,豁然开朗,于是在此记下一些心得体会. “最大似然估计” ...
- kd树 求k近邻 python 代码
之前两篇随笔介绍了kd树的原理,并用python实现了kd树的构建和搜索,具体可以参考 kd树的原理 python kd树 搜索 代码 kd树常与knn算法联系在一起,knn算法通常要搜索k近邻, ...
- 统计学习三:1.k近邻法
全文引用自<统计学习方法>(李航) K近邻算法(k-nearest neighbor, KNN) 是一种非常简单直观的基本分类和回归方法,于1968年由Cover和Hart提出.在本文中, ...
- 统计学习方法(三)——K近邻法
/*先把标题给写了.这样就能经常提醒自己*/ 1. k近邻算法 k临近算法的过程,即对一个新的样本,找到特征空间中与其最近的k个样本,这k个样本多数属于某个类,就把这个新的样本也归为这个类. 算法 ...
- 第三章 K近邻法(k-nearest neighbor)
书中存在的一些疑问 kd树的实现过程中,为何选择的切分坐标轴要不断变换?公式如:x(l)=j(modk)+1.有什么好处呢?优点在哪?还有的实现是通过选取方差最大的维度作为划分坐标轴,有何区别? 第一 ...
- kNN(k近邻)算法代码实现
目标:预测未知数据(或测试数据)X的分类y 批量kNN算法 1.输入一个待预测的X(一维或多维)给训练数据集,计算出训练集X_train中的每一个样本与其的距离 2.找到前k个距离该数据最近的样本-- ...
- 机器学习 —— 基础整理(三)生成式模型的非参数方法: Parzen窗估计、k近邻估计;k近邻分类器
本文简述了以下内容: (一)生成式模型的非参数方法 (二)Parzen窗估计 (三)k近邻估计 (四)k近邻分类器(k-nearest neighbor,kNN) (一)非参数方法(Non-param ...
随机推荐
- oracle导出sequences
将某个用户的全部sequence查询出来,并拼成创建语句: select 'create sequence '||sequence_name|| ' minvalue '||min_value|| ' ...
- MongoTemplate复合条件查询
分. 排序.按时间查询 Query query = new Query(); //必须条件 Criteria c = Criteria.where("VINID& ...
- 创建oracle数据库表空间并分配用户
我们在本地的oracle上或者virtualbox的oracle上 创建新的数据库表空间操作:通过system账号来创建并授权/*--创建表空间create tablespace YUJKDATAda ...
- STL专题·vector容器
1.构造函数 vector():创建一个空vector vector(int nSize):创建一个vector,元素个数为nSize (vector<int> a(10);) vecto ...
- lock free
#include <thread> #include <iostream> #include <mutex> #include <atomic> #in ...
- MySQL索引的使用及注意事项
索引是存储引擎用于快速找到记录的一种数据结构.索引优化应该是对查询性能优化最有效的手段了.索引能够轻易将查询性能提高几个数量级,"最优"的索引有时比一个"好的" ...
- Virtualization state: Optimized (version 7.4 installed)
[Virtualization state: Optimized (version 7.4 installed)] [root@localhost ~]# cd /mnt/ [root@localho ...
- go加密算法:非对称加密(二)--Hash
关于一些加密算法的应用和信息,可以在以下博客中查找到: https://www.cnblogs.com/charlesblc/p/6130141.html // MyHash package main ...
- JDBC与Java数据库编程基础
一.JDBC 概述 1.什么是JDBC 称为Java数据库连接,它是一种用于数据库访问的应用程序API,由一组用Java语言编写的类和接口组成,有了JDBC就可以用同一的语法对多种关系数据库进行访问, ...
- C数列下标 牛客OI赛制测试赛2
链接:https://www.nowcoder.com/acm/contest/185/C来源:牛客网 给出一个数列 A,求出一个数列B. 其中Bi 表示 数列A中 Ai 右边第一个比 Ai 大的 ...