
6月22日 Django中ORM的F查询和Q查询、事务、QuerySet方法大全
一、F查询和Q查询
F查询
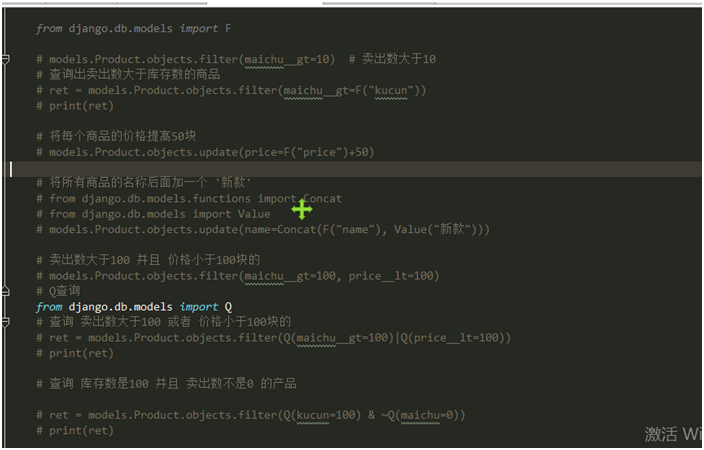
在上面所有的例子中,我们构造的过滤器都只是将字段值与某个常量做比较。如果我们要对两个字段的值做比较,那该怎么做呢?
Django 提供 F() 来做这样的比较。F() 的实例可以在查询中引用字段,来比较同一个 model 实例中两个不同字段的值。
示例1:
查询评论数大于收藏数的书籍
from django.db.models import F

models.Book.objects.filter(commnet_num__gt=F('keep_num'))
Django 支持 F() 对象之间以及 F() 对象和常数之间的加减乘除和取模的操作。
models.Book.objects.filter(commnet_num__lt=F('keep_num')*2)
修改操作也可以使用F函数,比如将每一本书的价格提高30元
models.Book.objects.all().update(price=F("price")+30)
引申:
如果要修改char字段咋办?
如:把所有书名后面加上(第一版) F的字符串拼接
>>> from django.db.models.functions import Concat

>>> from django.db.models import Value

>>> models.Book.objects.all().update(title=Concat(F("title"), Value("("), Value("第一版"), Value(")")))
Q查询
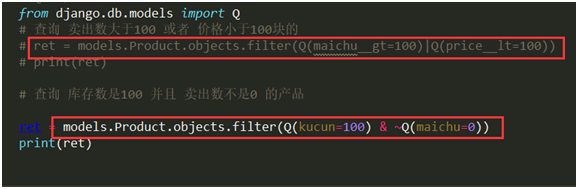
filter() 等方法中的关键字参数查询都是一起进行“AND” 的。 如果你需要执行更复杂的查询(例如OR语句),你可以使用Q对象。
示例1:
查询作者名是小仙女或小魔女的
models.Book.objects.filter(Q(authors__name="小仙女")|Q(authors__name="小魔女"))
你可以组合& 和| 操作符以及使用括号进行分组来编写任意复杂的Q 对象。同时,Q 对象可以使用~ 操作符取反,这允许组合正常的查询和取反(NOT) 查询。
示例:查询作者名字是小仙女并且不是2018年出版的书的书名。
>>> models.Book.objects.filter(Q(author__name="小仙女") & ~Q(publish_date__year=2018)).values_list("title")

<QuerySet [('番茄物语',)]>
查询函数可以混合使用Q 对象和关键字参数。所有提供给查询函数的参数(关键字参数或Q 对象)都将"AND”在一起。但是,如果出现Q 对象,它必须位于所有关键字参数的前面。
例如:查询出版年份是2017或2018,书名中带物语的所有书。
>>> models.Book.objects.filter(Q(publish_date__year=2018) | Q(publish_date__year=2017), title__icontains="物语")

<QuerySet [<Book: 番茄物语>, <Book: 香蕉物语>, <Book: 橘子物语>]>
二、事务
import os

if __name__ == '__main__':

    os.environ.setdefault("DJANGO_SETTINGS_MODULE", "BMS.settings")

    import django

    django.setup()

    import datetime

    from app01 import models

    try:

        from django.db import transaction

        with transaction.atomic():

            new_publisher = models.Publisher.objects.create(name="火星出版社")

            models.Book.objects.create(title="橘子物语", publish_date=datetime.date.today(), publisher_id=10)  # 指定一个不存在的出版社id

    except Exception as e:

        print(str(e))
三、QuerySet方法大全
##################################################################

# PUBLIC METHODS THAT ALTER ATTRIBUTES AND RETURN A NEW QUERYSET #

##################################################################

def all(self)

    # 获取所有的数据对象

def filter(self, *args, **kwargs)

    # 条件查询

    # 条件可以是:参数,字典,Q

def exclude(self, *args, **kwargs)

    # 条件查询

    # 条件可以是:参数,字典,Q

def select_related(self, *fields)

    性能相关:表之间进行join连表操作,一次性获取关联的数据。

    总结:

    1. select_related主要针一对一和多对一关系进行优化。

    2. select_related使用SQL的JOIN语句进行优化,通过减少SQL查询的次数来进行优化、提高性能。

def prefetch_related(self, *lookups)

    性能相关:多表连表操作时速度会慢,使用其执行多次SQL查询在Python代码中实现连表操作。

    总结:

    1. 对于多对多字段(ManyToManyField)和一对多字段,可以使用prefetch_related()来进行优化。

    2. prefetch_related()的优化方式是分别查询每个表,然后用Python处理他们之间的关系。

def annotate(self, *args, **kwargs)

    # 用于实现聚合group by查询

    from django.db.models import Count, Avg, Max, Min, Sum

    v = models.UserInfo.objects.values('u_id').annotate(uid=Count('u_id'))

    # SELECT u_id, COUNT(ui) AS `uid` FROM UserInfo GROUP BY u_id

    v = models.UserInfo.objects.values('u_id').annotate(uid=Count('u_id')).filter(uid__gt=1)

    # SELECT u_id, COUNT(ui_id) AS `uid` FROM UserInfo GROUP BY u_id having count(u_id) > 1

    v = models.UserInfo.objects.values('u_id').annotate(uid=Count('u_id',distinct=True)).filter(uid__gt=1)

    # SELECT u_id, COUNT( DISTINCT ui_id) AS `uid` FROM UserInfo GROUP BY u_id having count(u_id) > 1

def distinct(self, *field_names)

    # 用于distinct去重

    models.UserInfo.objects.values('nid').distinct()

    # select distinct nid from userinfo

    注:只有在PostgreSQL中才能使用distinct进行去重

def order_by(self, *field_names)

    # 用于排序

    models.UserInfo.objects.all().order_by('-id','age')

def extra(self, select=None, where=None, params=None, tables=None, order_by=None, select_params=None)

    # 构造额外的查询条件或者映射,如:子查询

    Entry.objects.extra(select={'new_id': "select col from sometable where othercol > %s"}, select_params=(1,))

    Entry.objects.extra(where=['headline=%s'], params=['Lennon'])

    Entry.objects.extra(where=["foo='a' OR bar = 'a'", "baz = 'a'"])

    Entry.objects.extra(select={'new_id': "select id from tb where id > %s"}, select_params=(1,), order_by=['-nid'])

 def reverse(self):

    # 倒序

    models.UserInfo.objects.all().order_by('-nid').reverse()

    # 注:如果存在order_by,reverse则是倒序,如果多个排序则一一倒序

 def defer(self, *fields):

    models.UserInfo.objects.defer('username','id')

    或

    models.UserInfo.objects.filter(...).defer('username','id')

    #映射中排除某列数据

 def only(self, *fields):

    #仅取某个表中的数据

     models.UserInfo.objects.only('username','id')

     或

     models.UserInfo.objects.filter(...).only('username','id')

 def using(self, alias):

     指定使用的数据库,参数为别名(setting中的设置)

##################################################

# PUBLIC METHODS THAT RETURN A QUERYSET SUBCLASS #

##################################################

def raw(self, raw_query, params=None, translations=None, using=None):

    # 执行原生SQL

    models.UserInfo.objects.raw('select * from userinfo')

    # 如果SQL是其他表时,必须将名字设置为当前UserInfo对象的主键列名

    models.UserInfo.objects.raw('select id as nid from 其他表')

    # 为原生SQL设置参数

    models.UserInfo.objects.raw('select id as nid from userinfo where nid>%s', params=[12,])

    # 将获取的到列名转换为指定列名

    name_map = {'first': 'first_name', 'last': 'last_name', 'bd': 'birth_date', 'pk': 'id'}

    Person.objects.raw('SELECT * FROM some_other_table', translations=name_map)

    # 指定数据库

    models.UserInfo.objects.raw('select * from userinfo', using="default")

    ################### 原生SQL ###################

    from django.db import connection, connections

    cursor = connection.cursor()  # cursor = connections['default'].cursor()

    cursor.execute("""SELECT * from auth_user where id = %s""", [1])

    row = cursor.fetchone() # fetchall()/fetchmany(..)

def values(self, *fields):

    # 获取每行数据为字典格式

def values_list(self, *fields, **kwargs):

    # 获取每行数据为元祖

def dates(self, field_name, kind, order='ASC'):

    # 根据时间进行某一部分进行去重查找并截取指定内容

    # kind只能是:"year"(年), "month"(年-月), "day"(年-月-日)

    # order只能是:"ASC"  "DESC"

    # 并获取转换后的时间

        - year : 年-01-01

        - month: 年-月-01

        - day  : 年-月-日

    models.DatePlus.objects.dates('ctime','day','DESC')

def datetimes(self, field_name, kind, order='ASC', tzinfo=None):

    # 根据时间进行某一部分进行去重查找并截取指定内容,将时间转换为指定时区时间

    # kind只能是 "year", "month", "day", "hour", "minute", "second"

    # order只能是:"ASC"  "DESC"

    # tzinfo时区对象

    models.DDD.objects.datetimes('ctime','hour',tzinfo=pytz.UTC)

    models.DDD.objects.datetimes('ctime','hour',tzinfo=pytz.timezone('Asia/Shanghai'))

    """

    pip3 install pytz

    import pytz

    pytz.all_timezones

    pytz.timezone(‘Asia/Shanghai’)

    """

def none(self):

    # 空QuerySet对象

####################################

# METHODS THAT DO DATABASE QUERIES #

####################################

def aggregate(self, *args, **kwargs):

   # 聚合函数,获取字典类型聚合结果

   from django.db.models import Count, Avg, Max, Min, Sum

   result = models.UserInfo.objects.aggregate(k=Count('u_id', distinct=True), n=Count('nid'))

   ===> {'k': 3, 'n': 4}

def count(self):

   # 获取个数

def get(self, *args, **kwargs):

   # 获取单个对象

def create(self, **kwargs):

   # 创建对象

def bulk_create(self, objs, batch_size=None):

    # 批量插入

    # batch_size表示一次插入的个数

    objs = [

        models.DDD(name='r11'),

        models.DDD(name='r22')

    ]

    models.DDD.objects.bulk_create(objs, 10)

def get_or_create(self, defaults=None, **kwargs):

    # 如果存在,则获取,否则,创建

    # defaults 指定创建时,其他字段的值

    obj, created = models.UserInfo.objects.get_or_create(username='root1', defaults={'email': '1111111','u_id': 2, 't_id': 2})

def update_or_create(self, defaults=None, **kwargs):

    # 如果存在,则更新,否则,创建

    # defaults 指定创建时或更新时的其他字段

    obj, created = models.UserInfo.objects.update_or_create(username='root1', defaults={'email': '1111111','u_id': 2, 't_id': 1})

def first(self):

   # 获取第一个

def last(self):

   # 获取最后一个

def in_bulk(self, id_list=None):

   # 根据主键ID进行查找

   id_list = [11,21,31]

   models.DDD.objects.in_bulk(id_list)

def delete(self):

   # 删除

def update(self, **kwargs):

    # 更新

def exists(self):

   # 是否有结果

QuerySet方法大全
QuerySet方法大全
1. select_related和prefetch_related 跨表查询时用到以提高效率
1. select_related 利用 SQL的JOIN来减少查询数据库的次数
适用于一对一和多对一的查询的情况
# b = models.B.objects.first()

    # print(b.a.name)

    # b_list = models.B.objects.all()  #只取出B自己的字段

    # for b in b_list:

    #     print(b.a.name)   #每次都会执行一次查询语句

    b_list = models.B.objects.select_related("a").all()  #连表,将数据全部取出

    for b in b_list:

        print(b.a.name)
2. prefetch_related 利用 Python 来做类似JOIN操作
select_related 是join表,prefetch_related是select套select提高了sql执行效率
2. bulk_create
批量创建
    import random

    # list1 = []

    # for i in range(4):

    #     list1.append(random.randint(65, 99))

    # 批量插入

    # ["66676869", "69656863", ...]

    data = ["".join([str(random.randint(65, 99)) for i in range(4)]) for j in range(100)]

    # for i in data:

    #     models.A.objects.create(name=i)

    obj_list = [models.A(name=i) for i in data]

    # 批量插入

    models.A.objects.bulk_create(obj_list)
6月22日 Django中ORM的F查询和Q查询、事务、QuerySet方法大全的更多相关文章
- 6月20日 Django中ORM介绍和字段、字段参数、相关操作
一.Django中ORM介绍和字段及字段参数 二.Django ORM 常用字段和参数 三.Django ORM执行原生SQL.在Python脚本中调用Django环境.Django终端打印SQL语句 ...
- Django中ORM模型总结(一)[概述,查询语句]
理解ORM框架 概述 O:(objects)->类和对象. R:(Relation)->关系,关系数据库中的表格. M:(Mapping)->映射. 作用: 可以通过类和类对象就可以 ...
- Django中的ORM相关操作:F查询,Q查询,事物,ORM执行原生SQL
一 F查询与Q查询: 1 . F查询: 在上面所有的例子中,我们构造的过滤器都只是将字段值与某个常量做比较.如果我们要对两个字段的值做比较,那该怎么做呢? Django 提供 F() 来做这样的 ...
- django中orm使用的注意事项
必备小知识点 <1> all(): 查询所有结果 <2> get(**kwargs): 返回与所给筛选条件相匹配的对象,返回结果有且只有一个,如果符合筛选条件的对象超过一个或者 ...
- 12月22日《奥威Power-BI财务报表数据填报》腾讯课堂开课啦
一扇可以通向任何地方的“任意门”,是我们多少人幼时最梦寐以求的道具之一.即使到了现在,工作中的我们还会时不时有“世界那么大,我想去看看”的念头,或者在突然不想工作的时刻,幻想着自己的家门变成了“任意门 ...
- Autodesk 最新开发技术研讨会 -8月22日-Autodesk北京办公室
为了增进与广大中国地区Autodesk产品的二次开发人员的了解与互动,帮助中国地区的Autodesk产品二次开发人员了解Autodesk最新的二次开发技术动向,并获得Autodesk公司专业开发支持顾 ...
- 微软SQL Server认证最新信息(17年5月22日更新),感兴趣的进来看看哟
之前一直有在关注微软认证的一些消息,由于最新的SQL Server认证加入了2016的相关内容,导致课程资料需要大部分更新,但是微软更新相对比较慢,并且经常改版,目前发现的最新的MCP Cert Pa ...
- 优步UBER司机全国各地奖励政策汇总 (2月22日-2月28日)
滴快车单单2.5倍,注册地址:http://www.udache.com/ 如何注册Uber司机(全国版最新最详细注册流程)/月入2万/不用抢单:http://www.cnblogs.com/mfry ...
- 北京Uber优步司机奖励政策(11月16日~11月22日)
用户组:人民优步“关羽组”(适用于11月16日-11月22日)奖励政策: 滴快车单单2.5倍,注册地址:http://www.udache.com/ 如何注册Uber司机(全国版最新最详细注册流程)/ ...
随机推荐
- Solution -「CF 1392H」ZS Shuffles Cards
\(\mathcal{Description}\) Link. 打乱的 \(n\) 张编号 \(1\sim n\) 的数字排和 \(m\) 张鬼牌.随机抽牌,若抽到数字,将数字加入集合 \(S ...
- ansible批量修改服务器密码
看了一下网上代码大多数是ansible-playbook实现的,需要写一个脚本,或者手动传递变量进去. 以前用python tcp模块写过客户端主动上报修改密码脚本 今天写一个ansible主控客户端 ...
- C#控制台输出瑞典、中文显、日语显示乱码问题
问题:瑞典文字的"æ"在控制台中无法正确的显示? String[] strings1 = { "case", "encyclopædia", ...
- 像追女神一样学好java~
写在前面的话 ● 本文适合食用的观众大老爷和小建议: ----本文内容主要是围绕java这门语言展开~ 适合的食用的大老爷们: ★ 第一类:完全没学过其他编程语言入门java的小白 ★ 第二类:已经学 ...
- MySQL 学习笔记(一)MySQL 事务的ACID特性
MySQL事务是什么,它就是一组数据库的操作,是访问数据库的程序单元,事务中可能包含一个或者多个 SQL 语句.这些SQL 语句要么都执行.要么都不执行.我们知道,在MySQL 中,有不同的存储引擎, ...
- Qt:使用SqlQuery进行查询时size总是-1
原因:SQL语句没有符合格式,特别是在换行写一个SQL语句时,不同行之间没有写空格
- shell日常积累
Linux shell脚本中shift的用法说明 https://blog.csdn.net/zhu_xun/article/details/24796235
- JZ-030-连续子数组的最大和
连续子数组的最大和 题目描述 HZ偶尔会拿些专业问题来忽悠那些非计算机专业的同学.今天测试组开完会后,他又发话了:在古老的一维模式识别中,常常需要计算连续子向量的最大和, 当向量全为正数的时候,问题很 ...
- 自定义 serializers.ValidationError 的错误返回
在使用DRF进行反序列过程中,总是需要校验字段,然后返回错误结果.可以使用默认的自定义校验项,也可以自定义校验项.而默认的自定义校验项总是差强人意. 版本 Django 2.2.3 Python 3. ...
- docker学习笔记(2)- 仓库
Docker仓库是镜像存储.分发.部署的关键,制作好应用程序镜像后上传到仓库,使用Docker daemon从仓库拉取后运行,我们可以使用官方共有仓库docker hub或者搭建私有仓库 Docker ...