
Pytorch中的Batch Normalization操作
之前一直和小伙伴探讨batch normalization层的实现机理,作用在这里不谈,知乎上有一篇paper在讲这个,链接
这里只探究其具体运算过程,我们假设在网络中间经过某些卷积操作之后的输出的feature map的尺寸为4×3×2×2
4为batch的大小,3为channel的数目,2×2为feature map的长宽
整个BN层的运算过程如下图
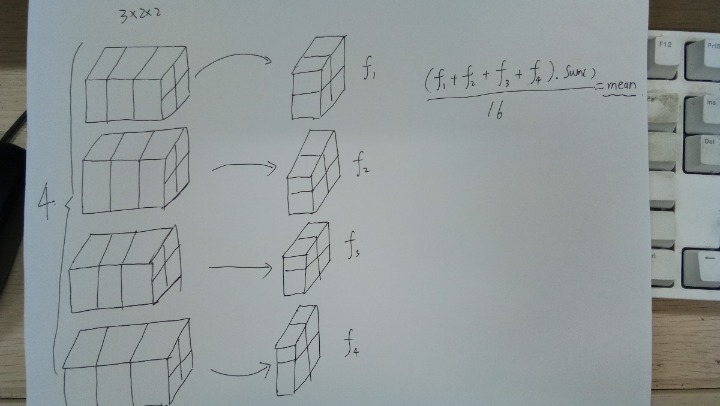
上图中,batch size一共是4, 对于每一个batch的feature map的size是3×2×2
对于所有batch中的同一个channel的元素进行求均值与方差,比如上图,对于所有的batch,都拿出来最后一个channel,一共有4×4=16个元素,
然后求区这16个元素的均值与方差(上图只求了mean,没有求方差。。。),
求取完了均值与方差之后,对于这16个元素中的每个元素进行减去求取得到的均值与方差,然后乘以gamma加上beta,公式如下

所以对于一个batch normalization层而言,求取的均值与方差是对于所有batch中的同一个channel进行求取,batch normalization中的batch体现在这个地方
batch normalization层能够学习到的参数,对于一个特定的channel而言实际上是两个参数,gamma与beta,对于total的channel而言实际上是channel数目的两倍。
用pytorch验证上述想法是否准确,用上述方法求取均值,以及用batch normalization层输出的均值,看看是否一样
上代码
 # -*-coding:utf-8-*-

 from torch import nn

 import torch

 m = nn.BatchNorm2d(3)  # bn设置的参数实际上是channel的参数

 input = torch.randn(4, 3, 2, 2)

 output = m(input)

 # print(output)

 a = (input[0, 0, :, :]+input[1, 0, :, :]+input[2, 0, :, :]+input[3, 0, :, :]).sum()/16

 b = (input[0, 1, :, :]+input[1, 1, :, :]+input[2, 1, :, :]+input[3, 1, :, :]).sum()/16

 c = (input[0, 2, :, :]+input[1, 2, :, :]+input[2, 2, :, :]+input[3, 2, :, :]).sum()/16

 print('The mean value of the first channel is %f' % a.data)

 print('The mean value of the first channel is %f' % b.data)

 print('The mean value of the first channel is %f' % c.data)

 print('The output mean value of the BN layer is %f, %f, %f' % (m.running_mean.data[0],m.running_mean.data[0],m.running_mean.data[0]))

 print(m)
用
m = nn.BatchNorm2d(3)
声明新的batch normalization层,用
input = torch.randn(4, 3, 2, 2)
模拟feature map的尺寸
输出值
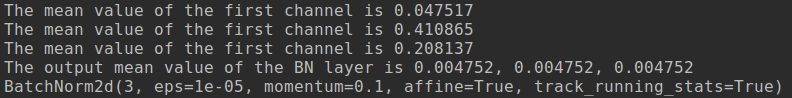
咦,怎么不一样,貌似差了一个小数点,可能与BN层的momentum变量有关系,在生命batch normalization层的时候将momentum设置为1试一试
m.momentum=1
输出结果
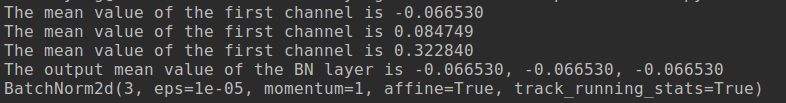
没毛病
至于方差以及输出值,大抵也是这样进行计算的吧,留个坑
Pytorch中的Batch Normalization操作的更多相关文章
- PyTorch中的Batch Normalization
Pytorch中的BatchNorm的API主要有: 1 torch.nn.BatchNorm1d(num_features, 2 3 eps=1e-05, 4 5 momentum=0.1, 6 7 ...
- Tensorflow BatchNormalization详解:4_使用tf.nn.batch_normalization函数实现Batch Normalization操作
使用tf.nn.batch_normalization函数实现Batch Normalization操作 觉得有用的话,欢迎一起讨论相互学习~Follow Me 参考文献 吴恩达deeplearnin ...
- 使用TensorFlow中的Batch Normalization
问题 训练神经网络是一个很复杂的过程,在前面提到了深度学习中常用的激活函数,例如ELU或者Relu的变体能够在开始训练的时候很大程度上减少梯度消失或者爆炸问题.但是却不能保证在训练过程中不出现该问题, ...
- 在tensorflow中使用batch normalization
问题 训练神经网络是一个很复杂的过程,在前面提到了深度学习中常用的激活函数,例如ELU或者Relu的变体能够在开始训练的时候很大程度上减少梯度消失或者爆炸问题,但是却不能保证在训练过程中不出现该问题, ...
- tensorflow中使用Batch Normalization
在深度学习中为了提高训练速度,经常会使用一些正正则化方法,如L2.dropout,后来Sergey Ioffe 等人提出Batch Normalization方法,可以防止数据分布的变化,影响神经网络 ...
- 神经网络中使用Batch Normalization 解决梯度问题
BN本质上解决的是反向传播过程中的梯度问题. 详细点说,反向传播时经过该层的梯度是要乘以该层的参数的,即前向有: 那么反向传播时便有: 那么考虑从l层传到k层的情况,有: 上面这个 便是问题所在.因为 ...
- Batch Normalization原理及其TensorFlow实现——为了减少深度神经网络中的internal covariate shift,论文中提出了Batch Normalization算法,首先是对”每一层“的输入做一个Batch Normalization 变换
批标准化(Bactch Normalization,BN)是为了克服神经网络加深导致难以训练而诞生的,随着神经网络深度加深,训练起来就会越来越困难,收敛速度回很慢,常常会导致梯度弥散问题(Vanish ...
- tensorflow中batch normalization的用法
网上找了下tensorflow中使用batch normalization的博客,发现写的都不是很好,在此总结下: 1.原理 公式如下: y=γ(x-μ)/σ+β 其中x是输入,y是输出,μ是均值,σ ...
- pytorch中文文档-torch.nn常用函数-待添加-明天继续
https://pytorch.org/docs/stable/nn.html 1)卷积层 class torch.nn.Conv2d(in_channels, out_channels, kerne ...
随机推荐
- [LeetCode] 104. Maximum Depth of Binary Tree ☆(二叉树的最大深度)
描述 Given a binary tree, find its maximum depth. The maximum depth is the number of nodes along the l ...
- ActiveMQ producer同步/异步发送消息
http://activemq.apache.org/async-sends.html producer发送消息有同步和异步两种模式,可以通过代码配置: ((ActiveMQConnection)co ...
- vue2.0 transition 手风琴
<div class="food"> <button @click="show=!show">show</button> & ...
- js如何返回两个数的商的整数和余数部分?
js中,如何返回两个数的商的整数和余数部分? 如: num1:100 ,num2:12 var num = parseFloat(100/12); //值: 8.333333333333334 那么如 ...
- sql server 根据身份证号计算出生日期和年龄的存储过程
我这边有一个业务,需要客户填写身份证号,自动计算他的出生日期和年龄 在sql中,具体的存储过程实现是这样的: /******************************************** ...
- Mac下安装和配置Maven
1.下载Maven 官网:http://maven.apache.org/download.cgi 下载版本:apache-maven-3.5.3-bin.tar.gz 2.配置环境变量 打开term ...
- 逆袭之旅DAY30.XIA.集合
2018年7月26日 面试题:List和set的区别 ArrayList 遍历效率较高,但添加和删除较慢 遍历集合最高效的方法:迭代器 集合的遍历: 迭代器:Iterator 创建 为什么使用泛型: ...
- day03_python_1124
01 昨日内容回顾 while 条件: 循环体 如何终止循环: 1,改变条件. 2,break. 3,exit() quit() 不推荐. 关键字: break continue while else ...
- HTML5 ③
超链接和锚链接: 1.超链接标签:<a herf="需要连接的页面地址" target=“01._self :在当前页面打开 *默认值 02. _blank :新窗口 ...
- bootstrap学习参考网站
----https://www. evget .com /article /