
L1与L2正则化
过拟合
机器学习中,如果参数过多、模型过于复杂,容易造成过拟合。
结构风险最小化原理
在经验风险最小化(训练误差最小化)的基础上,尽可能采用简单的模型,以提高模型泛化预测精度。
正则化
为了避免过拟合,最常用的一种方法是使用正则化,例如L1和L2正则化。
所谓的正则化,就是在原来损失函数的基础上,加了一些正则化项,或者叫做模型复杂度惩罚项。
L2正则化
L2正则化即:\(L=E_{in}+\lambda\sum_j\omega^2_j\),其中,\(E_{in}\)是原来的损失函数;\(\lambda\)是正则化参数,可调整;\(\omega_j\)是参数。
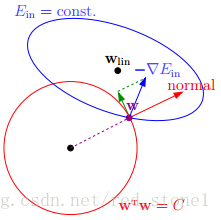
由上可知,正则化是为了限制参数过多,避免模型过于复杂。因此,我们可以令高阶部分的权重\(\omega\)为0,这样就相当于从高阶转换为低阶。然而,这是个NP难问题,将其适度简化为:\(\sum_j\omega_j^2≤C\),令\(\omega_j\)的平方和小于\(C\)。这时,我们的目标就转换为:令\(E_{in}\)最小,但是要遵循\(w\)平方和小于\(C\)的条件,如下图所示:
L1正则化
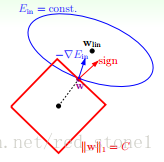
L1正则化和L2正则化相似:\(L=E_{in}+\lambda\sum_j|\omega_j|\),同样地,图形如下:
L1与L2正则化
满足正则化条件,实际上是求解上面图中红色形状与蓝色椭圆的交点,即同时满足限定条件和\(E_{in}\)最小化。
对于L2来说,限定区域是圆,这样得到的解\(\omega_1\)或\(\omega_2\)(以二元为例)为0的概率很小,且很大概率是非零的。
对于L1来说,限定区域是正方形,方形与蓝色区域相交的交点是顶点的概率很大,这从视觉和常识上来看是很容易理解的。也就是说,正方形的凸点会更接近 \(E_{in}\)最优解对应的\(\omega\)位置,而凸点处必有\(\omega_1\)或\(\omega_2\)为0。这样,得到的解\(\omega_1\)或\(\omega_2\)为零的概率就很大了。所以,L1正则化的解具有稀疏性。
扩展到高维,同样的道理,L2的限定区域是平滑的,与中心点等距;而 L1 的限定区域是包含凸点的,尖锐的。这些凸点更接近\(E_{in}\)的最优解位置,而在这些凸点上,很多\(\omega_j\)为0。
参考链接
https://www.jianshu.com/p/76368eba9c90
https://segmentfault.com/a/1190000014680167?utm_source=tag-newest
https://blog.csdn.net/red_stone1/article/details/80755144
作者:@臭咸鱼
转载请注明出处:https://www.cnblogs.com/chouxianyu/
欢迎讨论和交流!
L1与L2正则化的更多相关文章
- 4.机器学习——统计学习三要素与最大似然估计、最大后验概率估计及L1、L2正则化
1.前言 之前我一直对于“最大似然估计”犯迷糊,今天在看了陶轻松.忆臻.nebulaf91等人的博客以及李航老师的<统计学习方法>后,豁然开朗,于是在此记下一些心得体会. “最大似然估计” ...
- 深入理解L1、L2正则化
过节福利,我们来深入理解下L1与L2正则化. 1 正则化的概念 正则化(Regularization) 是机器学习中对原始损失函数引入额外信息,以便防止过拟合和提高模型泛化性能的一类方法的统称.也就是 ...
- L1 与 L2 正则化
参考这篇文章: https://baijiahao.baidu.com/s?id=1621054167310242353&wfr=spider&for=pc https://blog. ...
- Spark2.0机器学习系列之12: 线性回归及L1、L2正则化区别与稀疏解
概述 线性回归拟合一个因变量与一个自变量之间的线性关系y=f(x). Spark中实现了: (1)普通最小二乘法 (2)岭回归(L2正规化) (3)La ...
- day-17 L1和L2正则化的tensorflow示例
机器学习中几乎都可以看到损失函数后面会添加一个额外项,常用的额外项一般有两种,一般英文称作ℓ1-norm和ℓ2-norm,中文称作L1正则化和L2正则化,或者L1范数和L2范数.L2范数也被称为权重衰 ...
- 机器学习中的L1、L2正则化
目录 1. 什么是正则化?正则化有什么作用? 1.1 什么是正则化? 1.2 正则化有什么作用? 2. L1,L2正则化? 2.1 L1.L2范数 2.2 监督学习中的L1.L2正则化 3. L1.L ...
- L1与L2正则化的对比及多角度阐述为什么正则化可以解决过拟合问题
正则化是一种回归的形式,它将系数估计(coefficient estimate)朝零的方向进行约束.调整或缩小.也就是说,正则化可以在学习过程中降低模型复杂度和不稳定程度,从而避免过拟合的危险. 一. ...
- L1、L2正则化详解
正则化是一种回归的形式,它将系数估计(coefficient estimate)朝零的方向进行约束.调整或缩小.也就是说,正则化可以在学习过程中降低模型复杂度和不稳定程度,从而避免过拟合的危险. 一. ...
- tensorflow 中的L1和L2正则化
import tensorflow as tf weights = tf.constant([[1.0, -2.0],[-3.0 , 4.0]]) >>> sess.run(tf.c ...
随机推荐
- Egret入门学习日记 --- 第十八篇(书中 8.5~8.7 节 内容)
第十八篇(书中 8.5~8.7 节 内容) 其实语法篇,我感觉没必要写录入到日记里. 我也犹豫了好久,到底要不要录入. 这样,我先读一遍语法篇的所有内容,我觉得值得留下的,我就录入日记里. 不然像昨天 ...
- blender-编译源码
1. 获得源码,目前是以 2.8 版本为例子 https://www.blender.org/download/ 上,可以直接下面源码 2. 解压,在blender-2.80 目录下,运行 mak ...
- Go之接口interface(1)
1. 什么是interface在此之前,我们遇到的都是具体的类型,比如数字类型.切片类型等等.对于这些具体的类型,我们总是能知道它是什么.可以利用它来做什么,比如对于一个数字类型,我们知道可以对其进行 ...
- 综合练习2 设置访问权限,Easy-IP访问外网,内外网访问
实验拓扑图: 实验要求: 1.pc.路由.交换基本配置,vlan间路由互通. 2.vlan20.vlan30可以访问FTP,VLAN10不允许访问FTP. 3.AR1通过easy-ip方式实现私网地址 ...
- 冲刺Noip2017模拟赛8 解题报告——五十岚芒果酱
1.鼎纹 [问题描述] 据说鼎纹的 种制造 式是 铜模印出来的,这是我国古代劳动 智慧 的结晶.铜模印过的地 ,会留下深深的印记,经过时间的炼化,洗 练成历史的遗存. 聪明的古代劳动人民拥有一个 a ...
- python 修改文件内容3种方法
原文链接:https://www.cnblogs.com/wc-chan/p/8085452.html def alter(file,old_str,new_str): ""&qu ...
- vue 强制刷新组件重新渲染
实现功能:使用富文本编辑器编写文章,然后把编写成功的文章用子组件显示. 问题描述:父组件给子组件传递数据,子组件第一次调用数据的时候页面渲染是正常的,当数据变化的时候,子组件的页面渲染就失效了. 问题 ...
- SrpingBoot入门到入坟02-HelloWorld的细节和初始自动配置
关于SpringBoot的第一个HelloWorld的一些细节: 1.父项目 首先查看项目中的pom.xml文件 文件中有个父项目,点进去则: 它里面也有一个父项目,再点进去: 可以发现有很多的依赖版 ...
- WUSTOJ 1287: B304(Java:355ms,C:8ms)
题目:
- 22-MySQL DBA笔记-其他产品的选择
第22章 其他产品的选择 本章将为读者介绍其他的数据库产品,主要是NoSQL产品的选择.读者在熟悉MySQL之外,也应该了解其他的数据库产品.本章的目的是给读者一个引导,如何选择一些NoSQL产品,而 ...