
Hadoop_16_MapRduce_MapTask并行度(切片)的决定机制
MapTask的并行度决定map阶段的任务处理并发度,进而影响到整个job的处理速度那么,mapTask并行实例是否越多
越好呢?其并行度又是如何决定呢?Mapper数量由输入文件的数目、大小及配置参数决定;
MapReduce将作业的整个运行过程分为两个阶段:Map阶段Reduce阶段。
Map阶段由一定数量的Map Task实例组成,例如:
- 输入数据格式解析:InputFormat
- 输入数据处理:Mapper
- 本地规约:Combiner(相当于local reducer,可选)
- 数据分组:Partitioner
Reduce阶段由一定数量的Reduce Task实例组成,例如:
- 数据远程拷贝
- 数据按照key排序
- 数据处理:Reducer
- 数据输出格式:OutputFormat
1.MapReduce的Map阶段:
1.1.从HDFS读取数据:
一个job的Map阶段并行度由客户端在提交job时决定
而客户端对map阶段并行度的规划的基本逻辑为:将待处理数据执行逻辑切片(即按照一个特定切片大小,将待处理数据
划分成逻辑上的多个split),然后每一个split分配一个MapTask并行实例处理,即就是到底启动多少个MapTask实例就意味着将
数据切成多少份(一个切片对应一个MapTask实例)
切片逻辑及形成的切片规划List描述文件,由 FileInputFormat 实现类的getSplits()方法完成:流程如下:
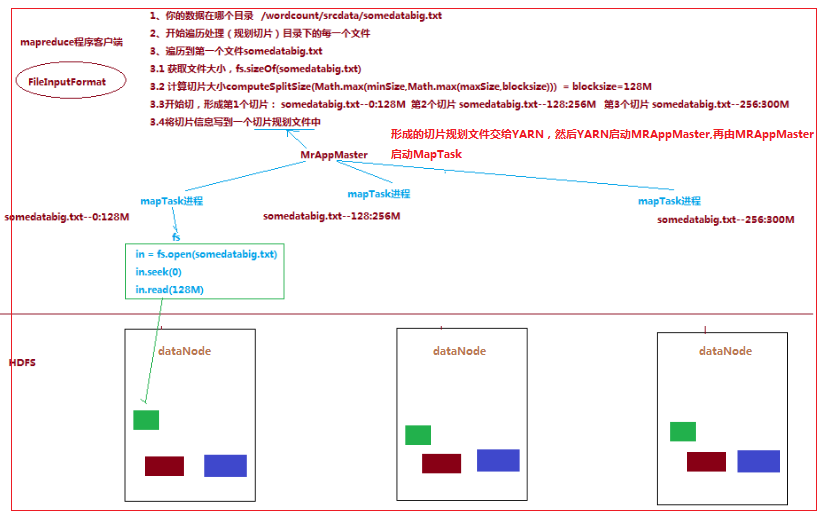
1.1.1.FileInputFormat中默认的切片机制:
a) 简单地按照文件的内容长度进行切片
b) 切片大小,默认等于block大小
c) 切片时不考虑数据集整体,而是逐个针对每一个文件单独切片
比如待处理数据有两个文件:
file1.txt    320M

file2.txt    10M
经过FileInputFormat的切片机制运算后,形成的切片信息如下:
file1.txt.split1--  0~128

file1.txt.split2--  128~256

file1.txt.split3--  256~320

file2.txt.split1--  0~10M
1.1.2.FileInputFormat中切片大小的参数配置:
通过分析源码,在FileInputFormat中,计算切片大小的逻辑:Math.max(minSize, Math.min(maxSize, blockSize));
切片主要由这几个值来运算决定
|
minsize:默认值:1 配置参数: mapreduce.input.fileinputformat.split.minsize |
|
maxsize:默认值:Long.MAXValue 配置参数:mapreduce.input.fileinputformat.split.maxsize |
|
blocksize |
因此,默认情况下,切片大小=blocksize
maxsize(切片最大值):
参数如果调得比blocksize小,则会让切片变小,而且就等于配置的这个参数的值
minsize (切片最小值):
参数调的比blockSize大,则可以让切片变得比blocksize还大
1.5 ReduceTask并行度的决定
ReduceTask的并行度同样影响整个job的执行并发度和执行效率,但与maptask的并发数由切片数决定不同,Reducetask数量
的决定是可以直接手动设置:
//默认值是1,手动设置为4
job.setNumReduceTasks(4);
如果数据分布不均匀,就有可能在reduce阶段产生数据倾斜
注意: reducetask数量并不是任意设置,还要考虑业务逻辑需求,有些情况下,需要计算全局汇总结果,就只能有1个reducetask
尽量不要运行太多的reducetask。对大多数job来说,最好rduce的个数最多和集群中的reduce持平,或者比集群的 reduce slots小
这个对于小集群而言,尤其重要。
Hadoop_16_MapRduce_MapTask并行度(切片)的决定机制的更多相关文章
- iOS通过切片仿断点机制上传文件
项目开发中,有时候我们需要将本地的文件上传到服务器,简单的几张图片还好,但是针对iPhone里面的视频文件进行上传,为了用户体验,我们有必要实现断点上传.其实也不是真的断点,这里我们只是模仿断点机制. ...
- MapReduce-TextInputFormat 切片机制
MapReduce 默认使用 TextInputFormat 进行切片,其机制如下 (1)简单地按照文件的内容长度进行切片 (2)切片大小,默认等于Block大小,可单独设置 (3)切片时不考虑数据集 ...
- job任务执行流程与分区机制
job任务执行流程 1.run job阶段 ①收集整个job的环境信息(比如通过conf设定的参数,还有mapperClass,reducerClass,以及输出kv类型) ...
- [翻译] NumSharp的数组切片功能 [:]
原文地址:https://medium.com/scisharp/slicing-in-numsharp-e56c46826630 翻译初稿(英文水平有限,请多包涵): 由于Numsharp新推出了数 ...
- go语言教程之浅谈数组和切片的异同
Hello ,各位小伙伴大家好,我是小栈君,上次分享我们讲到了Go语言关于项目工程结构的管理,本期的分享我们来讲解一下关于go语言的数组和切片的概念.用法和区别. 在go语言的程序开发过程中,我们避免 ...
- NumSharp的数组切片功能
NumSharp的数组切片功能 原文地址:https://medium.com/scisharp/slicing-in-numsharp-e56c46826630 翻译初稿(英文水平有限,请多包涵): ...
- 手把手golang教程【二】——数组与切片
本文始发于个人公众号:TechFlow,原创不易,求个关注 今天是golang专题的第五篇,这一篇我们将会了解golang中的数组和切片的使用. 数组与切片 golang当中数组和C++中的定义类似, ...
- Go切片全解析
Go切片全解析 目录结构: 数组 切片 底层结构 创建 普通声明 make方式 截取 边界问题 追加 拓展表达式 扩容机制 切片传递的坑 切片的拷贝 浅拷贝 深拷贝 数组 var n [4]int f ...
- 大数据入门第七天——MapReduce详解(二)切片源码浅析与自定义patition
一.mapTask并行度的决定机制 1.概述 一个job的map阶段并行度由客户端在提交job时决定 而客户端对map阶段并行度的规划的基本逻辑为: 将待处理数据执行逻辑切片(即按照一个特定切片大小, ...
随机推荐
- 递归-PrintDigit
static void PrintDigit(double n,int len,int count=-1) { if (n <0) { n = System.Math.Abs(n); Conso ...
- PJzhang:目录扫描复合工具dirmap
猫宁!!! 参考:https://www.freebuf.com/sectool/200890.html github地址: https://github.com/H4ckForJob/dirmap ...
- AWS物联网解决方案之:如何将设备安全地接入AWS IoT
1 简介 AWS IoT解决方案是一个全托管的云平台,使互联设备可以轻松安全地与云应用程序及其他设备交互.AWS IoT可以支持数十亿太设备和数万亿条消息,并且可以对这些消息进行处理并将其安全可靠地路 ...
- 经典卷积神经网络——AlexNet
一.网络结构 AlexNet由5层卷积层和3层全连接层组成. 论文中是把网络放在两个GPU上进行,为了方便我们仅考虑一个GPU的情况. 上图中的输入是224×224224×224,不过经过计算(224 ...
- 【Qt开发】关于QWSServer
QWS Server QT Embeded应用没有来严格的区分server和client进程,如果一个QT进程的启动参数中有-qws,那么这个进程就具有server管理功能,被称为QWS server ...
- centOS 安装 npm
下载 cd /usr/local/node wget https://npm.taobao.org/mirrors/node/v10.14.1/node-v10.14.1-linux-x64.tar. ...
- kindeditor 在JSP 中上传文件的配置
1.将kindeditor,jsp,lib目录下的jar文件放到工程的lib目录下 2.将admin-login.jsp,upload_json.jsp,复制到admin的files目录下 3.复制以 ...
- 后端 SpringBoot + 前端 vue 打包发布到Tomcat
近段时间 做了一些前后端的开发 需要在Tomcat里进行发布 把自己整理的分享出来 后端打包 pom.xml 文件 <packaging>war</packaging> ...
- ubuntu 忘记密码如何 修改密码
ubuntu 忘记密码如何 修改密码 这个链接讲的很不错 https://blog.csdn.net/zd147896325/article/details/81664558 本来我只是玩一玩,但是我 ...
- Django学习(2.2.1版本)
项目技术重难点分析: 模型层:模型是您的数据唯一而且准确的信息来源.它包含您正在储存的数据的重要字段和行为.一般来说,每一个模型都映射一个数据库表. 每各模型都是一个python的类,这些类继承 d ...