
Flume原理分析与使用案例
正文前先来一波福利推荐:
福利一:
百万年薪架构师视频,该视频可以学到很多东西,是本人花钱买的VIP课程,学习消化了一年,为了支持一下女朋友公众号也方便大家学习,共享给大家。
福利二:
毕业答辩以及工作上各种答辩,平时积累了不少精品PPT,现在共享给大家,大大小小加起来有几千套,总有适合你的一款,很多是网上是下载不到。
获取方式:
微信关注 精品3分钟 ,id为 jingpin3mins,关注后回复 百万年薪架构师 ,精品收藏PPT 获取云盘链接,谢谢大家支持!
------------------------正文开始---------------------------
1、flume的特点:
flume是一个分布式、可靠、和高可用的海量日志采集、聚合和传输的系统。支持在日志系统中定制各类数据发送方,用于收集数据;同时,Flume提供对数据进行简单处理,并写到各种数据接受方(比如文本、HDFS、Hbase等)的能力 。
flume的数据流由事件(Event)贯穿始终。Event是Flume的基本数据单位,它携带日志数据(字节数组形式)并且携带有头信息,这些Event由Agent外部的Source生成,当Source捕获事件后会进行特定的格式化,然后Source会把事件推入(单个或多个)Channel中。你可以把Channel看作是一个缓冲区,它将保存事件直到Sink处理完该事件。Sink负责持久化日志或者把事件推向另一个Source。
flume的可靠性 :
当节点出现故障时,日志能够被传送到其他节点上而不会丢失。Flume提供了三种级别的可靠性保障,从强到弱依次分别为:end-to-end(收到数据agent首先将event写到磁盘上,当数据传送成功后,再删除;如果数据发送失败,可以重新发送。),Store on failure(这也是scribe采用的策略,当数据接收方crash时,将数据写到本地,待恢复后,继续发送),Besteffort(数据发送到接收方后,不会进行确认)。
flume的可恢复性:
还是靠Channel。推荐使用FileChannel,事件Event持久化在本地文件系统里(性能较差)。
flume的一些核心概念:
Agent使用JVM 运行Flume。每台机器运行一个agent,但是可以在一个agent中包含多个sources和sinks。
Client生产数据,运行在一个独立的线程。
Source从Client收集数据,传递给Channel。
Sink从Channel收集数据,运行在一个独立线程。
Channel连接 sources 和 sinks ,这个有点像一个队列。
Events可以是日志记录、 avro 对象等。
Flume以agent为最小的独立运行单位。一个agent就是一个JVM。单agent由Source、Sink和Channel三大组件构成,如下图:
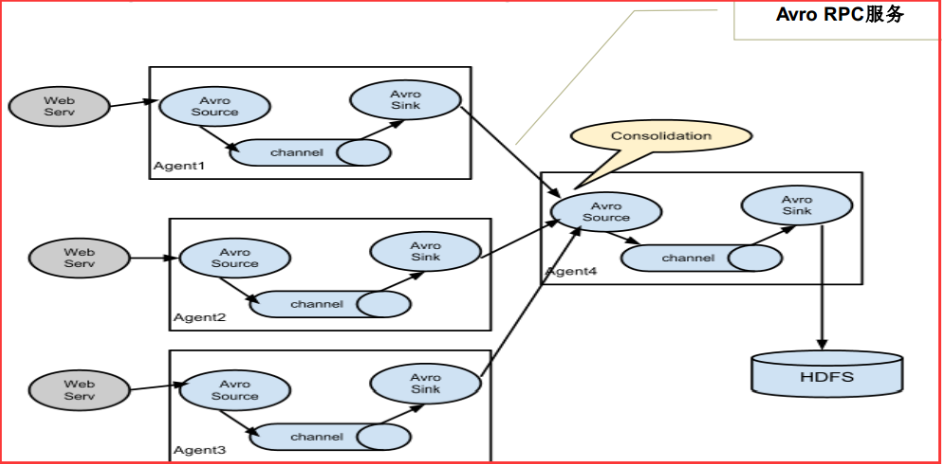
值得注意的是,Flume提供了大量内置的Source、Channel和Sink类型。不同类型的Source、Channel和Sink可以自由组合。组合方式基于用户设置的配置文件,非常灵活。比如:Channel可以把事件暂存在内存里,也可以持久化到本地硬盘上。Sink可以把日志写入HDFS, HBase,甚至是另外一个Source等等。Flume支持用户建立多级流,也就是说,多个agent可以协同工作,并且支持Fan-in、Fan-out、Contextual Routing、Backup Routes,这也正是NB之处。如下图所示:
2、flume的案例
Spool 监测配置的目录下新增的文件,并将文件中的数据读取出来。需要注意两点:
1) 拷贝到spool目录下的文件不可以再打开编辑。
2) spool目录下不可包含相应的子目录。
############################################
(a)log4j配置:
我使用log4j的DailyRollingFileAppender去每分钟生成一个日志到配置的目录下,代码如下:
#输出信息到文件

log4j.appender.file = org.apache.log4j.DailyRollingFileAppender

#这个是生成日志文件的目录及文件名

log4j.appender.file.File = /Users/jsj/eclipse-workspace/log4j/src/main/java/testlog.log

log4j.appender.file.Append = true

#每分钟产生一个日志文件

#当前的文件名是testlog.log,前面分钟产生的文件是这种命名形式testlog.log.2018-08-20-18-16。

log4j.appender.file.DatePattern = '.'yyyy-MM-dd-HH-mm

log4j.appender.file.layout = org.apache.log4j.PatternLayout

log4j.appender.file.layout.ConversionPattern = [%-5p]   %-d{yyyy-MM-dd HH:mm:ss}    %m%n
(b)模拟产生日志:
日志的内容(不含log4j中的配置)为:0a58f82b-ff6f-4feb-abe2-7c6ac9a0c24d####ERH####qhp####6677062格式为:用户ID--县号--镇号--收入
public class Main {

    public static void main(String[] args) throws Exception {

        Thread thread = new Thread(new GenerateRecord());

        thread.start();

    }

}

class GenerateRecord extends Thread {

    private final Logger log = Logger.getLogger(GenerateRecord.class);

    public void run() {

        while (true) {

            // 随机产生一个用户uuid

            UUID userId = UUID.randomUUID();

            System.out.println(userId.toString().length());

            // 产生一个随机的用户总资产

            int num = (int) (Math.random() * 10000000) + 100000;

            // 产生一个随意的县名

            StringBuilder sb = new StringBuilder();

            for (int i = 0; i < 3; i++) {

                char a = (char) (Math.random() * (90 - 65) + 65);

                sb.append(a);

            }

            String county = sb.toString();

            // 产生一个随机的镇名

            StringBuilder sb1 = new StringBuilder();

            for (int i = 0; i < 3; i++) {

                char a = (char) (Math.random() * (122 - 97) + 97);

                sb1.append(a);

            }

            String town = sb1.toString();

            // 生成日志

            log.info(userId + "####" + county + "####" + town + "####" + num);

            // 停1秒钟

            try {

                Thread.sleep(1000);

            } catch (InterruptedException e) {

                e.printStackTrace();

            }

        }

    }

}
在几分钟后停掉程序,在终端输入cd /Users/jsj/eclipse-workspace/log4j/src/main/java/查看生成的文件 ls -1 ,如下:

(c)创建agent配置文件:
在flume安装目录的conf/flume.conf下加入如下代码:
----------------------------------------------------------------
# my application flume configuration

#agent2是我们给agent起的名字

agent2.sources=source2

agent2.sinks=sink2

agent2.channels=channel2

#Spooling Directory

#set source2

#设置type为spooldir,这个值是flume给定的alias

agent2.sources.source2.type=spooldir

#设置监控目录,注意和前面log4j的目录不同

agent2.sources.source2.spoolDir=/Users/jsj/eclipse-workspace/logs

agent2.sources.source2.channels=channel2

agent2.sources.source2.fileHeader = false

#set sink2

agent2.sinks.sink2.type=hdfs

agent2.sinks.sink2.hdfs.path=hdfs://localhost:9000/flume

agent2.sinks.sink2.hdfs.fileType=DataStream

agent2.sinks.sink2.hdfs.writeFormat=TEXT

agent2.sinks.sink2.hdfs.rollInterval=60

agent2.sinks.sink2.channel=channel2

#设置存储到HDFS后文件的前缀

agent2.sinks.sink2.hdfs.filePrefix=%Y-%m-%d

#set channel2

#设置内存通道

agent2.channels.channel2.type=memory

agent2.channels.channel2.capacity=10000

agent2.channels.channel2.transactionCapacity=1000

agent2.channels.channel2.keep-alive=30
----------------------------------------------------------------
启动服务:
|
./flume-ng agent -c ../conf -f ../conf/flume.conf -Dflume.root.logger=INFO,console -n agent2 |
观察日志:
此时flume的终端会嗖嗖嗖的刷日志,我截下来几条,主要是打开文件,对正在处理的文件改名为.tmp后缀,上传到HDFS后把HDFS上文件的.tmp删掉,本地的监控目录下文件加.COMPLETED后缀。
观察HDFS:
这时候我们去HDFS上检查一下:新开个终端输入hadoop fs -ls /flume,发现生成了比我们文件数多的多的文件,原来只有11个,现在有62个文件。
Flume原理分析与使用案例的更多相关文章
- BASE64编码原理分析脚本实现及逆向案例
在互联网中的每一刻,你可能都在享受着Base64带来的便捷,但对于Base64的基础原理你又了解多少?今天小编带大家了解一下Base64编码原理分析脚本实现及逆向案例的相关内容. 01编码由来 数 ...
- JDK动态代理案例与原理分析
一.JDK动态代理实现案例 Person接口 package com.zhoucong.proxy.jdk; public interface Person { // 寻找真爱 void findlo ...
- Junit 注解 类加载器 .动态代理 jdbc 连接池 DButils 事务 Arraylist Linklist hashset 异常 哈希表的数据结构,存储过程 Map Object String Stringbufere File类 文件过滤器_原理分析 flush方法和close方法 序列号冲突问题
Junit 注解 3).其它注意事项: 1).@Test运行的方法,不能有形参: 2).@Test运行的方法,不能有返回值: 3).@Test运行的方法,不能是静态方法: 4).在一个类中,可以同时定 ...
- left join 原理分析
left join 原理分析 [转贴 2006-11-15 16:19:50] 字号:大 中 小 案例分析 user表: id | name --------- 1 | libk ...
- Spring Boot 实战与原理分析视频课程
Spring Boot 实战与原理分析视频课程 链接:https://pan.baidu.com/share/init?surl=PeykcoeqZtd1d9lN9V_F-A 提取码: 关注公众号[G ...
- 支付宝app支付java后台流程、原理分析(含nei wang chuan tou)
java版支付宝app支付流程及原理分析 本实例是基于springmvc框架编写 一.流程步骤 1.执行流程 当手机端app(就是你公司开发的app)在支付 ...
- java并发包&线程池原理分析&锁的深度化
java并发包&线程池原理分析&锁的深度化 并发包 同步容器类 Vector与ArrayList区别 1.ArrayList是最常用的List实现类,内部是通过数组实现的, ...
- Spring事务原理分析-部分二
Spring事务原理分析-部分二 说明:这是我在蚂蚁课堂学习了余老师Spring手写框架的课程的一些笔记,部分代码代码会用到余老师的课件代码.这不是广告,是我听了之后觉得很好. 课堂链接:Spring ...
- Spring 事件监听机制及原理分析
简介 在JAVA体系中,有支持实现事件监听机制,在Spring 中也专门提供了一套事件机制的接口,方便我们实现.比如我们可以实现当用户注册后,给他发送一封邮件告诉他注册成功的一些信息,比如用户订阅的主 ...
随机推荐
- javascript---查找节点
快捷键: chazhaojiedian(查找节点) chuangjianjiedian(创建节点) 使用childNodes childElementCount//=====以下是第一种操作D ...
- C++头文件中#pragma once与#ifndef……#define……#endif
两者功能一样,防止重复包含被多次编译.建议头文件加入#pragma once C++头文件开头的两句与结尾的一句#ifndef <标识>#define <标识>类代码#endi ...
- Java对象间的关系
1 综述 在Java中对象与对象的关系总体分为四类,分别是:依赖.关联.聚合和组合. (1)依赖(Dependency)关系是类与类之间的联接.依赖关系表示一个类依赖于另一个类的定义,一般而言,依赖关 ...
- INLINE HOOK过简单驱动保护的理论知识和大概思路
这里的简单驱动保护就是简单的HOOK掉内核API的现象 找到被HOOK的函数的当前地址在此地址处先修改页面保护属性然后写入5个字节.5个字节就是一个简单的JMP指令.这里说一下JMP指令,如下: 00 ...
- C和汇编混联合的问题
关键时刻出现了问题: 关于packed的问题,一定要注意这个问题http://stackoverflow.com/questions/4306186/structure-padding-and-str ...
- 对AM信号FFT的matlab仿真
普通调幅波AM的频谱,大信号包络检波频谱分析 u(t)=Ucm(1+macos t)cos ct ma称为调幅系数 它的频谱由载波,上下边频组成 , 包络检波中二极管截去负半周再用电容低通滤波,可 ...
- POJ3764
题目 POJ3764 The xor-longest Path 原题传送门 主要思路: 1.求出每个点到根节点(这里是树,所以直接取0)路径上所有权值xor和为d[i],则任意两点间路径xor和则为 ...
- break语句与continue语句
break:终止该层循环: continue:跳过该层循环 注: ①:若这两个语句离开应用范围,存在是没有意义的. ②:这个两个语句后面都不能有语句,因为执行不到. ③:continue语句是跳过本次 ...
- java实现自定义同步组件的过程
实现同步组件twinsLock:可以允许两个线程同时获取到锁,多出的其它线程将被阻塞. 以下是自定义的同步组件类,一般我们将自定义同步器Sync定义为同步组件TwinsLock的静态内部类. 实现同步 ...
- flutter中的生命周期函数
前言:生命周期是一个组件加载到卸载的整个周期,熟悉生命周期可以让我们在合适的时机做该做的事情,flutter中的State生命周期和android以及React Native的生命周期类似. 先看一张 ...