
Hadoop-No.5之压缩
Hadoop存储数据时需要着重考虑的一个因素就是压缩.这里不仅要满足节省存储空间的需求,也要提升数据处理性能.在处理大量数据时,消耗最大的是磁盘和网络的I/O,所以减少需要读取或者写入磁盘的数据量就能大大缩短整体处理时间.这包括数据源的压缩,它也包括数据处理过程(如MapReduce任务)中产生的中间数据的压缩.尽管压缩会增加CPU负载,但是大多数情况下,I/O上的节省仍然大于增加的CPU负载
压缩能够极大地优化处理性能,但是Hadoop支持的压缩格式并不都是可以分片的.MapReduce框架先将数据分片,然后在输入多个任务,所以不支持分片的压缩格式对于数据的高效处理极为不利.如果文件不可分片,哪就意味着需要将整个文件输入到一个单独的MapReduce任务,根本无法利用Hadoop提供的大规模并行以及数据本地化优势.因此,在选择压缩格式与文件格式时,是否支持分片是一个重要的考虑因素.
Snappy
Snappy是Google开发的一种压缩编解码器,用于实现高速压缩,适当兼顾压缩率.虽然压缩率不算突出,但是Snappy能够较好的平衡压缩速度和大小.Snappy的处理性能显著优于其他压缩格式.值得注意到是,使用Snappy压缩的文件不是可分片的,所以他要与容器格式(如SequenceFile和Avro)联合使用
LZO
与Snappy类似,LZO也具有较好的压缩速度,单压缩率略显平庸.与Snappy不同的是,使用LZO压缩的文件可分片,不过这里要求建立索引.如果纯文本文件不存储到容器格式中,那么使用LZO是一个不错的选择.有一点需要注意的是,LZO的许可协议不允许将其打包到Hadoop中进行分发,因此需要单独安装.Snappy则不同,它可以与Hadoop一起分发.
Gzip
Gzip的压缩性能非常好,平均来讲,可以达到Snappy的2.5倍.但是他的写入速度不如Snappy,平均为Snappy的一半.在读取性能上.Gzip通常与Snappy相差不.Gzip同样是不可分片的,所以应该与容器格式联合使用呢.请注意,Gzip处理数据有时回避Snappy慢,原因在于Gzip压缩文件需要的数据块较少,所以处理限购他那个数据所需的任务就更少,因此,使用Gzip时选择较小的数据块,可以达到更好的性能.
bzip2
bzip2的压缩性能很优越,但是处理性能明显比其他压缩编解码格式(如Snappy)要差.与Snappy与Gzip不同,bzip2本身为可分片式.通常来说bzip2会比Gzip慢10倍.因此bzip2在Hadoop中并不是理想的编辑阿妈格式,除非主要的需求就是减少存储空间占用量,例如在线归档时使用的Hadoop的场景
压缩算法推荐
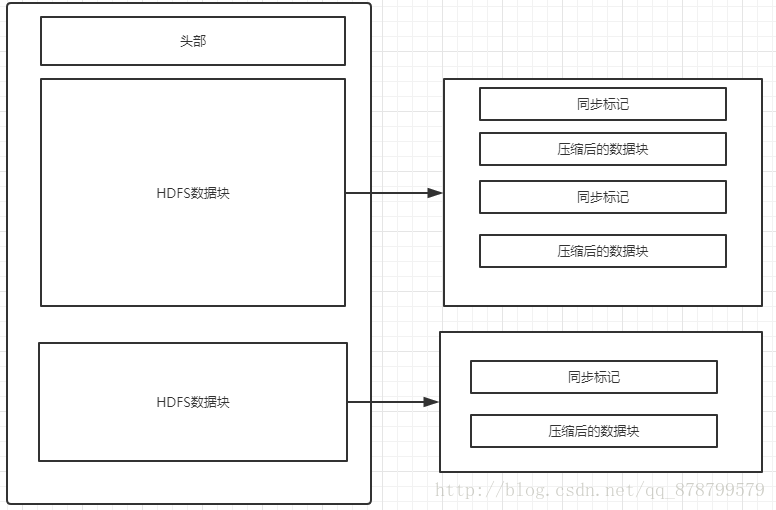
一般来说,在与容器文件格式(Avro,SequenceFile等)一起使用时,任何压缩格式都可以是分片式的,因为容器文件格式能够单独压缩记录构成的数据块,也可以进行记录级的压缩.如果在压缩整个文件时没有使用容器文件格式,那么就需要使用本身支持可分片的压缩格式,比如在数据块之间插入同步标记的Bzip2
以下是在Hadoop中进行压缩的一些建议.
- 开启MapReduce中间数据的输出压缩.这样可以减少需要读取和写入磁盘的中间数据,进而提高了性能.
- 注意数据是如何排序的.通常来讲,数据应当排序,相似的数据要放在一起,这样压缩效率更高.
- 考虑使用支持可分片的压缩算法的紧凑文件格式,如Avro.下图展示了使用不可分片压缩算法的Avro或SequenceFile支持文件分片的方法.
Hadoop-No.5之压缩的更多相关文章
- hadoop深入研究:(七)——压缩
转载请标明出处:hadoop深入研究:(七)——压缩 文件压缩主要有两个好处,一是减少了存储文件所占空间,另一个就是为数据传输提速.在hadoop大数据的背景下,这两点尤为重要,那么我现在就先来了解下 ...
- Hadoop基础-SequenceFile的压缩编解码器
Hadoop基础-SequenceFile的压缩编解码器 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Hadoop压缩简介 1>.文件压缩的好处 第一:较少存储文件占用 ...
- hadoop中MapReduce中压缩的使用及4种压缩格式的特征的比较
在比较四中压缩方法之前,先来点干的,说一下在MapReduce的job中怎么使用压缩. MapReduce的压缩分为map端输出内容的压缩和reduce端输出的压缩,配置很简单,只要在作业的conf中 ...
- 我是如何利用Hadoop做大规模日志压缩的
背景 刚毕业那几年有幸进入了当时非常热门的某社交网站,在数据平台部从事大数据开发相关的工作.从日志收集.存储.数据仓库建设.数据统计.数据展示都接触了一遍,比较早的赶上了大数据热这波浪潮.虽然今天的人 ...
- Hadoop编码解码【压缩解压缩】机制详解(1)
想想一下,当你需要处理500TB的数据的时候,你最先要做的是存储下来.你是选择源文件存储呢?还是处理压缩再存储?很显然,压缩编码处理是必须的.一段刚刚捕获的60分钟原始视屏可能达到2G,经过压缩处理可 ...
- Hadoop编码解码【压缩解压缩】机制具体解释(1)
想想一下,当你须要处理500TB的数据的时候,你最先要做的是存储下来. 你是选择源文件存储呢?还是处理压缩再存储?非常显然,压缩编码处理是必须的.一段刚刚捕获的60分钟原始视屏可能达到2G,经过压缩处 ...
- [大牛翻译系列]Hadoop(18)MapReduce 文件处理:基于压缩的高效存储(一)
5.2 基于压缩的高效存储 (仅包括技术25,和技术26) 数据压缩可以减小数据的大小,节约空间,提高数据传输的效率.在处理文件中,压缩很重要.在处理Hadoop的文件时,更是如此.为了让Hadoop ...
- hive 压缩全解读(hive表存储格式以及外部表直接加载压缩格式数据);HADOOP存储数据压缩方案对比(LZO,gz,ORC)
数据做压缩和解压缩会增加CPU的开销,但可以最大程度的减少文件所需的磁盘空间和网络I/O的开销,所以最好对那些I/O密集型的作业使用数据压缩,cpu密集型,使用压缩反而会降低性能. 而hive中间结果 ...
- Hadoop压缩的图文教程
近期由于Hadoop集群机器硬盘资源紧张,有需求让把 Hadoop 集群上的历史数据进行下压缩,开始从网上查找的都是关于各种压缩机制的对比,很少有关于怎么压缩的教程(我没找到..),再此特记录下本次压 ...
- 查看hadoop压缩方式
bin/hadoop checknative 来查看我们编译之后的hadoop支持的各种压缩,如果出现openssl为false,那么就在线安装一下依赖包 bin/hadoop checknativ ...
随机推荐
- Centos7 下安装docker
Docker 运行在 CentOS 7 上,要求系统为64位.系统内核版本为 3.10 以上. Docker 运行在 CentOS-6.5 或更高的版本的 CentOS 上,要求系统为64位.系统内核 ...
- 【转】nosql的分类
1 键值数据库 相关产品:Redis.Riak.SimpleDB.Chordless.Scalaris.Memcached 形式:Key 指向 Value 的键值对,通常用hash table来实现 ...
- Linux就该这么学——新手必须掌握的命令之常用的系统工作命令
echo命令 含义:echo命令用于在终端输出字符串或变量提取后的值,格式为 : echo [字符串|$变量] 示例: 将”Linuxprobe.com”输出到终端屏幕的命令为: [root@linu ...
- 二维数组(解引用、指针数组、数组的指针)——C语言
二维数组 在说二维数组前先来说下一维数组中的指针数组和和数组的指针 一.一维数组中指针数组和数组指针的区别 指针数组: ]; []的优先级比*高,首先它是一个数组,它的大小是5,它里面存放的数据类型是 ...
- JavaScript的几种循环方式
JavaScript提供了许多通过LOOPS迭代的方法.本教程解释了现代JAVASCRIPT中各种各样的循环可能性 目录: for forEach do...while while for...in ...
- Censoring(栈+KMP)
# 10048. 「一本通 2.2 练习 4」Censoring [题目描述] 给出两个字符串 $S$ 和 $T$,每次从前往后找到 $S$ 的一个子串 $A=T$ 并将其删除,空缺位依次向前补齐,重 ...
- pb datawindow的用法
1. 使DataWindow列只能追加不能修改如何使DataWindow中的数据只能追加新记录而不能修改,利用 Column 的 Protect 属性可以很方便的做到这一点,方法如下:将每一列的 Pr ...
- web框架链接
django系列教程(优):https://www.cnblogs.com/feixuelove1009/p/5823135.html
- python2.7学习笔记——菜鸟教程
标准数据类型 Numbers(数字) String(字符串) List(列表) Tuple(元组) Dictionary(字典) list = [ 'runoob', 786 , 2.23, 'joh ...
- 11-Perl 运算符
1.Perl 运算符运算符是一种告诉编译器执行特定的数学或逻辑操作的符号,如: 3+2=5.Perl 语言内置了丰富的运算符,我们来看下常用的几种: 算术运算符,比较运算符,逻辑运算符,赋值运算符,位 ...