
STM32 MCU一次计算优化和提速
1、背景
STM32 MCU对25.6Kb数据进行压缩,丢掉每个数据的低4位然后2个字节拼接为1个字节。发现处理耗时竞达1ms以上,于是开始进行优化,最后达到200us的效果,提速5倍以上。
2、优化
2.1优化前
  HAL_GPIO_WritePin(TestPB12_GPIO_Port, TestPB12_Pin, );

  #if (USE_BINNING)

   ImgCompressTo4Bit(img_ptr + PACKAGE_HEADER_SIZE, ImgSampBuf, IMG_SIZE);

  #else

    memcpy(img_ptr + PACKAGE_HEADER_SIZE, ImgSampBuf, IMG_SIZE);

  #endif

  HAL_GPIO_WritePin(TestPB12_GPIO_Port, TestPB12_Pin, );
该处理过程耗时1ms60us。

2.2 第一次优化
考虑到过多的for循环,会导致效率变低,于是一次处理4个字节。
/**

 * @brief compress a arrary with high 4bit and low 4bit.

 * @param[out]      *pDst arrary to be filled

 * @param[in]       *pSrc input arrary

 * @param[in]       len src length

 * @return   dst length.

 *

 */

int ImgCompressTo4Bit(uint8_t *pDst, uint8_t *pSrc, int srcLen)

{

  /*loop Unrolling */

  uint32_t dstLen = srcLen >> ;

  uint32_t blkCnt = dstLen >> 2u;

  uint32_t halfOffset = dstLen;

  uint8_t * ptrHigh = pSrc; // high 4 bit

  uint8_t * ptrLow  = pSrc + halfOffset; // low 4 bit

  while(blkCnt > 0u)

  {

    *pDst++ = ((*ptrHigh++) & 0xF0) | (((*ptrLow++) & 0xF0)>>);

    *pDst++ = ((*ptrHigh++) & 0xF0) | (((*ptrLow++) & 0xF0)>>);

    *pDst++ = ((*ptrHigh++) & 0xF0) | (((*ptrLow++) & 0xF0)>>);

    *pDst++ = ((*ptrHigh++) & 0xF0) | (((*ptrLow++) & 0xF0)>>);

    blkCnt--;

  }

  blkCnt = dstLen % 0x4u;

  while(blkCnt > 0u)

  {

    *pDst++ = ((*ptrHigh++) & 0xF0) | (((*ptrLow++) & 0xF0)>>);

    blkCnt--;

  }

  return dstLen;

}
优化后:一次处理4个数据时间为640us。如果进一步 一次处理8个数据,时间为600us。

2.3 第二次优化
考虑到MCU是32位机器,那么使用u32类型数据进行处理,可以提高效率。
int ImgCompressTo4Bit(uint8_t *pDst, uint8_t *pSrc, int srcLen)

{

  /*loop Unrolling */

  uint32_t dstLen = srcLen >> ;

  uint32_t blkCnt = dstLen >> 2u;

  uint32_t halfOffset = dstLen;

  uint32_t * ptrHigh = (uint32_t*)pSrc; // high 4 bit

  uint32_t * ptrLow  = (uint32_t*)(pSrc + halfOffset); // low 4 bit

  uint32_t * dst  = (uint32_t*)pDst;

  while(blkCnt > 0u)

  {

    *dst++ = ((*ptrHigh++) & 0xF0F0F0F0) | (((*ptrLow++) & 0xF0F0F0F0)>>);

    blkCnt--;

  }

  blkCnt = dstLen % (0x4u);

  while(blkCnt > 0u)

  {

    *dst++ = ((*ptrHigh++) & 0xF0F0F0F0) | (((*ptrLow++) & 0xF0F0F0F0)>>);

    blkCnt--;

  }

  return dstLen;

}
优化后速度达到240us。

2.4 第三次优化
同样考虑降低for循环的次数,一次处理4个u32,实际上是16个字节的数据。
int ImgCompressTo4Bit(uint8_t *pDst, uint8_t *pSrc, int srcLen)

{

  /*loop Unrolling */

  uint32_t dstLen = srcLen >> ;

  uint32_t blkCnt = dstLen >> 2u >> 2u;

  uint32_t halfOffset = dstLen;

  uint32_t * ptrHigh = (uint32_t*)pSrc; // high 4 bit

  uint32_t * ptrLow  = (uint32_t*)(pSrc + halfOffset); // low 4 bit

  uint32_t * dst  = (uint32_t*)pDst;

  while(blkCnt > 0u)

  {

    *dst++ = ((*ptrHigh++) & 0xF0F0F0F0) | (((*ptrLow++) & 0xF0F0F0F0)>>);

    *dst++ = ((*ptrHigh++) & 0xF0F0F0F0) | (((*ptrLow++) & 0xF0F0F0F0)>>);

    *dst++ = ((*ptrHigh++) & 0xF0F0F0F0) | (((*ptrLow++) & 0xF0F0F0F0)>>);

    *dst++ = ((*ptrHigh++) & 0xF0F0F0F0) | (((*ptrLow++) & 0xF0F0F0F0)>>);

    blkCnt--;

  }

  blkCnt = dstLen % (0x4u*0x4u);

  while(blkCnt > 0u)

  {

    *dst++ = ((*ptrHigh++) & 0xF0F0F0F0) | (((*ptrLow++) & 0xF0F0F0F0)>>);

    blkCnt--;

  }

  return dstLen;

}
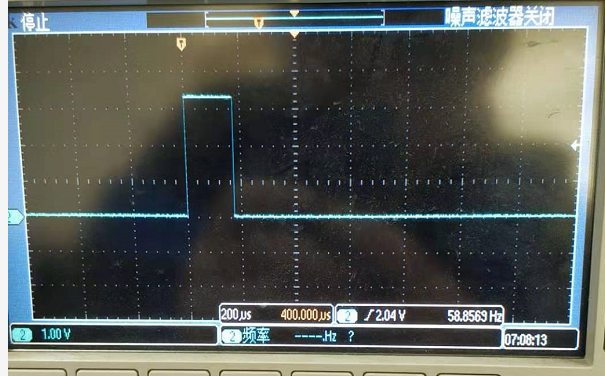
优化后速度达到180--200us左右。
3、总结
基于c语法的优化:减少循环处理的次数。
基于芯片特性的优化:使用u32数据,提高处理效率。
经过3次简单的优化,1ms60us的处理降低到200us实现原有的操作。
STM32 MCU一次计算优化和提速的更多相关文章
- 如何获取STM32 MCU的唯一ID
前段时间由于应用需要对产品授权进行限制,所以研究了一下有关STM32 MCU的唯一ID的资料,并最终利用它实现了我们的目标. 1.基本描述 在STM32的全系列MCU中均有一个96位的唯一设备标识符. ...
- 基于STM32的uCGUI移植和优化
基于STM32的uCGUI移植和优化 首先在开始这个说明之前,要简要说明下具体的环境: 编译工具:MDK4.20 开发板:安富莱v2版开发板 调试器:JLink v8盗版 移植篇 相信大家有移植经验 ...
- STM32 程序所占用空间计算 && FLASH存储的起始地址计算
程序编译完成,会乘车program size .. 对STM32容量选型或者 计算FLASH 充当EEPROM起始地址时会用到此参数. 按照下面截图 程序空间 = (16700+732+4580)/ ...
- appium-基础搭建,适配,问题,优化,提速
搭建开发环境,导入testng/log4j/maven 1.配置jdk环境 2.安装appium,下载eclipse-adt,配置appium环境 github.com/getlantern/foru ...
- 如何获取STM32 MCU的唯一ID及应用(转)
源: 如何获取STM32 MCU的唯一ID
- MyEclipse6.5的速度性能优化大提速(转)
MyEclipse是Eclipse的插件,也是一款功能强大的J2EE集成开发环境,支持代码编写.配置.测试以及除错.现在看一下MyEclipse6.5版本的速度性能优化大提速.优化MyEclipse6 ...
- 2019牛客多校第二场F Partition problem 暴力+复杂度计算+优化
Partition problem 暴力+复杂度计算+优化 题意 2n个人分成两组.给出一个矩阵,如果ab两个在同一个阵营,那么就可以得到值\(v_{ab}\)求如何分可以取得最大值 (n<14 ...
- 递归、尾递归和使用Stream延迟计算优化尾递归
我们在学数据结构的时候必然会接触栈(Stack),而栈有一个重要的应用是在程序设计语言中实现递归.递归用途十分广泛,比如我们常见的阶乘,如下代码: 1234 public static int (in ...
- 谈反应式编程在服务端中的应用,数据库操作优化,提速 Upsert
反应式编程在客户端编程当中的应用相当广泛,而当前在服务端中的应用相对被提及较少.本篇将介绍如何在服务端编程中应用响应时编程来改进数据库操作的性能. 开篇就是结论 接续上一篇<谈反应式编程在服务端 ...
随机推荐
- zhengrui集训D1-D5笔记
Day_1 计数 它咕掉了 Day_1 序列数据结构 它咕掉了 Day_2 线性代数 高斯消元\Large{高斯消元}高斯消元 普通版:略 模质数:求逆 模合数:exgcd 逆矩阵\Large{逆矩阵 ...
- vue文件夹上传插件选哪个好?
文件夹数据库处理逻辑 public class DbFolder { JSONObject root; public DbFolder() { this.root = new JSONObject() ...
- Java 相同类型强制转换异常
版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接和本声明. 本文链接:https://blog.csdn.net/u010750497/article/det ...
- mysql 常见ALTER TABLE操作
删除列 alter table table-name drop col-name; 增加列(单列) alter table table-name add col-name col-type comme ...
- percona-toolkit 主从工具 master-slave
复制类 pt-heartbeat 监控mysql复制延迟 pt-slave-delay 设定从落后主的时间 pt-slave-find 查找和打印所有mysql复制层级关系 pt-slav ...
- 做uart 实验时,run configure 只能选择jtag_uart 而没有uart
使用的是nios ii 13 版本.直接在nios 软件上运行时程序能够执行,其中已经配置了stdin stderr stdout为jtag_uart.run configure 里面的byte st ...
- Dockerfile创建tomcat和jdk,并发布java项目
1.准备好需要的jdk 和 tomcat kun@ubuntu:~$ cd tomcat-docker/ kun@ubuntu:~/tomcat-docker$ ll total drwxrwxr-x ...
- cyk追楠神系列一(SDUT3703)
cyk追楠神系列一 Time Limit: 1000 ms Memory Limit: 65536 KiB Submit Statistic Problem Description 众所周知,cyk ...
- python 多线程_thread
import _thread import time def print_time(threadName, delay, iterations): start = int(time.time()) , ...
- AcWing:241. 楼兰图腾(树状数组逆序对)
在完成了分配任务之后,西部314来到了楼兰古城的西部. 相传很久以前这片土地上(比楼兰古城还早)生活着两个部落,一个部落崇拜尖刀(‘V’),一个部落崇拜铁锹(‘∧’),他们分别用V和∧的形状来代表各自 ...