
ms_celeb_1m数据提取(MsCelebV1-Faces-Aligned.tsv)python脚本
本文主要介绍了如何对MsCelebV1-Faces-Aligned.tsv文件进行提取
原创by南山南北秋悲
欢迎引用!请注明原地址 http://www.cnblogs.com/hwd9654/p/6796811.html 谢谢!
最近用caffe做人脸识别,一开始用lfw作为数据库,但是体量太小,只有五千多人的图片
后来想用李子青组的casia-webface,从网上找了个,下下来发现居然损坏了,好气啊! 想去官网申请,却发现!!!:
- Sign the agreement (The agreement must be signed by the director or the delegate of the deparmart of university. Personal applicant is not acceptable.
。。。。。。不接受个人申请,而lz的学院领导不给签字 - -
后来索性就直接拿微软的ms celeb 1m来训练
简介如下:官网地址(https://www.microsoft.com/en-us/research/project/ms-celeb-1m-challenge-recognizing-one-million-celebrities-real-world/)
MSR IRC是目前世界上规模最大、水平最高的图像识别赛事之一,由MSRA(微软亚洲研究院)图像分析、大数据挖掘研究组组长张磊发起
ms_celeb_1m就是这个比赛的数据集
从1M个名人中,根据他们的受欢迎程度,选择100K个。然后,利用搜索引擎,给100K个人,每人搜大概100张图片。共100K*100=10M个图片。
有三种下载选项:
1.完整版
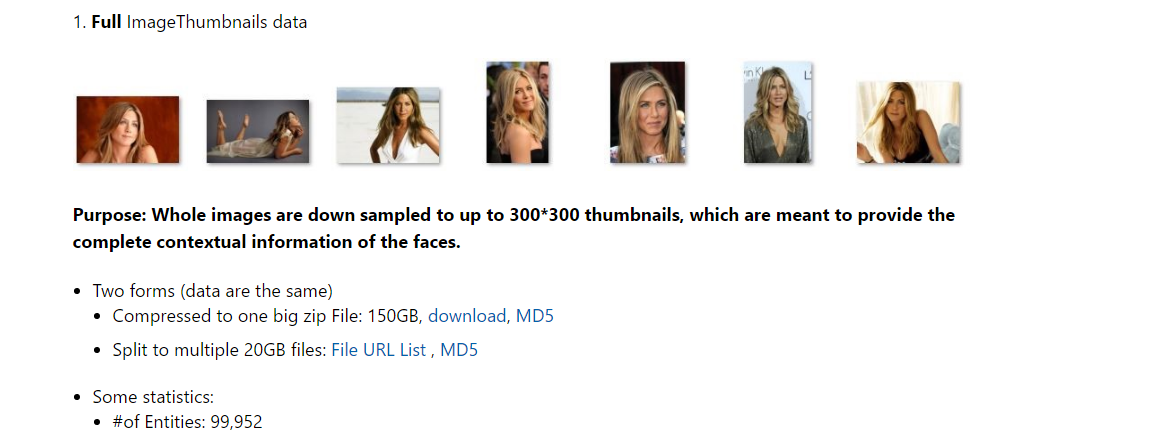
需要自己预处理,人脸检测,人脸对齐。。。
2.微处理版,修剪了一下
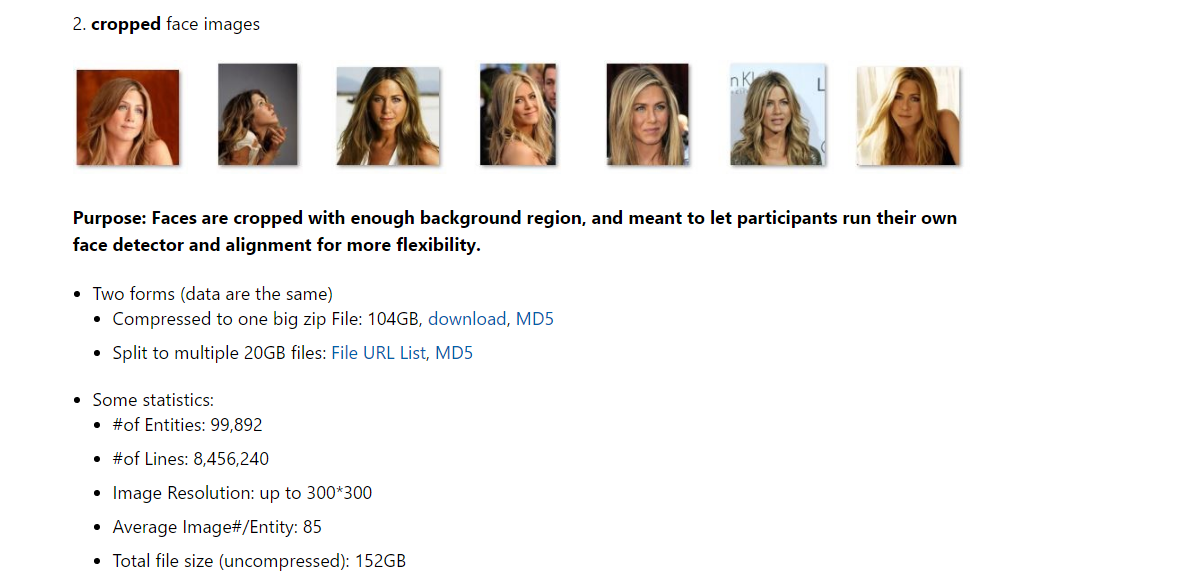
3.对齐过的版本
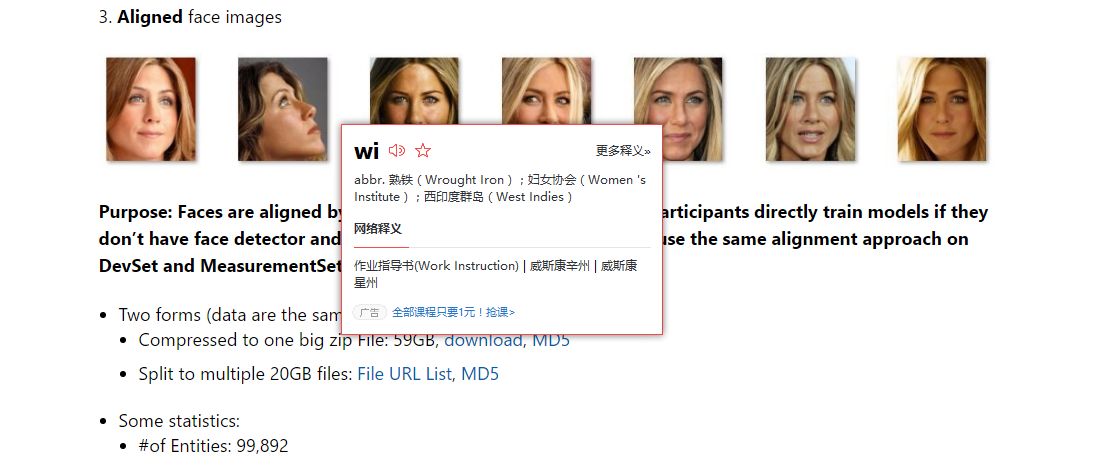
楼主用的是第三个对齐过的版本
下载下来是这么个玩意儿

好了废话不多说
直接上处理脚本
import base64

import csv

import os

filename = "J:\dataset\ms_celeb_1m\MsCelebV1-Faces-Aligned.tsv"

outputDir = "I:\ms_celeb_1m"

with open(filename, 'r') as tsvF:

    reader = csv.reader(tsvF, delimiter='\t')

    i = 0

    for row in reader:

        MID, imgSearchRank, faceID, data = row[0], row[1], row[4], base64.b64decode(row[-1])

        saveDir = os.path.join(outputDir, MID)

        savePath = os.path.join(saveDir, "{}-{}.jpg".format(imgSearchRank, faceID))

        if not os.path.exists(saveDir):

            os.mkdir(saveDir)

        with open(savePath, 'wb') as f:

            f.write(data)

        i += 1

        if i % 1000 == 0:

            print("Extracted {} images.".format(i))
自己改下相应路径就可以用了
处理结果:

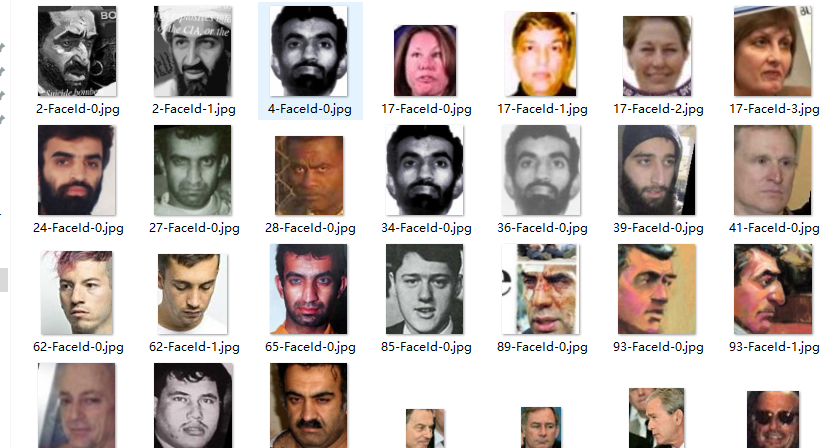
有什么疑问可以留言,不定期查看,慢回勿喷。。。
ms_celeb_1m数据提取(MsCelebV1-Faces-Aligned.tsv)python脚本的更多相关文章
- 使用Python脚本分析你的网站上的SEO元素
撰稿马尼克斯德芒克 上2019年1月, Sooda internetbureau Python就是自动执行重复性任务,为您的其他搜索引擎优化(SEO)工作留出更多时间.没有多少SEO使用Python来 ...
- 记录特殊情况的Python脚本的内存异常与处理
问题 Python 脚本使用 requests 模块做 HTTP 请求,验证代理 IP 的可用性,速度等. 设定 HTTP 请求的 connect timeout 与 read response ti ...
- Python爬虫10-页面解析数据提取思路方法与简单正则应用
GitHub代码练习地址:正则1:https://github.com/Neo-ML/PythonPractice/blob/master/SpiderPrac15_RE1.py 正则2:match. ...
- python 爬虫与数据可视化--数据提取与存储
一.爬虫的定义.爬虫的分类(通用爬虫.聚焦爬虫).爬虫应用场景.爬虫工作原理(最后会发一个完整爬虫代码) 二.http.https的介绍.url的形式.请求方法.响应状态码 url的形式: 请求头: ...
- 【学习】Python进行数据提取的方法总结【转载】
链接:http://www.jb51.net/article/90946.htm 数据提取是分析师日常工作中经常遇到的需求.如某个用户的贷款金额,某个月或季度的利息总收入,某个特定时间段的贷款金额和笔 ...
- Python爬虫教程-18-页面解析和数据提取
本篇针对的数据是已经存在在页面上的数据,不包括动态生成的数据,今天是对HTML中提取对我们有用的数据,去除无用的数据 Python爬虫教程-18-页面解析和数据提取 结构化数据:先有的结构,再谈数据 ...
- Python——爬虫——数据提取
一.XML数据提取 (1)定义:XML指可扩展标记语言.标记语言,标签需要我们自行定义 (2)设计宗旨:是传输数据,而非显示数据,具有自我描述性 (3)节点关系: 父:每个元素及属性都有一个父. ...
- python爬虫数据提取之bs4的使用方法
Beautiful Soup的使用 1.下载 pip install bs4 pip install lxml # 解析器 官方推荐 2.引用方法 from bs4 import BeautifulS ...
- 【转载】使用Pandas进行数据提取
使用Pandas进行数据提取 本文转载自:蓝鲸的网站分析笔记 原文链接:使用python进行数据提取 目录 set_index() ix 按行提取信息 按列提取信息 按行与列提取信息 提取特定日期的信 ...
随机推荐
- 10分钟精通SharePoint - SharePoint安装
简介 接触SharePoint就避免不了要接触SharePoint安装,无论你是对SharePoint进行开发还是管理(终端用户除外).SharePoint的安装涉及到两部分:预装.安装和配置,这主要 ...
- 如何javascript获取css中的样式
obj.style.height只能获取行间样式,但是我们要怎么获取写在css文件中的样式呢? 首先我们要用一个新的方法currentStyle.这个方法由current和style两个单词组成意思是 ...
- postman定义公共函数
对于postman定义公共函数,相信很多小伙伴并不是很了解,下面给大家带来了一点福利,一起来看看吧.1.判断是否超时(assertNotTimeout)
- web works importScripts
html: <!DOCTYPE html> <html> <head> <meta charset="utf-8"> <tit ...
- java安装1335错误解决办法(亲测)
心血来潮想了解一下java,结果一开始就碰到了让心"恶心"的1335错误. 废话不多说,直接看下面: 你可以先尝试在这个链接下载java.exe文件 http://www.orac ...
- Android学习笔记---前传
在正式的撰写个人的学习笔记前,先对个人的学习经历做一个简要的介绍.座右铭:诚不欺我 1. 前言 本人非软件工程出身,属于半路出家,误打误撞进入这个行业,初心是软件开发的门槛低,自以为学习过C语言,轻度 ...
- javaScriptCore 实战 与 小结
源码在这,看不懂的直接撸源码就行,转载声明出处 原生调用JS的大致流程,做了个思维简图 这是代码流程 // JS数据 func getJSVar() { let context: JSContex ...
- Asp.net SignalR 应用并实现群聊功能 开源代码
ASP.NET SignalR 是为 ASP.NET 开发人员提供的一个库,可以简化开发人员将实时 Web 功能添加到应用程序的过程.实时 Web 功能是指这样一种功能:当所连接的客户端变得可用时服务 ...
- [原]C#与非托管——封送和自动封送
之前说到了如何从C函数声明通过简单的查找替换生成一份C#的静态引用声明(C#与非托管——初体验),因为只是简单说明,所以全部采用的是基础类型匹配和自动封送.自动封送虽然能省去我们不少编码时间,但如果不 ...
- 老李分享:使用 Python 的 Socket 模块开发 UDP 扫描工具
老李分享:使用 Python 的 Socket 模块开发 UDP 扫描工具 poptest是业内唯一的测试开发工程师培训机构,测试开发工程师主要是为测试服务开发测试工具,在工作中要求你做网络级别的安全 ...