
Python爬虫入门:Urllib库的基本使用
1.分分钟扒一个网页下来
怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器解释才呈现出来的,实质它 是一段HTML代码,加 JS、CSS,如果把网页比作一个人,那么HTML便是他的骨架,JS便是他的肌肉,CSS便是它的衣服。所以最重要的部分是存在于HTML中的,下面我 们就写个例子来扒一个网页下来。
Python
|
1 2 3 4 |
#设置代理IP #代理IP可以上http://zhimaruanjian.com/获取 import urllib2 response = urllib2.urlopen("http://www.baidu.com") print response.read() |
是的你没看错,真正的程序就两行,把它保存成 demo.py,进入该文件的目录,执行如下命令查看运行结果,感受一下。
Python
|
1 |
python demo.py |
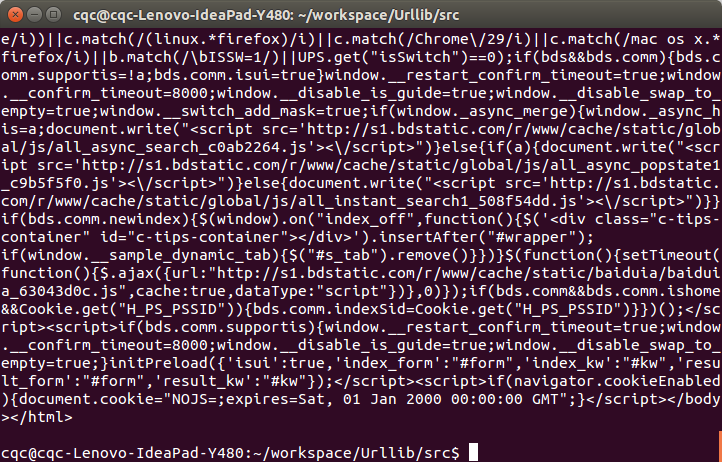
看,这个网页的源码已经被我们扒下来了,是不是很酸爽?
2.分析扒网页的方法
那么我们来分析这两行代码,第一行
Python
|
1 |
response = urllib2.urlopen("http://zhimaruanjian.com/") |
首先我们调用的是urllib2库里面的urlopen方法,传入一个URL,这个网址是百度首页,协议是HTTP协议,当然你也可以把HTTP换做FTP,FILE,HTTPS 等等,只是代表了一种访问控制协议,urlopen一般接受三个参数,它的参数如下:
Python
|
1 |
urlopen(url, data, timeout) |
第一个参数url即为URL,第二个参数data是访问URL时要传送的数据,第三个timeout是设置超时时间。
第二三个参数是可以不传送的,data默认为空None,timeout默认为 socket._GLOBAL_DEFAULT_TIMEOUT
第一个参数URL是必须要传送的,在这个例子里面我们传送了百度的URL,执行urlopen方法之后,返回一个response对象,返回信息便保存在这里面。
Python
|
1 |
print response.read() |
response对象有一个read方法,可以返回获取到的网页内容。
如果不加read直接打印会是什么?答案如下:
Python
|
1 |
<addinfourl at 139728495260376 whose fp = <socket._fileobject object at 0x7f1513fb3ad0>> |
直接打印出了该对象的描述,所以记得一定要加read方法,否则它不出来内容可就不怪我咯!
3.构造Requset
其实上面的urlopen参数可以传入一个request请求,它其实就是一个Request类的实例,构造时需要传入Url,Data等等的内容。比如上面的两行代码,我们可以这么改写
Python
|
1 2 3 4 5 |
import urllib2 request = urllib2.Request("http://zhimaruanjian.com/") response = urllib2.urlopen(request) print response.read() |
运行结果是完全一样的,只不过中间多了一个request对象,推荐大家这么写,因为在构建请求时还需要加入好多内容,通过构建一个request,服务器响应请求得到应答,这样显得逻辑上清晰明确。
4.POST和GET数据传送
上面的程序演示了最基本的网页抓取,不过,现在大多数网站都是动态网页,需要你动态地传递参数给它,它做出对应的响应。所以,在访问时,我们需要传递数据给它。最常见的情况是什么?对了,就是登录注册的时候呀。
把数据用户名和密码传送到一个URL,然后你得到服务器处理之后的响应,这个该怎么办?下面让我来为小伙伴们揭晓吧!
数据传送分为POST和GET两种方式,两种方式有什么区别呢?
最重要的区别是GET方式是直接以链接形式访问,链接中包含了所有的参数,当然如果包含了密码的话是一种不安全的选择,不过你可以直观地看到自己提交了什么内容。POST则不会在网址上显示所有的参数,不过如果你想直接查看提交了什么就不太方便了,大家可以酌情选择。
POST方式:
上面我们说了data参数是干嘛的?对了,它就是用在这里的,我们传送的数据就是这个参数data,下面演示一下POST方式。
Python
|
1 2 3 4 5 6 7 8 9 |
import urllib import urllib2 values = {"username":"1016903103@qq.com","password":"XXXX"} data = urllib.urlencode(values) url = "https://passport.csdn.net/account/login?from=http://my.csdn.net/my/mycsdn" request = urllib2.Request(url,data) response = urllib2.urlopen(request) print response.read() |
我们引入了urllib库,现在我们模拟登陆CSDN,当然上述代码可能登陆不进去,因为还要做一些设置头部header的工作,或者还有一些参数 没有设置全,还没有提及到在此就不写上去了,在此只是说明登录的原理。我们需要定义一个字典,名字为values,参数我设置了username和 password,下面利用urllib的urlencode方法将字典编码,命名为data,构建request时传入两个参数,url和data,运 行程序,即可实现登陆,返回的便是登陆后呈现的页面内容。当然你可以自己搭建一个服务器来测试一下。
注意上面字典的定义方式还有一种,下面的写法是等价的
Python
|
1 2 3 4 5 6 7 8 9 10 11 |
import urllib import urllib2 values = {} values['username'] = "1016903103@qq.com" values['password'] = "XXXX" data = urllib.urlencode(values) url = "http://passport.csdn.net/account/login?from=http://my.csdn.net/my/mycsdn" request = urllib2.Request(url,data) response = urllib2.urlopen(request) print response.read() |
以上方法便实现了POST方式的传送
GET方式:
至于GET方式我们可以直接把参数写到网址上面,直接构建一个带参数的URL出来即可。
Python
|
1 2 3 4 5 6 7 8 9 10 11 12 |
import urllib import urllib2 values={} values['username'] = "1016903103@qq.com" values['password']="XXXX" data = urllib.urlencode(values) url = "http://passport.csdn.net/account/login" geturl = url + "?"+data request = urllib2.Request(geturl) response = urllib2.urlopen(request) print response.read() |
你可以print geturl,打印输出一下url,发现其实就是原来的url加?然后加编码后的参数
Python
|
1 |
http://passport.csdn.net/account/login?username=1016903103%40qq.com&password=XXXX |
和我们平常GET访问方式一模一样,这样就实现了数据的GET方式传送。
本节讲解了一些基本使用,可以抓取到一些基本的网页信息,小伙伴们加油!
Python爬虫入门:Urllib库的基本使用的更多相关文章
- python爬虫入门urllib库的使用
urllib库的使用,非常简单. import urllib2 response = urllib2.urlopen("http://www.baidu.com") print r ...
- Python爬虫入门 Urllib库的基本使用
1.分分钟扒一个网页下来 怎样扒网页呢?其实就是根据URL来获取它的网页信息,虽然我们在浏览器中看到的是一幅幅优美的画面,但是其实是由浏览器解释才呈现出来的,实质它是一段HTML代码,加 JS.CSS ...
- python爬虫之urllib库(三)
python爬虫之urllib库(三) urllib库 访问网页都是通过HTTP协议进行的,而HTTP协议是一种无状态的协议,即记不住来者何人.举个栗子,天猫上买东西,需要先登录天猫账号进入主页,再去 ...
- python爬虫之urllib库(二)
python爬虫之urllib库(二) urllib库 超时设置 网页长时间无法响应的,系统会判断网页超时,无法打开网页.对于爬虫而言,我们作为网页的访问者,不能一直等着服务器给我们返回错误信息,耗费 ...
- python爬虫之urllib库(一)
python爬虫之urllib库(一) urllib库 urllib库是python提供的一种用于操作URL的模块,python2中是urllib和urllib2两个库文件,python3中整合在了u ...
- python爬虫之urllib库介绍
一.urllib库 urllib是Python自带的一个用于爬虫的库,其主要作用就是可以通过代码模拟浏览器发送请求.其常被用到的子模块在Python3中的为urllib.request和urllib. ...
- python 爬虫之 urllib库
文章更新于:2020-03-02 注:代码来自老师授课用样例. 一.初识 urllib 库 在 python2.x 版本,urllib 与urllib2 是两个库,在 python3.x 版本,二者合 ...
- Python 爬虫之urllib库的使用
urllib库 urllib库是Python中一个最基本的网络请求库.可以模拟浏览器的行为,向指定的服务器发送一个请求,并可以保存服务器返回的数据. urlopen函数: 在Python3的urlli ...
- python爬虫之urllib库
请求库 urllib urllib主要分为几个部分 urllib.request 发送请求urllib.error 处理请求过程中出现的异常urllib.parse 处理urlurllib.robot ...
- Python爬虫系列-Urllib库详解
Urllib库详解 Python内置的Http请求库: * urllib.request 请求模块 * urllib.error 异常处理模块 * urllib.parse url解析模块 * url ...
随机推荐
- 【转】NoClassDefFoundError和ClassNotFoundException
调试Hadoop源码时,一运行就报这个错误,后来发现是maven配置时,scope配置的问题, MAVEN Scope使用 相关链接:http://acooly.iteye.com/blog/178 ...
- HDFS概述(2)————Block块大小设置
以下内容转自:http://blog.csdn.net/samhacker/article/details/23089157?utm_source=tuicool&utm_medium=ref ...
- 51 nod 1495 中国好区间 奇葩卡时间题 700ms 卡O(n*log(n)), 思路:O(n)尺取法
题目: 这个题目竟然叫中国好区间,要不要脸.欸,不得不说还蛮顺口的,哈哈哈. 首先我们有一个数组a.可以递推得来,O(n)时间复杂度. 定义left(有效区间的左端点),bigger(有效区间中大于等 ...
- Linux Bash Shell字符串截取
#!/bin/bash#定义变量赋值时等号两边不能有空格,否则会报命令不存在 # 运行shell脚本两种方式 # 1.作为解释参数 /bin/sh test.sh ; 2.作为可执行文件 chmo ...
- cnblog排版
记录一些自己写博客中的排版技巧 一.标题 红色部分代码用在标题的CSS样式中 <p style="background: gray; font-size: 18px; font-fam ...
- try catch finally 中包含return的几种情况,及返回结果
当当当,兴致勃勃的第二篇博客,散花~ 下面是正题(敲黑板) 第一种情况:在try和catch中有return,finally中没有return,且finally中没有对try或catch中要 retu ...
- win10 UWP 蜘蛛网效果
我看见了知乎首页登录背景和普通的地球人写的博客,发现了个好看的效果. 那么我来告诉大家如何做这个效果. 第一步是在 Canvas 画点,第二步是让点移动,第三步是画线 在 Canvas 画一个点 我们 ...
- UWP取出图片主色调
一切都要从风车动漫的新详情页说起... 当我最初拿到风车动漫新详情页的UI设计概念图时,新详情页中有两点: 1.图片的高斯模糊 2.取出图片的主色调(主要用于tag和相关动漫的标题背景) 大概就是要这 ...
- 基于FFMPEG的跨平台播放器实现
基于FFMPEG的跨平台播放器实现 一.背景介绍 FFmpeg是一款超级强大的开源多媒体编解码框架,提供了录制.转换以及流化音视频的完整解决方案,包含了libavcodec.libavformat等多 ...
- java统计英文字母、空格、数字和其它字符的数目
package tes; import java.util.Scanner; //java统计英文字母,空格,数字和其它字符的数目 public class ZiFuTongJi { public s ...