
The Expressive Power of Neural Networks: A View from the Width
@article{lu2017the,
title={The expressive power of neural networks: a view from the width},
author={Lu, Zhou and Pu, Hongming and Wang, Feicheng and Hu, Zhiqiang and Wang, Liwei},
pages={6232--6240},
year={2017}}
概
Universal approximation theorem-wiki, 这个定理分成俩个部分, 第一个部分是Unbounded Width Case, 这篇文章是Bounded Width Case (ReLu网络).
主要内容
定理1

另外, 定理1中的网络由若干个(视\(\epsilon\)而定) blocks排列而成, 每个block具有以下性质:
- depth: 4n+1, width: n+4 的神经网络
- 在一个范围外其“函数值”为0
- 它能够存储样本信息
- 它会加总自身的信息和前面的逼近信息
定理2

定理3
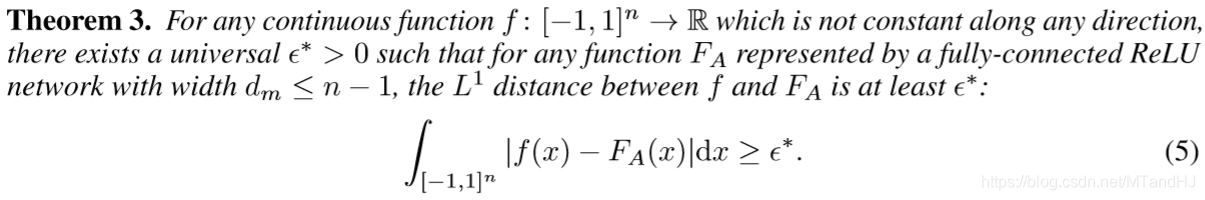
定理4

定理1的证明
因为主要关注定理1, 所以讲下这个部分的证明(实际上是因为其它懒得看了).
假设\(x = (x_1, x_2,\ldots, x_n)\)为输入, \(f\)是\(L^1\)可积的, 对于任意的\(\epsilon > 0\), 存在\(N > 0\)满足
\]
定义下列符号:
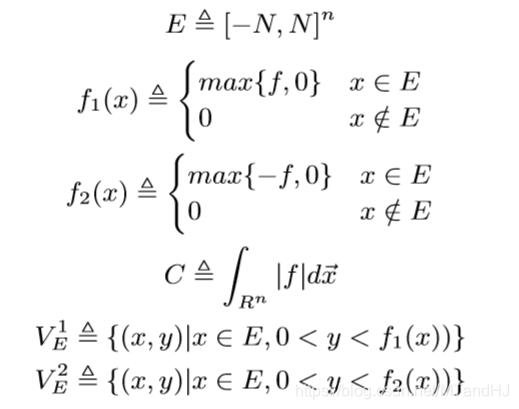
则我们有:
\]
对于\(i=1, 2\), 既然\(V_E^i\)是可测的(且测度小于\(+\infty\)), 则我们能找到有限个\(n+1\)维的矩体去逼近(原文用了cover, 但是我感觉这里用互不相交的矩体才合理), 并有
\]
不出意外\(\Delta\)应该就是\.
假设\(J_{j,i}\)有\(n_i\)个, 且
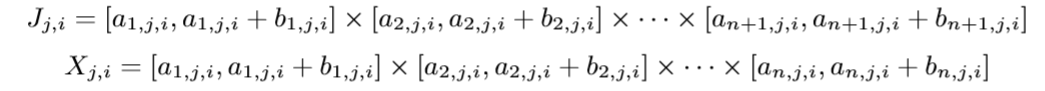
每一个\(J_{j, i}\)对应一个指示函数:
\begin{array}{ll}
1 & x \in X_{j,i} \\
0 & x \not \in X_{j,i}.
\end{array} \right.
\]
则
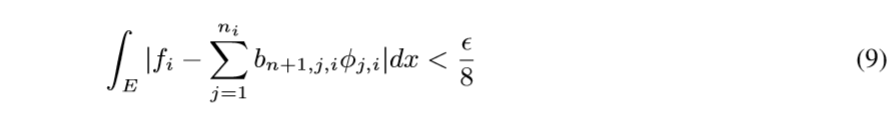
这个在实变函数将多重积分, 提到的下方图形集有讲到.
于是我们有(\(-f_1-f_2+f_1+f_2-f+f\)然后拆开来就可以得到不等式)
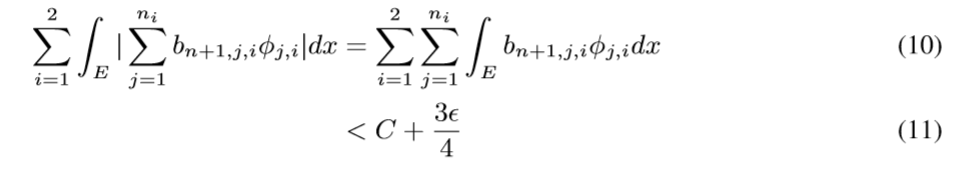
现在我们要做的就是通过神经网络拟合\(\varphi_{j,i}\)去逼近\(\phi_{j,i}\), 使得
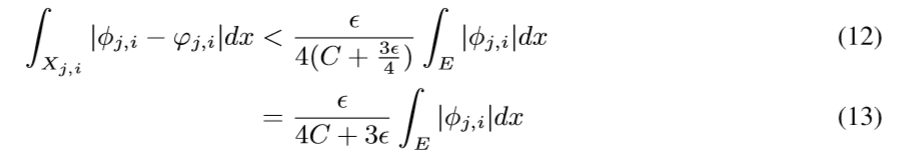
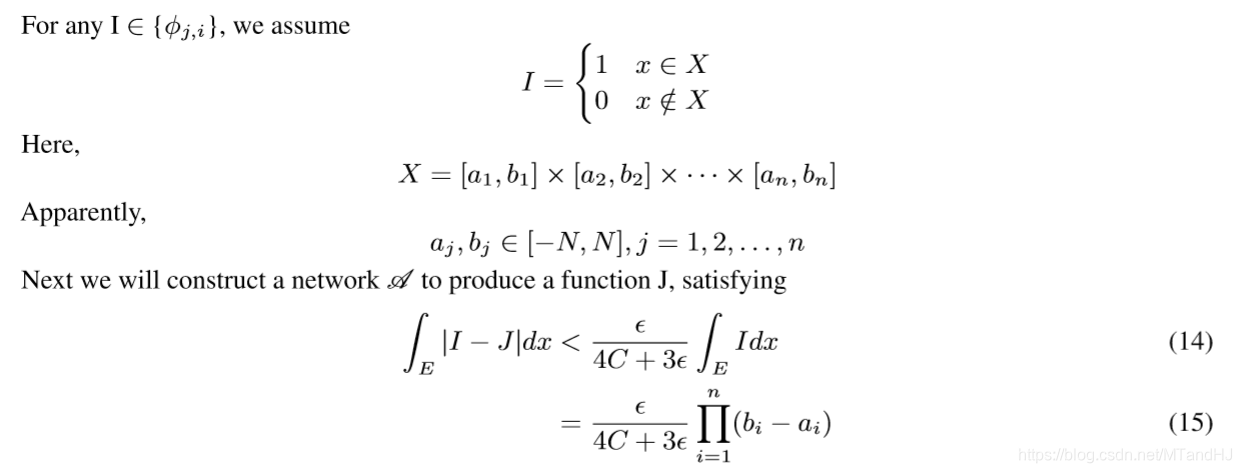
现在来讲, 如果构造这个神经网络:
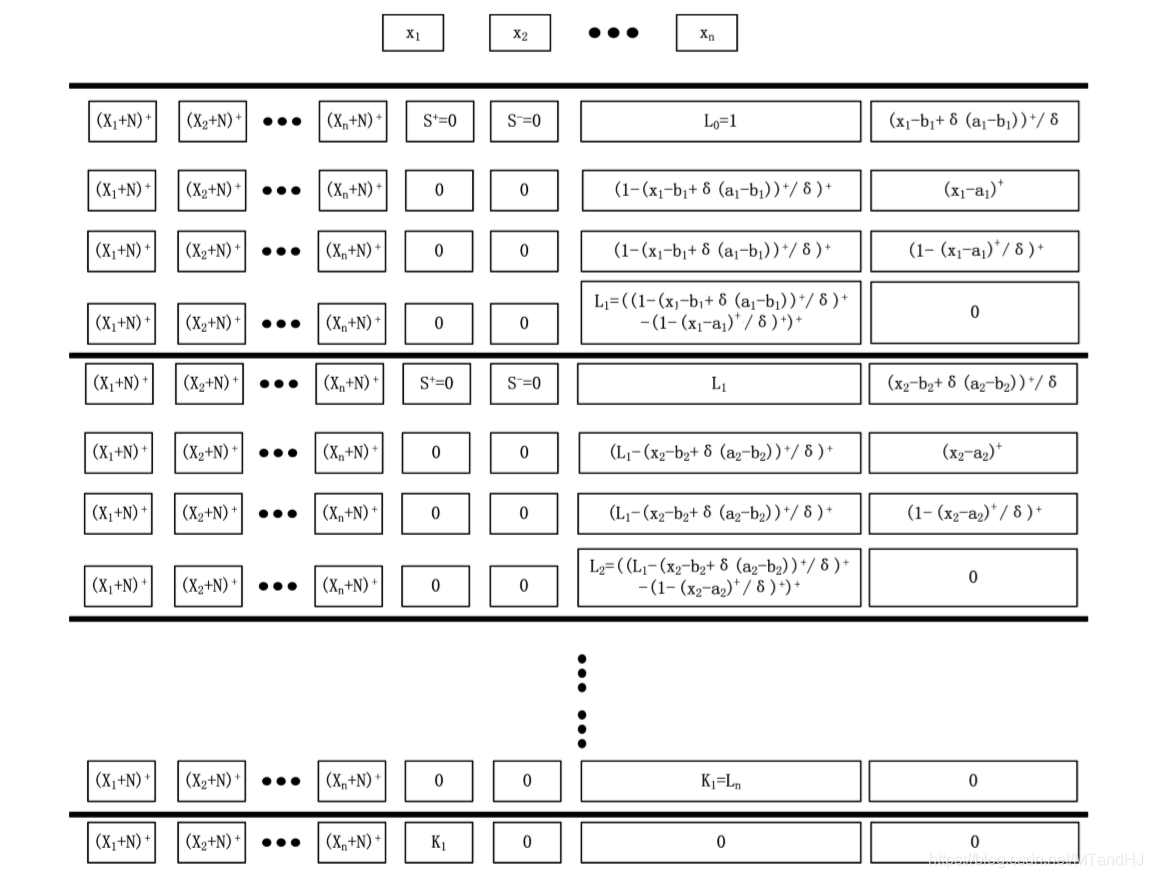
一个block有4n+1层, 每层的width是n+4, 注意到所有层的前n个Node都是一样的用来保存样本信息. 我们用\(R_{i, j, \mathscr{B_k}}, i=1, 2, 3, 4, j=1,\ldots,n+4, k=1,\ldots, n,\) 表示第\(k\)个Unit(每个Unit有4层)的第\(i\)层的第\(j\)个Node.
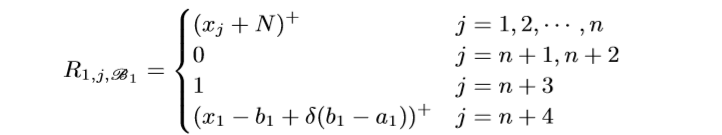
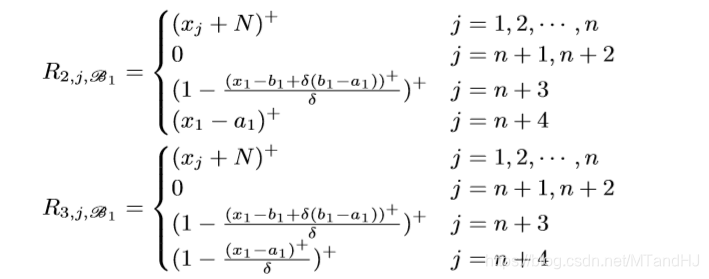

注意: \(R_{2, n+3, \mathscr{B_1}}\)应该是\((x_1-a_1)^+/\delta\), 最开始的结构图中的对的. 我们来看一下, 什么样的\(x=(x_1, \ldots, x_n)\), 会使得\(L_1\)不为0.
如果\(x_1=a_1+\delta(b_1-a_1)+\epsilon\), 这里\(\epsilon>0\)是一个任意小量, 和上文中的\(\epsilon\)没有关系. 此时(当\(\delta<1/2\))
\]
当\(\delta\)足够小的时候
\]
此时\(L_1=1\), 类似地, 可以证明, 当\(\delta \rightarrow 0\)的时候, \(x_1 \in (a_1+\delta(b_1-a_1),b_1-\delta(b_1-a_1))\)时, \(L_1=1\), 否则为0.
\(R_{i, j, \mathscr{B_k}}\)的定义是类似的, 只是
\]
可以证明, 当\(\delta\rightarrow 0\), 且\(x_t \in (a_t + \delta(b_t-a_t),b_t-\delta(b_t-a_t)), t=1,2,\ldots, k\)的时候, \(L_k=1.\), 这样我们就构造了一个指示函数, 如果这个这函数对应的\(i\)为1则将\(L_n\)存入n+1 Node, 否则 n+2 Node (实际上, 我感觉应该存的是\(b_{n+1,j,i}L_n\)), 则

这里\(\mu\)相当于\(L_n\). 所以多个blocks串联起来后, 我们就得到了一个函数, 且这个函数是我们想要的.
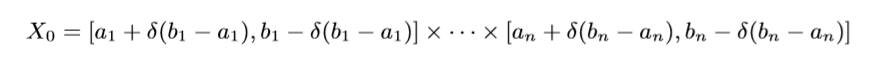
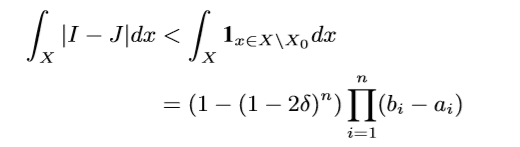
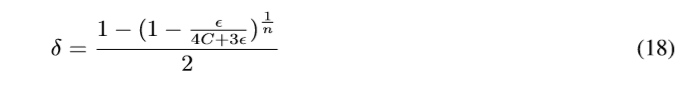
这个直接通过超距体体积计算得来的, 我们只需要取:
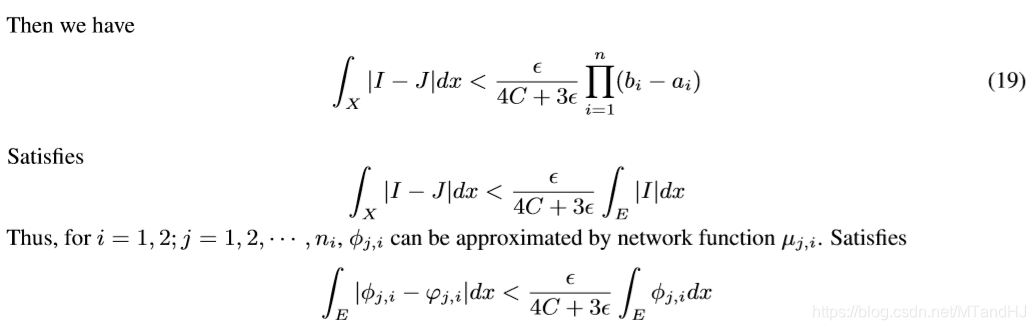
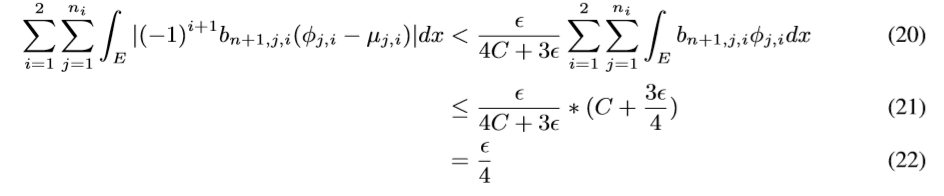
最后
令\(g:=\sum_{i=1}^2\sum_{j=1}^{n_i}(-1)^{i+1}b_{n+1,j,i}\mu_{j,i}\),便有

此即定理1的证明.
The Expressive Power of Neural Networks: A View from the Width的更多相关文章
- Deep learning_CNN_Review:A Survey of the Recent Architectures of Deep Convolutional Neural Networks——2019
CNN综述文章 的翻译 [2019 CVPR] A Survey of the Recent Architectures of Deep Convolutional Neural Networks 翻 ...
- 课程一(Neural Networks and Deep Learning),第一周(Introduction to Deep Learning)—— 2、10个测验题
1.What does the analogy “AI is the new electricity” refer to? (B) A. Through the “smart grid”, AI i ...
- Non-local Neural Networks
1. 摘要 卷积和循环神经网络中的操作都是一次处理一个局部邻域,在这篇文章中,作者提出了一个非局部的操作来作为捕获远程依赖的通用模块. 受计算机视觉中经典的非局部均值方法启发,我们的非局部操作计算某一 ...
- tensorfolw配置过程中遇到的一些问题及其解决过程的记录(配置SqueezeDet: Unified, Small, Low Power Fully Convolutional Neural Networks for Real-Time Object Detection for Autonomous Driving)
今天看到一篇关于检测的论文<SqueezeDet: Unified, Small, Low Power Fully Convolutional Neural Networks for Real- ...
- [C3] Andrew Ng - Neural Networks and Deep Learning
About this Course If you want to break into cutting-edge AI, this course will help you do so. Deep l ...
- 提高神经网络的学习方式Improving the way neural networks learn
When a golf player is first learning to play golf, they usually spend most of their time developing ...
- 深度卷积神经网络用于图像缩放Image Scaling using Deep Convolutional Neural Networks
This past summer I interned at Flipboard in Palo Alto, California. I worked on machine learning base ...
- 卷积神经网络用于视觉识别Convolutional Neural Networks for Visual Recognition
Table of Contents: Architecture Overview ConvNet Layers Convolutional Layer Pooling Layer Normalizat ...
- Image Scaling using Deep Convolutional Neural Networks
Image Scaling using Deep Convolutional Neural Networks This past summer I interned at Flipboard in P ...
随机推荐
- 大数据学习day25------spark08-----1. 读取数据库的形式创建DataFrame 2. Parquet格式的数据源 3. Orc格式的数据源 4.spark_sql整合hive 5.在IDEA中编写spark程序(用来操作hive) 6. SQL风格和DSL风格以及RDD的形式计算连续登陆三天的用户
1. 读取数据库的形式创建DataFrame DataFrameFromJDBC object DataFrameFromJDBC { def main(args: Array[String]): U ...
- Git的使用-一个分支完全替换另一个分支
之前公司git分支混乱,今天花时间整理了一下,在合并分支的时候遇到一个问题: 一个很久没有拉取远程代码的分支与master分支合并时,出现冲突之外,还会丢失文件,很头疼,然后找到了下面的方法,可以直接 ...
- Linux基础命令---ftp
ftp ftp指令可以用来登录远程ftp服务器. 此命令的适用范围:RedHat.RHEL.Ubuntu.CentOS.SUSE.openSUSE.Fedora. 1.语法 ftp [ ...
- java面试--(生成随机数,获取重复次数最多,并且数是最大的一个,打印出来)
import java.util.*; public class MaxRandom { public static void main(String[] args){ int[] num = new ...
- When should we write our own copy constructor?
Reference:http://www.fredosaurus.com/notes-cpp/oop-condestructors/copyconstructors.html Please write ...
- RPC、HTTP、RESTful
RESTful RESTFUL是一种网络应用程序的设计风格和开发方式,基于HTTP,可以使用XML格式定义或JSON格式定义.RESTFUL适用于移动互联网厂商作为业务使能接口的场景,实现第三方OTT ...
- 【Java 8】函数式接口(二)—— 四大函数接口介绍
前言 Java8中函数接口有很多,大概有几十个吧,具体究竟是多少我也数不清,所以一开始看的时候感觉一脸懵逼,不过其实根本没那么复杂,毕竟不应该也没必要把一个东西设计的很复杂. 几个单词 在学习了解之前 ...
- eclipse.ini配置 vmargs 说明
-vmargs -Xms128M -Xmx512M -XX:PermSize=64M -XX:MaxPermSize=128M 1. 各个参数的含义什么? 参数中-vmargs的意思是设置JVM参数, ...
- Nginx配置重定向
目录 一.简介 二.配置 访问a页面重定向到b页面 访问当前nginx,重定向到其他网址 一.简介 据相关变量重定向和选择不同的配置,从一个 location 跳转到另一个 location,不过这样 ...
- Tableau预测指示器的运用
一.将订单日期拖拽两次到列,日期格式设置为年订单日期和月订单日期 二.将销售额拖拽至行,对应结果如下图所示 三.分析-趋势线-显示趋势线-显示选择整个视图 四.右键预测的任意位置,选择预测-描述预测- ...