
经过4次优化我把python代码耗时减少95%
背景交代
团队做大学英语四六级考试相关服务。业务中有一个care服务,购买了care服务考试不过可以全额退款,不过有一个前提是要完成care服务的任务,比如坚持背单词N天,完成指定的试卷。
在这个背景下,当2021年6月的四六级考试完成之后,要统计出两种用户数据:
- 完成care服务的用户
- 没有完成care的用户
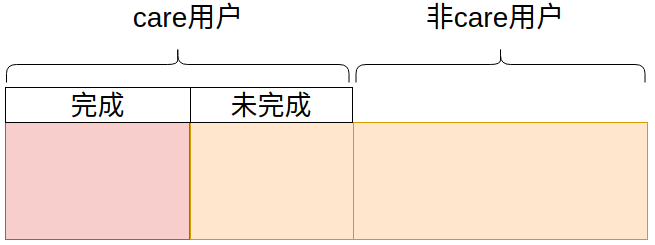
所以简化的逻辑就是要在所有的用户中区分出care完成用户和care未完成用户。
- 目标1:完成care服务
- 目标2:未完成care服务
所有目标用户的数量在2.7w左右,care完成用户在0.4w左右。所以我需要做的是在从数据库中查询出的 2.7w 所有用户,去另一个表区分出care完成用户和care未完成用户。
第一版
第一版:纯粹使用数据库查询。首先查询出所有目标,然后遍历所有用户,在遍历中使用user id从另一张表中查询出care完成用户。
总量在2.7w 左右,所以数据库就查询了2.7w次。
耗时统计:144.7 s
def remind_repurchase():

    # 查询出所有用户

    all_users = cm.UserPlan.select().where(cm.UserPlan.plan_id.in_([15, 16]))

    plan_15_16_not_refund_users = []

    plan_15_16_can_refund_users = []

    for user in all_users:

        # 从另一张表查询用户是否完成care

        user_insurance = cm.UserInsurance.select().where(

            cm.UserInsurance.user_id == user.user_id,

            cm.UserInsurance.plan_id == user.plan_id,

            cm.UserInsurance.status == cm.UserInsurance.STATUS_SUCCESS,

        )

        # care 完成

        if len(user_insurance) == 1:

            # 其他逻辑

            plan_15_16_can_refund_users.append(user.user_id)

        else:

            # care未完成用户

            plan_15_16_not_refund_users.append(user.user_id)
主要的耗时操作就在for循环查询数据库。这种耗时肯定是不被允许的,需要提高效率。
第二版
优化点:增加事务
第二版优化思路:对于 2.7w 次的数据库库查询肯定会有 2.7w 次建立连接、事务、查询语句转SQL等。2.7w次的开销也是一个极大的数字。理所当然的想到了减少事务的开销。将所有的数据库查询都放在一个事务中完成,就能够有效减少查询带来的耗时。
耗时统计:100.6 s
def remind_repurchase():

    # 查询出所有用户

    all_users = cm.UserPlan.select().where(cm.UserPlan.plan_id.in_([15, 16]))

    plan_15_16_not_refund_users = []

    plan_15_16_can_refund_users = []

    # 增加事务

    with pwdb.database.atomic():

        for user in all_users:

            # 从另一张表查询用户是否完成care

            user_insurance = cm.UserInsurance.select().where(

                cm.UserInsurance.user_id == user.user_id,

                cm.UserInsurance.plan_id == user.plan_id,

                cm.UserInsurance.status == cm.UserInsurance.STATUS_SUCCESS,

            )

            # care 完成

            if len(user_insurance) == 1:

                # 其他逻辑

                plan_15_16_can_refund_users.append(user.user_id)

            else:

                # care未完成用户

                plan_15_16_not_refund_users.append(user.user_id)
增加事务之后减少了44s,相当于缩短了时间30%的时间,由此可以看出事务在数据库中查询是一个比较耗时的操作。
第三版
优化点:将2.7w次的数据库查询转变成对列表的in操作。
第三版提出改进方案:原来的逻辑是循环 2.7w 次,在数据库中查询用户是否完成care服务。2.7w 次的数据库查询是耗时最长的原因,而可以改进的方法是将所有完成care服务的用户先一次性查询出来,放到一个列表中。遍历所有用户时不去查数据库,而是直接使用in操作在列表中查询。这种方法直接将 2.7w 次数据库遍历减少到1次,极大缩短了数据库查询耗时。
耗时统计:11.5 s
def remind_repurchase():

    all_users = cm.UserPlan.select().where(cm.UserPlan.plan_id.in_([15, 16]))

    plan_15_16_not_refund_users = []

    plan_15_16_can_refund_users = []

    # 所有care完成用户,先将所有用户查询出来放在一个列表中

    user_insurance = cm.UserInsurance.select().where(

        cm.UserInsurance.plan_id.in_([15, 16]),

        cm.UserInsurance.status == cm.UserInsurance.STATUS_SUCCESS,

    )

    user_insurance_list = [user.user_id for user in user_insurance]

    for user in all_users:

        user_id = user.user_id

        # care 完成

        if user.user_id in user_insurance_list:

            # 查分数

            plan_15_16_can_refund_users.append(user_id)

        else:

            # care未完成用户 + 非care用户

            plan_15_16_not_refund_users.append(user_id)
这一次优化的效果是非常显著的,可以看出想要提高代码效率要尽量减少数据库查询次数。
第四版
优化点:2.7w 次对列表的in操作变成对字典的in操作
在第三版中已经极大的优化了效率,但是仔细琢磨之后发现还是有提升的空间的。在第三版中 2.7w 次for循环,然后用in操作在列表中查询。众所周知python中对列表的in操作是遍历的,时间复杂度为0(n),所以效率不高,而对字典的in操作时间复杂度为常数级别0(1)。所以在第四版优化中先查询出的数据不保存为列表,而是保存为字典。key就是原来列表中的值,value可自定义。
耗时统计:11.42 s
def remind_repurchase():

    all_users = cm.UserPlan.select().where(cm.UserPlan.plan_id.in_([15, 16]))

    plan_15_16_not_refund_users = []

    plan_15_16_can_refund_users = []

    # 所有care完成用户,先将所有用户查询出来放在一个列表中

    user_insurance = cm.UserInsurance.select().where(

        cm.UserInsurance.plan_id.in_([15, 16]),

        cm.UserInsurance.status == cm.UserInsurance.STATUS_SUCCESS,

    )

    user_insurance_dict = {user.user_id:True for user in user_insurance}

    for user in all_users:

        user_id = user.user_id

        # care 完成

        if user.user_id in user_insurance_dict:

            # 查分数

            plan_15_16_can_refund_users.append(user_id)

        else:

            # care未完成用户 + 非care用户

            plan_15_16_not_refund_users.append(user_id)
由于2.7w次的in操作数据量并不是很大,并且列表的in操作在python中优化的效率也很好,所以这里的对字典的in操作并没有减少时间消耗。
第五版
优化点:将in操作转变成集合操作。
在前四版的优化下已经将耗时缩短了 133s,减少了近 92.1% 的耗时,想着这个数据看起来还不错了。隔天早上在刷牙时脑子里思绪纷飞就想到这个事情了。这时忽然想到既然我能查询全部用户,又将完成care用户的用户查询到一个列表中,这时不就是相当于两个集合吗?既然是集合,那么使用集合之间的交集和差集是不是比循环 2.7w 次要快呢?上班之后马上动手来验证这个想法。果然,还能够减少时间消耗,将第四版中的11.42 直接减少了一半,缩短到5.78,缩短近50%。
耗时统计: 5.78 s
def remind_repurchase():

    all_users = cm.UserPlan.select().where(cm.UserPlan.plan_id.in_([15, 16]))

    all_users_set = set([user.user_id for user in all_users])

    plan_15_16_can_refund_users = []

    received_user_count = 0

    # 所有care完成用户

    user_insurance = cm.UserInsurance.select().where(

        cm.UserInsurance.plan_id.in_([15, 16]),

        cm.UserInsurance.status == cm.UserInsurance.STATUS_SUCCESS,

    )

    user_insurance_set = set([user.user_id for user in user_insurance])

    temp_can_refund_users = all_users_set.intersection(user_insurance_set)
总结
最终优化的结果:
第一版耗时: 144.7 s
最后一版耗时: 5.7 s
优化时间:109 s
优化百分比:95.0%
在各个版本中的优化详细细节如下:
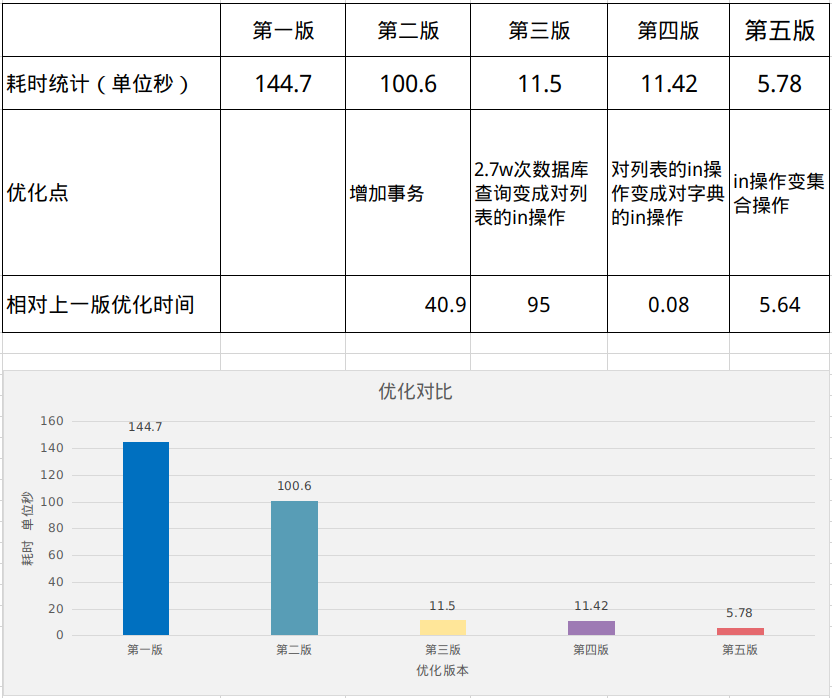
由此可以得出几个结论,帮助减少程序耗时:
结论一:事务不仅能够保证数据原子性,合理使用还能有效减少数据库查询耗时
结论二:集合操作的效率非常高,要善于使用集合减少循环
结论三:字典的查找效率高于列表,但是万次级别的操作无法体验优势
最后的还有一个结论:程序员的灵感似乎在刷牙、上厕所、洗澡、喝水时特别活跃,所以写不出来代码就该去摸摸鱼了。

经过4次优化我把python代码耗时减少95%的更多相关文章
- ROS系统python代码测试之rostest
ROS系统中提供了测试框架,可以实现python/c++代码的单元测试,python和C++通过不同的方式实现, 之后的两篇文档分别详细介绍各自的实现步骤,以及测试结果和覆盖率的获取. ROS系统中p ...
- [转] Python 代码性能优化技巧
选择了脚本语言就要忍受其速度,这句话在某种程度上说明了 python 作为脚本的一个不足之处,那就是执行效率和性能不够理想,特别是在 performance 较差的机器上,因此有必要进行一定的代码优化 ...
- Python代码性能优化技巧
摘要:代码优化能够让程序运行更快,可以提高程序的执行效率等,对于一名软件开发人员来说,如何优化代码,从哪里入手进行优化?这些都是他们十分关心的问题.本文着重讲了如何优化Python代码,看完一定会让你 ...
- 如何让你的Python代码更加pythonic ?
pythonic如果翻译成中文的话就是很python.很+名词结构的用法在中国不少. 以下为了简略,我们用P表示pythonic的写法,NP表示non-pythonic的写法,当然此P-NP非彼P-N ...
- Python 代码性能优化技巧(转)
原文:Python 代码性能优化技巧 Python 代码优化常见技巧 代码优化能够让程序运行更快,它是在不改变程序运行结果的情况下使得程序的运行效率更高,根据 80/20 原则,实现程序的重构.优化. ...
- Python 代码性能优化技巧
选择了脚本语言就要忍受其速度,这句话在某种程度上说明了 python 作为脚本的一个不足之处,那就是执行效率和性能不够理想,特别是在 performance 较差的机器上,因此有必要进行一定的代码优化 ...
- python基础:测量python代码的运行时间
Python社区有句俗语:“python自己带着电池” ,别自己写计时框架.Python 2.3 具备一个叫做 timeit 的完美计时工具可以测量python代码的运行时间. timeit模块 ti ...
- pythonic-让python代码更高效
何为pythonic? pythonic如果翻译成中文的话就是很python.很+名词结构的用法在中国不少,比如:很娘,很国足,很CCTV等等. 我的理解为,很+名词表达了一种特殊和强调的意味.所以很 ...
- 让你的Python代码更加pythonic
http://wuzhiwei.net/be_pythonic/ 何为pythonic? pythonic如果翻译成中文的话就是很python.很+名词结构的用法在中国不少,比如:很娘,很国足,很CC ...
随机推荐
- YbtOJ#593-木棍问题【费用流】
正题 题目链接:https://www.ybtoj.com.cn/contest/114/problem/3 题目大意 \(n*m\)的网格上有一些格子有木球,两个相邻木球直接可以有木棍. 两个\(L ...
- WPF进阶技巧和实战03-控件(2-特殊容器)
ScrollViewer控件 直接继承ContextControl类,提供了虚拟界面,允许用户围绕更大的元素滚动.只能包含单个元素(ContextControl决定),但可以放置布局控件来实现多个任意 ...
- 神器----IntelliJ IDEA基本配置
介绍 首先是百度百科对于 IDEA 的介绍 IDEA 全称 IntelliJ IDEA,是java编程语言开发的集成环境.IntelliJ在业界被公认为最好的java开发工具,尤其在智能代码助手.代码 ...
- 前端VUE基于gitlab的CI_CD
目录 CI 1.Gitlab的CI 1.1 GitLab-Runner 1.2 .gitlab-ci.yml 1.3 配置.gitlab-ci.yml 1.3.1 Pipeline概念 1.3.2 S ...
- 7.JVM调优-方法区,堆,栈调优详解
通常我们都知道在堆空间新生代Eden区满了,会触发minor GC, 在老年代满了会触发full GC, 触发full GC会导致Stop The World, 那你们知道还有一个区域满了一会触发Fu ...
- 改头换面为哪般,最像Android的Windows——Win11升级安装体验
在过完了十一小长假之后,各位打工人.学僧党可期待的不仅仅是新一轮的工作,Windows11也在10月5日悄悄正式发布,正式版已经面向MSDN订阅用户开放下载. 作为微软金牌合作伙伴,本葡萄已在第一时间 ...
- 从0到1使用Kubernetes系列——Kubernetes入门
基本概念 Docker 是什么 Docker 起初是 dotCloud 公司创始人 Solomon Hykes 在法国的时候发起的一项公司内部项目,Docker 是基于 dotCloud 公司多年云服 ...
- 微软发布了Visual Studio 2022 RC版,并将在11月8日发布正式版
微软今天发布了Visual Studio 2022 最接近正式发布的RC版本,同时宣布在11月8日发布正式版,届时将在线上发布虚拟的发布活动,具体参见:https://devblogs.microso ...
- 如何无缝迁移 SpringCloud/Dubbo 应用到 Serverless 架构
作者 | 行松 阿里巴巴云原生团队 本文整理自<Serverless 技术公开课>,"Serverless"公众号后台回复"入门",即可获取系列文章 ...
- 👊 Spring技术原理系列(7)带你看看那些可能你还不知道的Spring特性技巧哦!
前提介绍 本文主要介绍相关Spring框架的一些新特性问题机制,包含了一些特定注解方面的认识. @Lazy可以延迟依赖注入 @Lazy注解修饰在类层面! @Lazy @Service public c ...