
solr特点九:word(分词)
在Solr中配置中文分词IKAnalyzer
1、在配置文件schema.xml(位置{SOLR_HOME}/config/下),配置信息如下:
<!-- IKAnalyzer 中文分词-->
<fieldType name="text_ik" class="solr.TextField">
<analyzer type="index">
<tokenizer class="org.wltea.analyzer.solr.IKTokenizerFactory" isMaxWordLength="false"/>
<filter class="solr.StopFilterFactory" ignoreCase="true" words="stopwords.txt" enablePositionIncrements="true" />
<filter class="solr.LowerCaseFilterFactory"/>
</analyzer>
<analyzer type="query">
<tokenizer class="org.wltea.analyzer.solr.IKTokenizerFactory" isMaxWordLength="true"/>
<filter class="solr.StopFilterFactory" ignoreCase="true" words="stopwords.txt" enablePositionIncrements="true" />
<filter class="solr.SynonymFilterFactory" synonyms="synonyms.txt" ignoreCase="true" expand="true"/>
<filter class="solr.LowerCaseFilterFactory"/>
</analyzer>
</fieldType>
2、在IKAnalyzer相关的jar包(IKAnalyzer2012_u6.jar 本博客不提供下载)放在{SOLR_HOME}/lib下。
3、测试IKAnalyzer中文分词 效果:
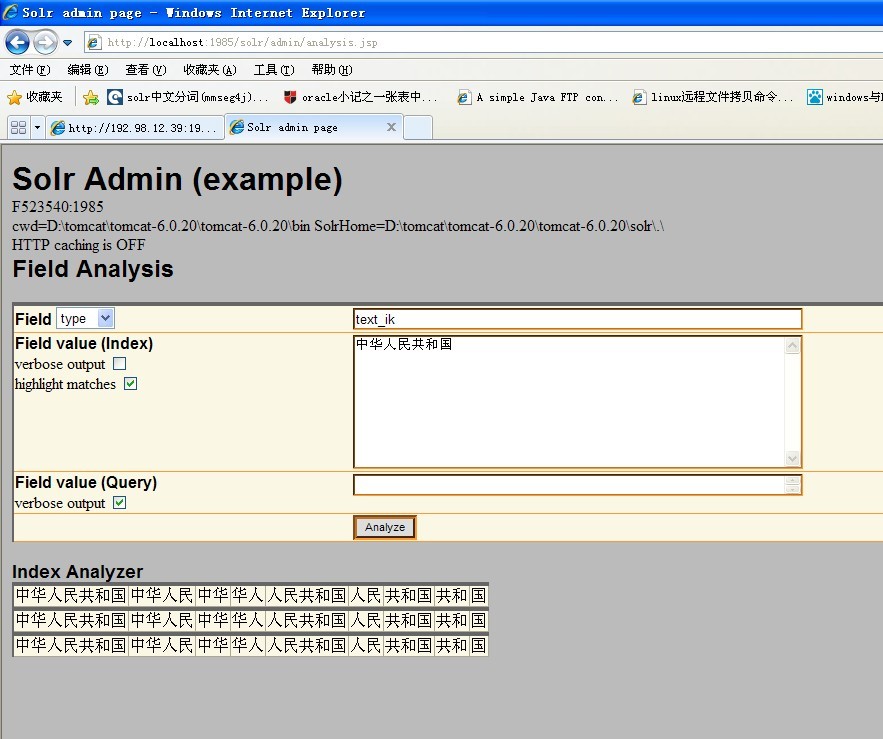
ikanlyzer分词效果还是不错的 ,通过配置可以扩展个人词典、自定义停顿词等。配置信息如下:
IKAnalyzer.cfg.xml配置文件
把stopword.dic和IKAnalyzer.cfg.xml复制到class根目录就可以启用停用词功能和扩展自己的词典
<?xmlversion="1.0"encoding="UTF-8"?>
<!DOCTYPEpropertiesSYSTEM"http://java.sun.com/dtd/properties.dtd">
<properties>
<comment>IK Analyzer 扩展配置</comment>
<!--用户可以在这里配置自己的扩展字典 -->
<entrykey="ext_dict">ext.dic;</entry>
<!--用户可以在这里配置自己的扩展停止词字典-->
<entrykey="ext_stopwords">stopword.dic;</entry>
</properties>
如果想在solr中使用IK来加载扩展词典,需要将以上的配置文件和词典扩展文件放在tomcat/webapps/solr/WEB-INF/classes下。同时,比如我的ext.dic中有以下内容:

那么在solr中分词效果便是:

solr特点九:word(分词)的更多相关文章
- Solr多核心及分词器(IK)配置
Solr多核心及分词器(IK)配置 多核心的概念 多核心说白了就是多索引库.也可以理解为多个"数据库表" 说一下使用multicore的真实场景,比若说,产品搜索和会员信息搜索 ...
- Java——word分词·自定义词库
word: https://github.com/ysc/word word-1.3.1.jar 需要JDK8word-1.2.jar c语言给解析成了“语言”,自定义词库必须为UTF-8 程序一旦运 ...
- 全文检索引擎Solr系列——整合中文分词组件mmseg4j
默认Solr提供的分词组件对中文的支持是不友好的,比如:“VIM比作是编辑器之神”这个句子在索引的的时候,选择FieldType为”text_general”作为分词依据时,分词效果是: 它把每一个词 ...
- 在Solr中配置中文分词IKAnalyzer
李克华 云计算高级群: 292870151 交流:Hadoop.NoSQL.分布式.lucene.solr.nutch 在Solr中配置中文分词IKAnalyzer 1.在配置文件schema.xml ...
- Solr整合Ansj中文分词器
Ansj的使用和相关资料下载参考:http://iamyida.iteye.com/blog/2220833 参考 http://www.cnblogs.com/luxh/p/5016894.html ...
- 三、Solr多核心及分词器(IK)配置
多核心的概念 多核心说白了就是多索引库.也可以理解为多个"数据库表" 说一下使用multicore的真实场景,比若说,产品搜索和会员信息搜索,不使用多核也没问题,这样带来的问题是 ...
- solr配置ik中文分词(二)
上一篇文章主要介绍了solr的安装与配置,这篇文章主要记录如何使用ik分词器对中文进行分词. 步骤: 1.下载ik分词jar包:ik-analyzer-solr5-5.x.jar. 2.将下载的jar ...
- 全文检索Solr集成HanLP中文分词
以前发布过HanLP的Lucene插件,后来很多人跟我说其实Solr更流行(反正我是觉得既然Solr是Lucene的子项目,那么稍微改改配置就能支持Solr),于是就抽空做了个Solr插件出来,开源在 ...
- solr建立pdf/word/excel索引的方法
PS: 本文假设你已经成功的搭建了一个Solr服务器步骤如下:(1)准备好一份Solr的源码,假设现在保存在c:\apache-solr-1.4.1\目录下(2)从https://issues.apa ...
随机推荐
- mysql错误:Can’t create TCP/IP socket (10106) 解决方法
错误描述 “mysql错误:Can’t create TCP/IP socket (10106)”,目测是socket端口被占用的原因,然后在打开tomcat,报的错误中也包含了“socket”,再一 ...
- 中信信用卡淘气金卡,V金卡,大众点评金卡,易卡白金卡
中信 | 谈谈经典多倍积分卡:易卡&悦卡(超详细+图解+思考)! http://www.flyertea.com/thread-1972766-1-1.html 易卡积分测试,购物/机票/外卖 ...
- windows8.1中组件服务DCOM配置里属性灰色不可修改的解决办法
由于电脑升级,更换成了windows8.1的64位操作系统,今天遇到组件服务中DCOM配置里IIS Admin Service属性呈现灰色,不能修改. 查找官方文档,原来这是win8.1 x64的安全 ...
- django之模型
ORM简介 MVC框架中包括一个重要的部分,就是ORM,它实现了数据模型与数据库的解耦,即数据模型的设计不需要依赖于特定的数据库,通过简单的配置就可以轻松更换数据库 ORM是“对象-关系-映射”的简称 ...
- OpenCL Hello World
▶ OpenCL 的环境配置与第一个程序 ● CUDA 中自带 OpenCL 需要的头文件和库,直接拉近项目里边去就行:AMD 需要下载 AMD APP SDK(https://community.a ...
- maven settings.xml 文件
指定jdk 的版本: <profile> <id>jdk-1.8</id> <activation> <activeByDefault>tr ...
- gen_projective_mosaic(Halcon例子)
* This example program shows how several images of a PCB can be combined * into a large mosaic image ...
- XML解析的二种方法之Sax解析
package com.huawei.xml; import java.io.InputStream;import java.util.Stack; import javax.xml.parsers. ...
- python portia
docker run -i -t --rm -v <PROJECTS_FOLDER>:/app/data/projects:rw -p 9001:9001 scrapinghub/port ...
- Python运维开发基础04-语法基础
上节作业回顾(讲解+温习90分钟) #!/usr/bin/env python3 # -*- coding:utf-8 -*- # author:Mr.chen # 仅用列表+循环实现"简单 ...