
solr学习篇(二) solr 分词器篇
关于solr7.4搭建与配置可以参考 solr7.4 安装配置篇 在这里我们探讨一下分词的配置
目录
1.关于分词
1.分词是指将一个中文词语拆成若干个词,提供搜索引擎进行查找,比如说:北京大学 是一个词那么进行拆分可以得到:北京与大学,甚至北京大学整个词也是一个语义
2.市面上常见的分词工具有 IKAnalyzer MMSeg4j Paoding等,这几个分词器各有优劣,大家可以自行研究
在这篇文章,我先演示IKAnalyzer分词器 下载:IKAnalyzer
2.拷贝相关Jar包与配置
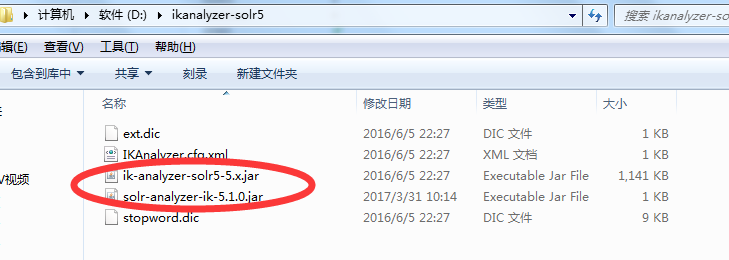
下载解压后 把这两个jar文件复制到solr-7.4.0\server\solr-webapp\webapp\WEB-INF\lib中
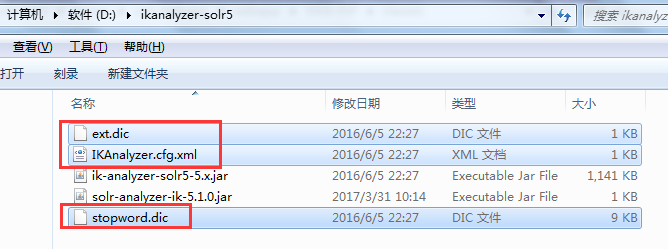
然后在solr-7.4.0\server\solr-webapp\webapp\WEB-INF\目录下新建一个classes目录,把下面三个文件复制进去
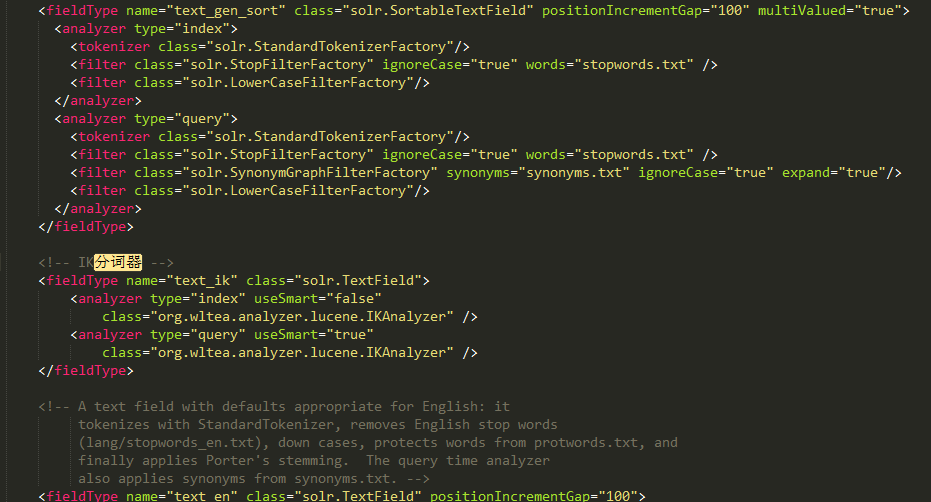
进入之前创建的core 在solr-7.4.0\server\solr\newCore\conf下打开managed-schema.xml 添加如下代码:
 <fieldType name="text_ik" class="solr.TextField">

        <analyzer type="index" useSmart="false"

            class="org.wltea.analyzer.lucene.IKAnalyzer" />

        <analyzer type="query" useSmart="true"

            class="org.wltea.analyzer.lucene.IKAnalyzer" />

</fieldType>
在这里我们发现并没有schema.xml。这是因为Solr版本中(Solr5之前),在创建core的时候,Solr会自动创建好schema.xml,但是在之后的版本中,新加入了动态更新schema功能,这个默认的schema.xml确找不到了,在Solr5以后,这个schema文件已经不是默认生成好的了,它被取了一个名字managed-schema,并且没有后缀。乍一看,以为是打不开的文件,当然没有什么能难倒程序员的,用Sublime Text 3打开,发现了熟悉的文字,这不就是之前的schema.xml文件吗。

3.验证成功
打开服务,打开你所创建的core
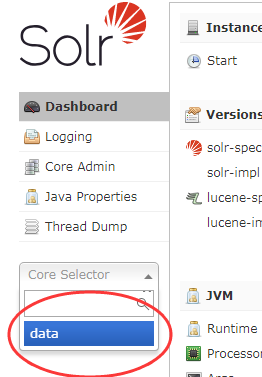
选择Analysis 输入要搜索的中文 选择FieldType为text_ik 可以发现分词成功
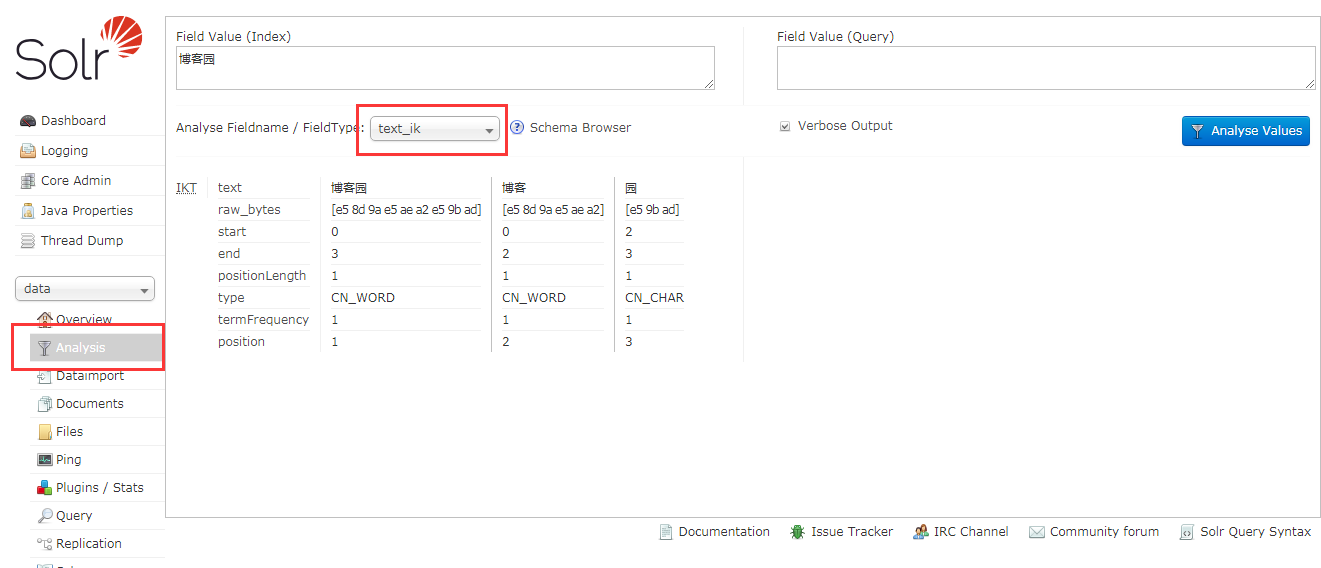
注意filedType一定选择我们配置的分词类型text_ik
----------------------------------------------------------------分割线----------------------------------------------------
有朋友私信说配置好了并没有ik
这是因为本文中我用的 上一篇中的第一种方式创建的code,这种方式连接数据库不是特别好,应该使用第二种命令创建。
但是命令创建后的conf目录是需要去 solr{home}\example\example-DIH\solr\db下的文件进行复制。 详情请参考下一篇。
solr学习篇(二) solr 分词器篇的更多相关文章
- 13.solr学习速成之IK分词器
IKAnalyzer简介 IKAnalyzer是一个开源的,基于java语言开发的轻量级的中文分词工具包. IKAnalyzer特性 a. 算法采用“正向迭代最细粒度切分算法”,支持细粒度和最大词长两 ...
- Solr学习之二-Solr基础知识
一 基本说明 简单来说Solr是基于Lucene的高性能的,开源的Java企业搜索服务器.Solr可以看作一个Web app,运行在tomcat或Jetty这类HTTP服务器上, 底层是一个基于Luc ...
- Solr4.4入门,介绍Solr的安装、IK分词器的配置及高亮查询结果(转)
一.Windows下安装solr-4.4.0 1. 下载solr.4.4 2. 下载绿色版tomcat6.0.18 3. 解压下载的solr到d:\study\solr,将dist目录下的sol ...
- 【three.js详解之二】渲染器篇
[three.js详解之二]渲染器篇 本篇文章将详细讲解three.js中渲染器(renderer)的设置方法. three.js文档中渲染器的分支如下: Renderers CanvasRend ...
- solr英文使用的基本分词器和过滤器配置
solr英文应用的基本分词器和过滤器配置 英文应用分词器和过滤器一般配置顺序 索引(index): 1:空格 WhitespaceTokenizer 2:过滤词(停用词,如:on.of.a.an ...
- solr常用操作及集成分词器或cdh集群部署说明
首先,如果是从http://lucene.apache.org/solr/下载的solr,基本都是自带集成的jetty服务,不需要单独搭建tomcat环境,但是要注意jdk版本,直接解压通过cmd命令 ...
- lucene&solr学习——创建和查询索引(代码篇)
1. Lucene的下载 Lucene是开发全文检索功能的工具包,从官网下载Lucene4.10.3并解压. 官网:http://lucene.apache.org/ 版本:lucene7.7.0 ( ...
- Solr 06 - Solr中配置使用IK分词器 (配置schema.xml)
目录 1 配置中文分词器 1.1 准备IK中文分词器 1.2 配置schema.xml文件 1.3 重启Tomcat并测试 2 配置业务域 2.1 准备商品数据 2.2 配置商品业务域 2.3 配置s ...
- Solr学习笔记---部署Solr到Tomcat上,可视化界面的介绍和使用,Solr的基本内容介绍,SolrJ的使用
学习Solr前需要有Lucene的基础 Lucene的一些简单用法:https://www.cnblogs.com/dddyyy/p/9842760.html 1.部署Solr到Tomcat(Wind ...
随机推荐
- Docker 01 - CentOS 7 中安装 Docker 的详细步骤
目录 1 初识 Docker 1.1 Docker 原理简介 1.2 Docker 核心概念 2 安装 Docker 2.1 查看系统内核版本 2.2 更新 yum 包 2.3 安装软件包 2.4 向 ...
- Android [SharedPreference轻量级存储]
SharedPreferencesActivity.java package com.xdw.a122.data; import android.content.SharedPreferences; ...
- JDBC对Mysql utf8mb4字符集的处理
写在前面 在开发微信小程序的时候,评论服务模块希望添加上emoji表情,但是emoji表情是4个字节长度的,所以需要进行设置 当前项目是JAVA编写, 使用JDBC连接操作数据库, 如下针对的JDBC ...
- win10下安装FFmpeg步骤
1.官方下载地址:https://ffmpeg.zeranoe.com/builds/ # 下载方式一,太慢 # 下载方式二,推荐 2.解压到D:\Program Files (x86),这个看个人喜 ...
- redis分布式锁-自动超时锁(在用)
1.加锁代码结构 2.解锁代码结构 3.java实例 4.测试类 5.测试日志 加锁代码结构 def acquire_lock_with_timeout(conn,lockname,acquire_t ...
- 基于 B/S 端构建的 3D 楼宇自控可视化监控
前言 智慧楼宇和人们的生活息息相关,楼宇智能化程度的提高,会极大程度的改善人们的生活品质,在当前工业互联网大背景下受到很大关注.目前智慧楼宇可视化监控的主要优点包括: 智慧化 -- 智慧楼宇是一个生态 ...
- Eureka实战-4【开启http basic权限认证】
在我们实际生产环境中,都需要考虑到一个安全问题,比如用户登录,又或者是eureka server,它对外暴露的有自己的rest API,如果没有安全认证,也就意味着别人可以通过rest API随意修改 ...
- 01、JDBC连接
① 下载JDBC-MySQL数据库驱动 链接:https://pan.baidu.com/s/1KtSZZ5hXlxu2QrmsXg3lkA 提取码:1pbl ② 加载JDBC-MySQL数据库驱动 ...
- centos7 安装 docker
一.概念 1.Docker引擎 (docker engine) 也称docker daemon,也称为docker服务,只要启动服务,就可以通过docker client发送相关docker命名,与d ...
- mysql 分页offset过大性能问题解决思路
在公司干活一般使用sqlserver数据库.rownumber分页贼好用. 但是晚上下班搞自己的事情就不用sqlserver了.原因就是自己的渣渣1核2g的小服务器完全扛不住sqlserver那么大的 ...