
Fiddler 手机爬虫
Fiddler抓包工具
配置Fiddler
- 添加证书信任,Tools - Options - HTTPS,勾选 Decrypt Https Traffic 后弹出窗口,一路确认
- ...from browsers only 设置只抓取浏览器的数据包
- Tools - Options - Connections,设置监听端口(默认为8888)
- 关闭Fiddler,再打开Fiddler,配置完成后重启Fiddler(重要)
配置浏览器代理
1、安装Proxy SwitchyOmega插件
2、浏览器右上角:SwitchyOmega->选项->新建情景模式->AID1901(名字)->创建
输入 :HTTP:// 127.0.0.1 8888
点击 :应用选项
3、点击右上角SwitchyOmega可切换代理
Fiddler常用菜单
1、Inspector :查看数据包详细内容
整体分为请求和响应两部分
2、常用菜单
Headers :请求头信息
WebForms: POST请求Form表单数据 :<body>
GET请求查询参数: <QueryString>
Raw 将整个请求显示为纯文本
手机设置
正常版
1、设置手机
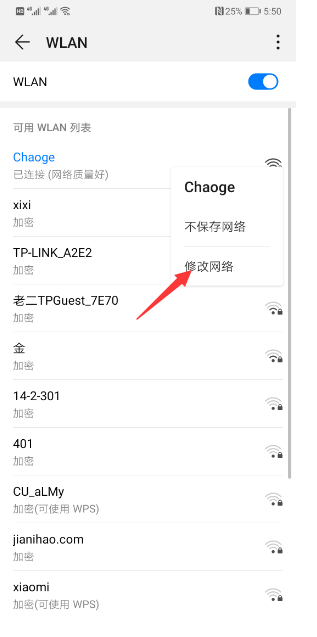
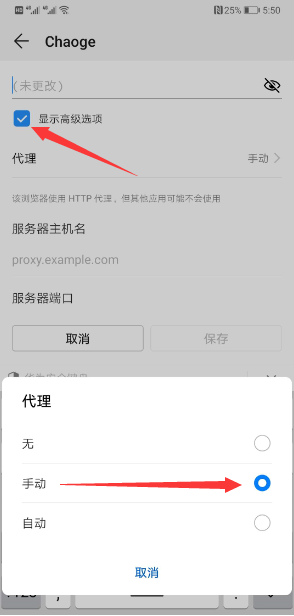
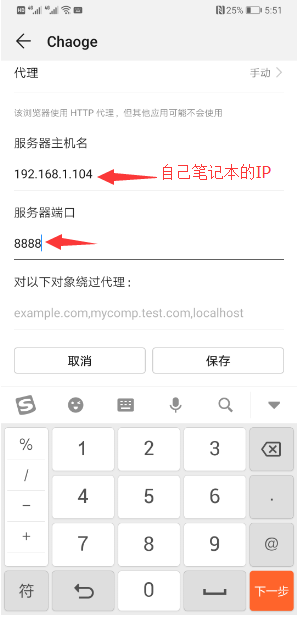
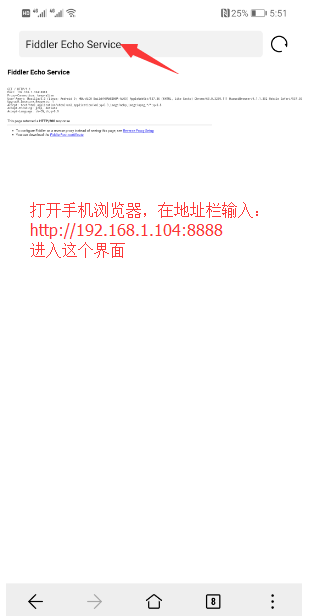
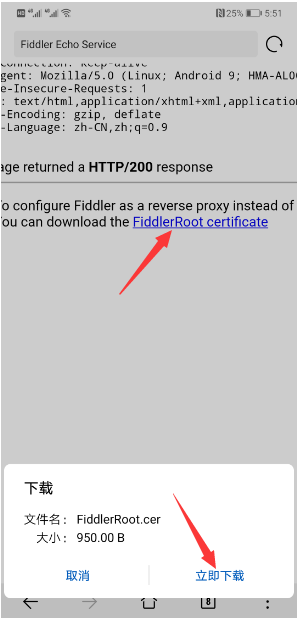
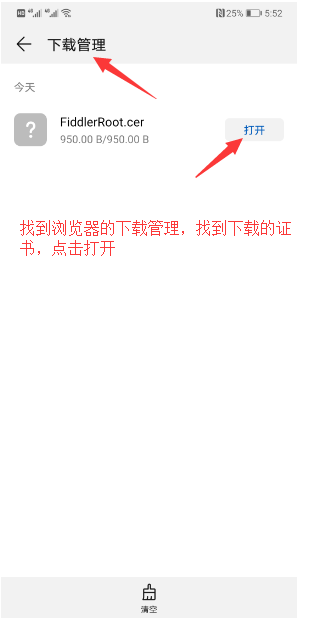
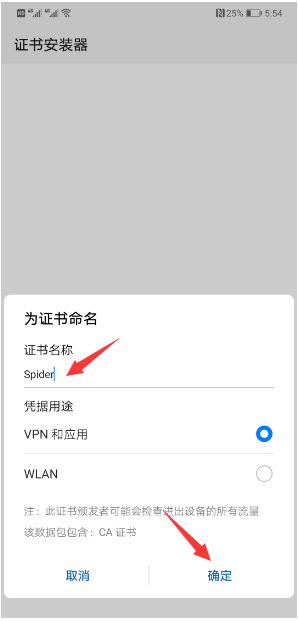
2、设置Fiddler
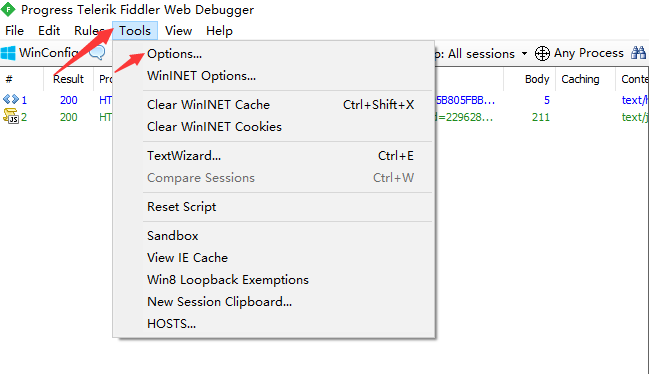
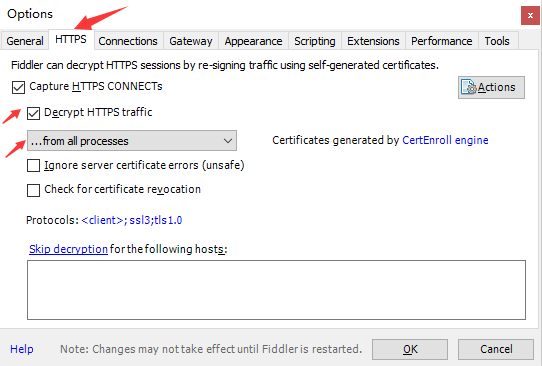
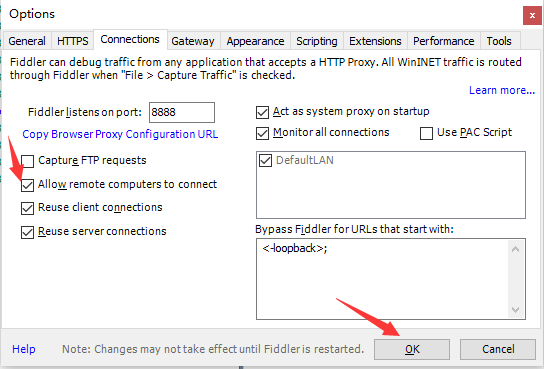
最后重启Fiddler。
如果遇到问题
在计算机中win+R,输入regedit打开注册表,找到fiddler,右键新建点击OWORD(64位)值Q,
名称:80;类型:REG_DWORD;数据:0x00000000(0)
Fiddler在上面的设置下,加上:菜单栏Rules-->Customize Rules...-->重启Fiddler
移动端app数据抓取
有道翻译手机版破解案例
import requests
from lxml import etree
word = input('请输入要翻译的单词:')
url = 'http://m.youdao.com/translate'
data = {
'inputtext': word,
'type': 'AUTO',
}
html = requests.post(url,data=data).text
parse_html = etree.HTML(html)
result = parse_html.xpath('//ul[@id="translateResult"]/li/text()')[0]
print(result)
途牛旅游
目标:完成途牛旅游爬取系统,输入出发地、目的地,输入时间,抓取热门景点信息及相关评论
地址
1、地址: http://www.tuniu.com/
2、热门 - 搜索
3、选择: 相关目的地、出发城市、出游时间(出发时间和结束时间)点击确定
4、示例地址如下:
http://s.tuniu.com/search_complex/whole-sh-0-%E7%83%AD%E9%97%A8/list-a{触发时间}_{结束时间}-{出发城市}-{相关目的地}/
项目实现
1、创建项目
scrapy startproject Tuniu

cd Tuniu

scrapy genspider tuniu tuniu.com
2、定义要抓取的数据结构 - items.py
# 一级页面
# 标题 + 链接 + 价格 + 满意度 + 出游人数 + 点评人数 + 推荐景点 + 供应商
title = scrapy.Field()
link = scrapy.Field()
price = scrapy.Field()
satisfaction = scrapy.Field()
travelNum = scrapy.Field()
reviewNum = scrapy.Field()
recommended = scrapy.Field()
supplier = scrapy.Field()
# 二级页面
# 优惠券 + 产品评论
coupons = scrapy.Field()
cp_comments = scrapy.Field()
3、爬虫文件数据分析与提取
页面地址分析
http://s.tuniu.com/search_complex/whole-sh-0-热门/list-a20190828_20190930-l200-m3922/
# 分析
list-a{出发时间_结束时间-出发城市-相关目的地}/
# 如何解决?
提取 出发城市及目的地城市的字典,key为城市名称,value为其对应的编码
# 提取字典,定义config.py存放
代码实现
# -*- coding: utf-8 -*-
import scrapy
from ..config import *
from ..items import TuniuItem
import json
class TuniuSpider(scrapy.Spider):
name = 'tuniu'
allowed_domains = ['tuniu.com']
def start_requests(self):
s_city = input('出发城市:')
d_city = input('相关目的地:')
start_time = input('出发时间(20190828):')
end_time = input('结束时间(例如20190830):')
s_city = src_citys[s_city]
d_city = dst_citys[d_city]
url = 'http://s.tuniu.com/search_complex/whole-sh-0-%E7%83%AD%E9%97%A8/list-a{}_{}-{}-{}'.format(start_time,end_time,s_city, d_city)
yield scrapy.Request(url, callback=self.parse)
def parse(self, response):
# 提取所有景点的li节点信息列表
items = response.xpath('//ul[@class="thebox clearfix"]/li')
for item in items:
# 此处是否应该在for循环内创建?
tuniuItem = TuniuItem()
# 景点标题 + 链接 + 价格
tuniuItem['title'] = item.xpath('.//span[@class="main-tit"]/@name').get()
tuniuItem['link'] = 'http:' + item.xpath('./div/a/@href').get()
tuniuItem['price'] = int(item.xpath('.//div[@class="tnPrice"]/em/text()').get())
# 判断是否为新产品
isnews = item.xpath('.//div[@class="new-pro"]').extract()
if not len(isnews):
# 满意度 + 出游人数 + 点评人数
tuniuItem['satisfaction'] = item.xpath('.//div[@class="comment-satNum"]//i/text()').get()
tuniuItem['travelNum'] = item.xpath('.//p[@class="person-num"]/i/text()').get()
tuniuItem['reviewNum'] = item.xpath('.//p[@class="person-comment"]/i/text()').get()
else:
tuniuItem['satisfaction'] = '新产品'
tuniuItem['travelNum'] = '新产品'
tuniuItem['reviewNum'] = '新产品'
# 包含景点+供应商
tuniuItem['recommended'] = item.xpath('.//span[@class="overview-scenery"]/text()').extract()
tuniuItem['supplier'] = item.xpath('.//span[@class="brand"]/span/text()').extract()
yield scrapy.Request(tuniuItem['link'], callback=self.item_info, meta={'item': tuniuItem})
# 解析二级页面
def item_info(self, response):
tuniuItem = response.meta['item']
# 优惠信息
coupons = ','.join(response.xpath('//div[@class="detail-favor-coupon-desc"]/@title').extract())
tuniuItem['coupons'] = coupons
# 想办法获取评论的地址
# 产品点评 + 酒店点评 + 景点点评
productId = response.url.split('/')[-1]
# 产品点评
cpdp_url = 'http://www.tuniu.com/papi/tour/comment/product?productId={}'.format(productId)
yield scrapy.Request(cpdp_url, callback=self.cpdp_func, meta={'item': tuniuItem})
# 解析产品点评
def cpdp_func(self, response):
tuniuItem = response.meta['item']
html = json.loads(response.text)
comment = {}
for s in html['data']['list']:
comment[s['realName']] = s['content']
tuniuItem['cp_comments'] = comment
yield tuniuItem
4、管道文件处理 pipelines.py
print(dict(item))
5、设置settings.py
获取出发城市和目的地城市的编号
tools.py
# 出发城市
# 基准xpath表达式
//*//*[@id="niuren_list"]/div[2]/div[1]/div[2]/div[1]/div/div[1]/dl/dd/ul/li[contains(@class,"filter_input")]/a
name : ./text()
code : ./@href [0].split('/')[-1].split('-')[-1]
# 目的地城市
# 基准xpath表达式
//*[@id="niuren_list"]/div[2]/div[1]/div[2]/div[1]/div/div[3]/dl/dd/ul/li[contains(@class,"filter_input")]/a
name : ./text()
code : ./@href [0].split('/')[-1].split('-')[-1]
代码实现
import requests
from lxml import etree
url = 'http://s.tuniu.com/search_complex/whole-sh-0-%E7%83%AD%E9%97%A8/'
headers = {'User-Agent':'Mozilla/5.0'}
html = requests.get(url,headers=headers).text
parse_html = etree.HTML(html)
# 获取出发地字典
# 基准xpath
li_list = parse_html.xpath('//*[@id="niuren_list"]/div[2]/div[1]/div[2]/div[1]/div/div[3]/dl/dd/ul/li[contains(@class,"filter_input")]/a')
src_citys = {}
dst_citys = {}
for li in li_list:
city_name_list = li.xpath('./text()')
city_code_list = li.xpath('./@href')
if city_name_list and city_code_list:
city_name = city_name_list[0].strip()
city_code = city_code_list[0].split('/')[-1].split('-')[-1]
src_citys[city_name] = city_code
print(src_citys)
# 获取目的地字典
li_list = parse_html.xpath('//*[@id="niuren_list"]/div[2]/div[1]/div[2]/div[1]/div/div[1]/dl/dd/ul/li[contains(@class,"filter_input")]/a')
for li in li_list:
city_name_list = li.xpath('./text()')
city_code_list = li.xpath('./@href')
if city_name_list and city_code_list:
city_name = city_name_list[0].strip()
city_code = city_code_list[0].split('/')[-1].split('-')[-1]
dst_citys[city_name] = city_code
print(dst_citys)
Fiddler 手机爬虫的更多相关文章
- Fiddler手机抓包工具如何设置过滤域名?
fiddler手机抓包工具如何设置过滤域名?如题.fiddler抓包可以完成我们移动开发者的调试测试需求.所以说抓包尤其重要,但是多余的网页请求和手机的其他链接影响我们手机开发的需求.下面我教大家怎么 ...
- fiddler 手机 https 抓包 以及一些fiddler无法解决的https问题http2、tcp、udp、websocket证书写死在app中无法抓包
原文: https://blog.csdn.net/wangjun5159/article/details/52202059 fiddler手机抓包原理 fiddler手机抓包的原理与抓pc上的web ...
- 使用Fiddler手机抓包https-----重要
Fiddler不仅可以对手机进行抓包,还可以抓取别的电脑的请求包,今天就想讲一讲使用Fiddler手机抓包! 使用Fiddler手机抓包有两个条件: 一:手机连的网络或WiFi必须和电脑(使用fidd ...
- Fiddler手机https抓包
Fiddler手机抓包:https://blog.csdn.net/wangjun5159/article/details/52202059 fiddler 使用说明:https://www.cnbl ...
- fiddler手机抓包配置方法
一.下载工具包 百度搜索”fiddler 下载“ ,安装最新版本 下载的软件安装包为“fiddler_4.6.20171.26113_setup.exe”格式,双击安装.安装成功,在“开始”-“所有程 ...
- fiddler 手机 https 抓包
fiddler手机抓包原理fiddler手机抓包的原理与抓pc上的web数据一样,都是把fiddler当作代理,网络请求走fiddler,fiddler从中拦截数据,由于fiddler充当中间人的角色 ...
- fiddler手机抓包教程
序言 记录一下自己第一次使用fiddler抓取手机的信息,做一个备忘 实现步骤 一.首先设置一下fiddler,使其对HTTPS协议进行抓包 二.然后设置fidder使得fiddler支持远程计算机连 ...
- [fiddler] 手机抓包
最近工作涉及到与原生app联调,需要抓取手机上的请求.借此机会研究了下fiddler,简直神器. 以下简单介绍通过fiddler进行手机抓包的方法,之后也会陆续更新fiddler的其他功能 设置fid ...
- 使用fiddler手机抓包
Fiddler不但能截获各种浏览器发出的HTTP请求, 也可以截获各种智能手机发出的HTTP/HTTPS请求. Fiddler能捕获IOS设备发出的请求,比如IPhone, IPad, MacBook ...
随机推荐
- ajax定义与开发最简五步骤
ajax是什么? a (async异步) j (javascript) a (and) x (xml)即异步的javascript和xml ajax特点:异步 不刷新整个页面 (局部刷新) we ...
- .net core web api部署到Linux系统CentOS 7
一.创建一个.net core web api 的Demo 完成后的项目结构如图 修改下监听端口 发布代码 二.发布到CentOS 7上并运行 下一步需要一定的虚拟机知识了,我这里使用了windows ...
- 【游记】NOIP2018初赛
声明 本文最初的版本创建之时,本人甚至只是个电脑的小白,因而不太会用电脑编辑文字,最初的版本写在一个Word文档里,被随意的丢弃在我杂乱无比的网盘的某一个角落,直到我决定整理自己的成长历程,将散落的游 ...
- 洛谷 P3203 [HNOI2010]弹飞绵羊
题意简述 有n个点,第i个点有一个ki,表示到达i这个点后可以到i + ki这个点 支持修改ki和询问一点走几次能走出所有点两个操作 题解思路 分块, 对于每个点,维护它走到下一块所经过的点数,它走到 ...
- Spring入门(九):运行时值注入
Spring提供了2种方式在运行时注入值: 属性占位符(Property placeholder) Spring表达式语言(SpEL) 1. 属性占位符 1.1 注入外部的值 1.1.1 使用Envi ...
- GoAccess 分析 Nginx 日志
0x00 事件 帮助朋友搭建了博客,运行过了一段时间,准备发个网站分析报告给他. 有效的数据只有 Nginx 的访问日志,于是使用决定 GoAccess 工具对这个日志进行分析, 0x01 安装 吾使 ...
- ASP.NET Core MVC 之依赖注入 Controller
ASP.NET Core MVC 控制器应通过构造函数明确地请求它们地依赖关系,在某些情况下,单个控制器地操作可能需要一个服务,在控制器级别上的请求可能没有意义.在这种情况下,也可以将服务作为 Ac ...
- 从IDEA角度来看懂UML图
前言 我们目前已经学习了设计模式的7种设计原则.下面本该是直接进入具体的设计模式系列文章. 但是呢在我们学习设计模式之前我们还是有必要了解一下uml图.因为后续的设计模式文章不出意外应该会很多地方使用 ...
- ThinkPHP 跟踪日志设置、默认分组设置
跟踪日志: 做配置 ‘SHOW_PAGE_TRACE’ => true 默认分组: 做配置 ‘MODULE_ALLOW_LIST’ => array(‘Home’,’Admin’)
- 你真的了JMeter解聚合报告么?
1.背景 大家在使用JMeter进行性能测试时,聚合报告(Aggregate Report)可以说是必用的监听器,但是你真的了解聚合报告么? 2.目的 本次笔者跟大家聊聊聚合报告(Aggregate ...