
Attention 和self-attention
1.Attention
最先出自于Bengio团队一篇论文:NEURAL MACHINE TRANSLATION BY JOINTLY LEARNING TO ALIGN AND TRANSLATE ,论文在2015年发表在ICLR。
encoder-decoder模型通常的做法是将一个输入的句子编码成一个固定大小的state,然后将这样的一个state输入到decoder中的每一个时刻,这种做法对处理长句子会很不利,尤其是随着句子长度的增加,效果急速下滑。
论文动机:是针对encoder-decoder长句子翻译效果不好的问题。
解决原理:仿造人脑结构,对一张图片或是一个句子,能够重点关注到不同部分。
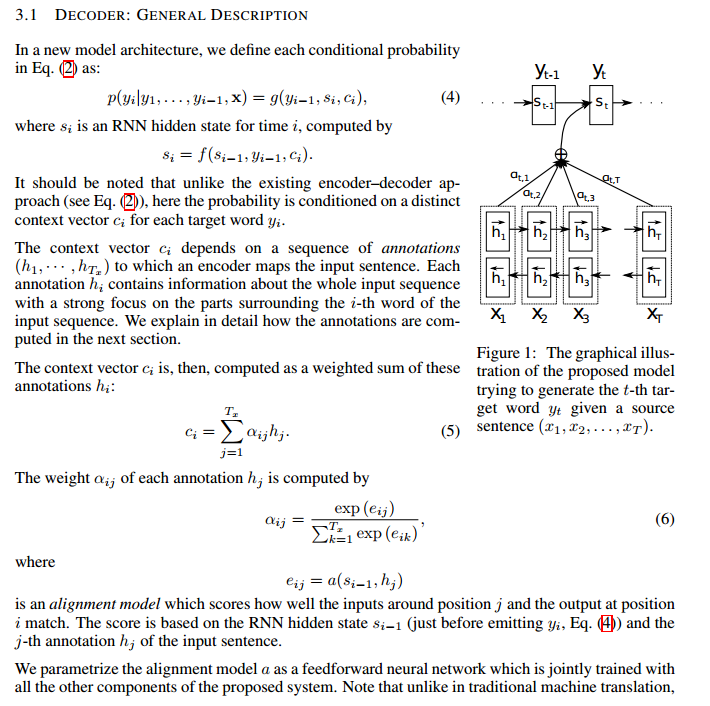
论文解决思路:在生成当前词的时候,只要把上一个state与所有的input word作为融合,而后做一个权重计算。通过这种方式生成的词就会有针对性,在句子长度较长时效果尤其明显。
整体框架如下图:
2.Self-attention
出自于Google团队的论文:Attention Is All You Need ,2017年发表在NIPS。
论文动机:RNN本身的结构,阻碍了并行化;同时RNN对长距离依赖问题,效果会很差。
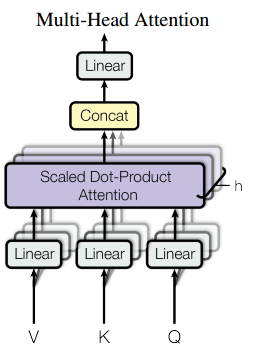
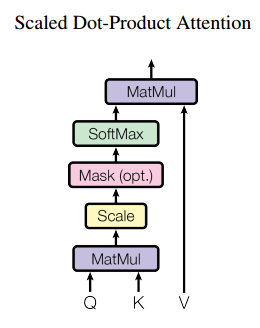
解决思路:通过不同词向量之间矩阵相乘,得到一个词与词之间的相似度,进而无距离限制。
整体结构:

multi-head attention:
将一个词的vector切分成h个维度,求attention相似度时每个h维度计算。由于单词映射在高维空间作为向量形式,每一维空间都可以学到不同的特征,相邻空间所学结果更相似,相较于全体空间放到一起对应更加合理。比如对于vector-size=512的词向量,取h=8,每64个空间做一个attention,学到结果更细化。
self-attention:
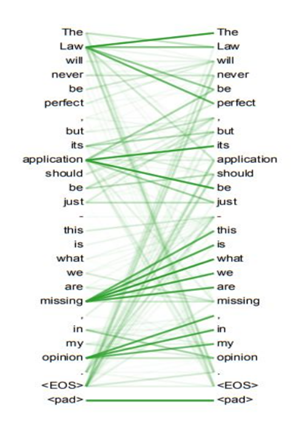
每个词位的词都可以无视方向和距离,有机会直接和句子中的每个词encoding。比如下图这个句子,每个单词和同句其他单词之间都有一条边作为联系,边的颜色越深表明联系越强,而一般意义模糊的词语所连的边都比较深。比如:law,application,missing,opinion。
Attention 和self-attention的更多相关文章
- 注意力机制---Attention、local Attention、self Attention、Hierarchical attention
一.编码-解码架构 目的:解决语音识别.机器翻译.知识问答等输出输入序列长度不相等的任务. C是输入的一个表达(representation),包含了输入序列的有效信息. 它可能是一个向量,也可能是一 ...
- 可视化展示attention(seq2seq with attention in tensorflow)
目前实现了基于tensorflow的支持的带attention的seq2seq.基于tf 1.0官网contrib路径下seq2seq 由于后续版本不再支持attention,迁移到melt并做了进一 ...
- (转)注意力机制(Attention Mechanism)在自然语言处理中的应用
注意力机制(Attention Mechanism)在自然语言处理中的应用 本文转自:http://www.cnblogs.com/robert-dlut/p/5952032.html 近年来,深度 ...
- 注意力机制(Attention Mechanism)在自然语言处理中的应用
注意力机制(Attention Mechanism)在自然语言处理中的应用 近年来,深度学习的研究越来越深入,在各个领域也都获得了不少突破性的进展.基于注意力(attention)机制的神经网络成为了 ...
- Attention and Augmented Recurrent Neural Networks
Attention and Augmented Recurrent Neural Networks CHRIS OLAHGoogle Brain SHAN CARTERGoogle Brain Sep ...
- (转)Attention
本文转自:http://www.cosmosshadow.com/ml/%E7%A5%9E%E7%BB%8F%E7%BD%91%E7%BB%9C/2016/03/08/Attention.ht ...
- Multimodal —— 看图说话(Image Caption)任务的论文笔记(二)引入attention机制
在上一篇博客中介绍的论文"Show and tell"所提出的NIC模型采用的是最"简单"的encoder-decoder框架,模型上没有什么新花样,使用CNN ...
- 深度学习之seq2seq模型以及Attention机制
RNN,LSTM,seq2seq等模型广泛用于自然语言处理以及回归预测,本期详解seq2seq模型以及attention机制的原理以及在回归预测方向的运用. 1. seq2seq模型介绍 seq2se ...
- Attention Model(注意力模型)思想初探
1. Attention model简介 0x1:AM是什么 深度学习里的Attention model其实模拟的是人脑的注意力模型,举个例子来说,当我们观赏一幅画时,虽然我们可以看到整幅画的全貌,但 ...
- 【NLP】Attention Model(注意力模型)学习总结
最近一直在研究深度语义匹配算法,搭建了个模型,跑起来效果并不是很理想,在分析原因的过程中,发现注意力模型在解决这个问题上还是很有帮助的,所以花了两天研究了一下. 此文大部分参考深度学习中的注意力机制( ...
随机推荐
- 使用Spring Boot和AspectJ实现方法跟踪基础结构
了解如何使用Spring Boot和AspectJ实现方法跟踪基础结构!最近在优锐课学习收获颇多,记录下来大家一起进步! 在我们的应用程序中,获取方法的堆栈跟踪信息可能会节省很多时间.具有输入输出参数 ...
- Mybatis需要注意的细节
mybatis第二篇 1.${}和#{}的区别 1.#在传参的时候,会自动拼接单引号:$不能拼接单引号; 2.$传参时,一般不支持jdbcType指定类型的写法;#则可以;如: #{name,jd ...
- Vue基础简介
目录 vue基础 一.导入vue 二.vue挂载点 三.vue变量 四.vue事件 五.vue文本指令 六.vue事件指令 七.vue属性指令 vue基础 一.导入vue 补充:vue的语句以及导入j ...
- Caffe源码-Net类(上)
Net类简介 Net类主要处理各个Layer之间的输入输出数据和参数数据共享等的关系.由于Net类的代码较多,本次主要介绍网络初始化部分的代码.Net类在初始化的时候将各个Layer的输出blob都统 ...
- 构建 CDN 分发网络架构简析
构建 CDN 分发网络架构 CDN的基本目的:1.通过本地缓存实现网站的访问速度的提升 CDN的关键点:CNAME在域名解析:split智能分发,引流到最近缓存节点
- 多线程之美2一ThreadLocal源代码分析
目录结构 1.应用场景及作用 2.结构关系 2.1.三者关系类图 2.2.ThreadLocalMap结构图 2.3. 内存引用关系 2.4.存在内存泄漏原因 3.源码分析 3.1.重要代码片段 3. ...
- 远程桌面MATLAB启动失败问题解决
博客:博客园 | CSDN | blog 远程桌面打开MATLAB会报错,解决办法,打开matlab的licenses路径,如matlab/R2017b/licenses/,路径下存有license文 ...
- Idea集成及使用svn插件
1 idea集成svn 1.1 svn是什么? SVN是subversion的缩写,是一个开放源代码的版本控制系统,通过采用分支管理系统的高效管理,简而言之就是用于多个人共同开发同一个项目,实现共享资 ...
- 解决Android killer APK 编译失败,无法继续下一步签名
报错特征 在应用市场上下载了一个APK,使用Androd killer的编译的功能,结果报错了,报错信息如下: > ... 14 more APK 编译失败,无法继续下一步签名! 解决 解决 ...
- Scrum Meeting - 第七周【Alpha阶段】
每日任务内容: 本次会议为第七次Scrum Meeting会议 本次会议项目经理召开时间为20:00,在北区男生宿舍楼召开,召开时长约10分钟,探讨了本周选课网站编写的后续工作. 小组成员 本周任务 ...