
oracle学习笔记(三)
索引:
drop table test1 purge;

drop table test2 purge;

drop table test3 purge;

drop table t purge;

create table t as select * from dba_objects;

create table test1 as select * from t;

create table test2 as select * from t;

create table test3 as select * from t;

create index idx_owner on test1(owner);

create index idx_object_name on test1(object_name);

create index idx_data_obj_id on test1(data_object_id);

create index idx_created on test1(created);

create index idx_last_ddl_time on test1(last_ddl_time);

create index idx_status on test1(status);

create index idx_t2_sta on test2(status);

create index idx_t2_objid on test2(object_id);

set timing on

--语句1(test1表有6个索引)

insert into test1 select * from t;

commit;

--语句2(test2表有2个索引)

insert into test2 select * from t;

commit;

--语句3(test3表有无索引)

insert into test3 select * from t;

commit;
生产库中一般没有索引,查询库中有大量的索引,生产库要执行插入操作。
drop table t purge;

create table t as select * from dba_objects;

insert into t select * from t;

insert into t select * from t;

commit;

--请从这里开始注意累加的时间(从建索引到插入记录完毕)

set timing on

create index idx_t_owner on t(owner);

create index idx_t_obj_name on t(object_name);

create index idx_t_data_obj_id on t(data_object_id);

create index idx_t_created on t(created);

create index idx_t_last_ddl on t(last_ddl_time);

--语句1(t表有6个索引)

insert into t select * from t;

commit;
--以下进行试验2

drop table t purge;

create table t as select * from dba_objects;

insert into t select * from t;

insert into t select * from t;

commit;

---开始注意累加的时间(从插入记录完毕到建索引完毕)

set timing on

--语句1(t表有6个索引,此时先不建)

insert into t select * from t;

create index idx_t_owner on t(owner);

create index idx_t_obj_name on t(object_name);

create index idx_t_data_obj_id on t(data_object_id);

create index idx_t_created on t(created);

create index idx_t_last_ddl on t(last_ddl_time);
分区效率变低:
分区表

drop table part_tab purge;

create table part_tab (id int,col2 int,col3 int)

        partition by range (id)

        (

        partition p1 values less than (10000),

        partition p2 values less than (20000),

        partition p3 values less than (30000),

        partition p4 values less than (40000),

        partition p5 values less than (50000),

        partition p6 values less than (60000),

        partition p7 values less than (70000),

        partition p8 values less than (80000),

        partition p9 values less than (90000),

        partition p10 values less than (100000),

        partition p11 values less than (maxvalue)

        )

        ;

普通表

insert into part_tab select rownum,rownum+1,rownum+2 from dual connect by rownum <=110000;

commit;

create  index idx_par_tab_col2 on part_tab(col2) local;

create  index idx_par_tab_col3 on part_tab(col3) ;

drop table norm_tab purge;

create table norm_tab  (id int,col2 int,col3 int);

insert into norm_tab select rownum,rownum+1,rownum+2 from dual connect by rownum <=110000;

commit;

create  index idx_nor_tab_col2 on norm_tab(col2) ;

create  index idx_nor_tab_col3 on norm_tab(col3) ;

set autotrace traceonly statistics

set linesize 1000

set timing on

select * from part_tab where col2=8 ;

select * from norm_tab where col2=8 ;

select * from part_tab where col2=8 and id=2;

select * from norm_tab where col2=8 and id=2;

--查看索引高度等信息

select index_name,

          blevel,

          leaf_blocks,

          num_rows,

          distinct_keys,

          clustering_factor

     from user_ind_statistics

    where table_name in( 'NORM_TAB');

select index_name,

          blevel,

          leaf_blocks,

          num_rows,

          distinct_keys,

          clustering_factor FROM USER_IND_PARTITIONS where index_name like 'IDX_PAR_TAB%';
无索引:
--最慢速度(无索引)

drop table t purge;

create table t as  select * from dba_objects;

alter table T modify OBJECT_NAME not null;

select count(*) from t;

set autotrace traceonly

set linesize 1000

set timing on

select COUNT(*) FROM T;

--快了一点(有普通索引)

drop table t purge;

create table t as  select * from dba_objects;

alter table T modify OBJECT_NAME not null;

create  index idx_object_name on t(object_name);

set autotrace traceonly

set timing on

select count(*) from t;
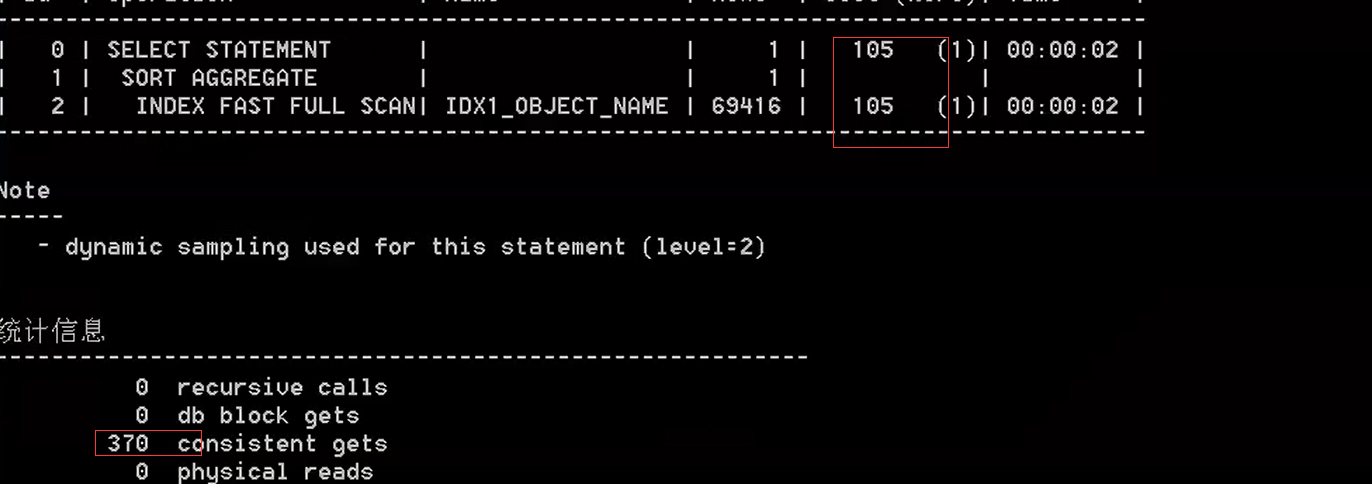
--又快一点(有了一个合适的位图索引)

drop table t purge;

create table t as  select * from dba_objects;

 Update t  Set object_name='abc';

 Update t Set object_name='evf' Where rownum<=20000;

create bitmap index idx_object_name on t(object_name);

set autotrace traceonly

set timing on

select count(*) from t;
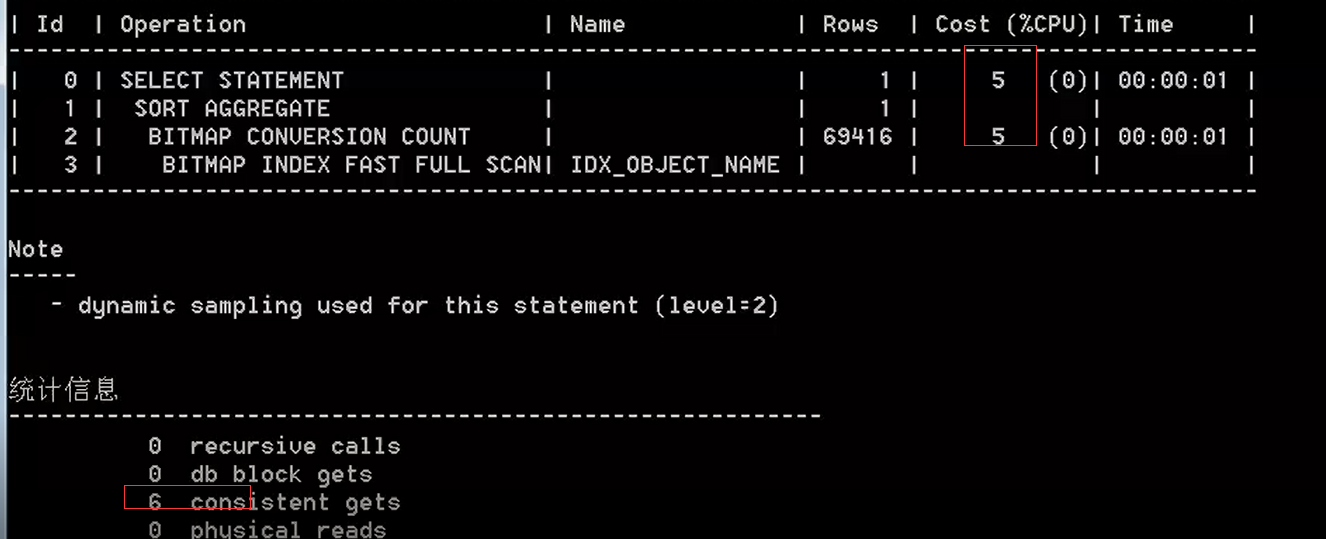
如果记录数不重复或者说重复度很低,ORACLE会选择全表扫描,如果用

来强制,可以发现性能很低下。

alter session set statistics_level=all ;

set linesize 1000

set pagesize 1

select /*+index(t,idx_object_name)*/ count(*) from test t;

select * from table(dbms_xplan.display_cursor(null,null,'allstats last'));
物化视图:(用空间换取时间)
drop materialized view MV_COUNT_T;

drop table t purge;

create table t as  select * from dba_objects;

 Update t  Set object_name='abc';

 Update t Set object_name='evf' Where rownum<=20000;

create  materialized view  mv_count_t

                    build immediate

                    refresh on commit

                    enable query rewrite

                    as

                    select count(*) FROM T;

set autotrace traceonly

set linesize 1000

select COUNT(*) FROM T;
--又再快一点(缓存结果集,也是要注意使用的场景)

drop table t purge;

create table t as  select * from dba_objects;

select count(*) from t;

set linesize 1000

set autotrace traceonly

select /*+ result_cache */ count(*) from t;
提高sql的运行速度:
未优化:
create or replace procedure proc_0

as

begin

    for i in 1 .. 100000

    loop

        execute immediate

        'insert into t values ( '||i||')';

    commit;

    end loop;

end;

/

exec proc_0;
一:绑定变量
create or replace procedure proc_1

as

begin

    for i in 1 .. 100000

    loop

        execute immediate

        'insert into t values ( :x )' using i ;

        commit;

    end loop;

end;

/

exec proc_1;
二:动态sql 改成静态sql(涉及到的表名和列明不存在,考虑使用动态sql)
create or replace procedure proc_2

as

begin

    for i in 1 .. 100000

    loop

     insert into t values (i);

     commit;

    end loop;

end;

/

exec proc_2;
三:批量提交
create or replace procedure proc_3

as

begin

    for i in 1 .. 100000

    loop

     insert into t values (i);

    end loop;

  commit;

end;

/

exec proc_3;
四:集合写法
insert into t select rownum from dual connect by level<=100000;

commit;
五:直接路劲读
create table t as select rownum x from dual connect by level<=100000;
六:并行设置
create table t nologging parallel 64

as select rownum x from dual connect by level<=100000;
要求为(行列转换,超过3个的只取三个,不足3个的用空格来补列)
DROP TABLE TEST;

CREATE TABLE TEST ( ID1 NUMBER,ID2 NUMBER,VALUE1 VARCHAR2(20),VALUE2 VARCHAR2(20));

INSERT INTO TEST VALUES (1,2,'A','B');

INSERT INTO TEST VALUES (1,2,'C','D');

INSERT INTO TEST VALUES (1,2,'E','F');

INSERT INTO TEST VALUES (1,2,'G','H');

INSERT INTO TEST VALUES (3,8,'I','J');

INSERT INTO TEST VALUES (3,8,'K','L');

INSERT INTO TEST VALUES (3,8,'M','N');

INSERT INTO TEST VALUES (8,9,'O','P');

INSERT INTO TEST VALUES (8,9,'Q','R');

INSERT INTO TEST VALUES (11,12,'S','T');

COMMIT;

SQL> SELECT * FROM TEST;

       ID1        ID2 VALUE1               VALUE2

---------- ---------- -------------------- --------------------

         1          2 A                    B

         1          2 C                    D

         1          2 E                    F

         1          2 G                    H

         3          8 I                    J

         3          8 K                    L

         3          8 M                    N

         8          9 O                    P

         8          9 Q                    R

        11         12 S                    T

10 rows selected

ID1        ID2 VALUE1               VALUE2  VALUE3               VALUE4  VALUE5               VALUE6

---------- ---------- -------------------- -------------------------------------------------------------

1           2    A                    B      C                    D        E                   F

3           8    I                    J      K                    L        M                   N

8           9    O                    P      Q                    R        NULL                NULL

11         12    S                    T      NULL                 NULL     NULL                NULL

我们可以通过MAX+分析函数实现如下:

SELECT ID1,ID2

      ,MAX(DECODE(RN,1,VALUE1))

      ,MAX(DECODE(RN,1,VALUE2))

      ,MAX(DECODE(RN,2,VALUE1))

      ,MAX(DECODE(RN,2,VALUE2))

      ,MAX(DECODE(RN,3,VALUE1))

      ,MAX(DECODE(RN,3,VALUE2))

  FROM (SELECT TEST.*, ROW_NUMBER() OVER(PARTITION BY ID1,ID2 ORDER BY VALUE1,VALUE2) RN FROM TEST) T

WHERE RN<=3

GROUP BY ID1,ID2;
可以将SQL改造为如下
WITH T AS

(select hopbyhop,

               svcctx_id,

               substr(cause,

                      instr(cause, 'Host = ') + 7,

                      instr(cause, 'Priority = ') - instr(cause, 'Host = ') - 11) peer,

               substr(cause,

                      instr(cause, 'Priority = ') + 11,

                      instr(cause, 'reachable = ') -

                      instr(cause, 'Priority = ') - 13) priority

          from dcc_sys_log

         where cause like '%SC路由应答%'

           and hopbyhop in (select distinct hopbyhop from dcc_sys_log))---此处多余!

SELECT hopbyhop,svcctx_id,

       MAX(DECODE(RN,1,PEER)) PEER1

      ,MAX(DECODE(RN,1,PRIORITY)) PRIORITY1

      ,MAX(DECODE(RN,2,PEER))  PEER2

      ,MAX(DECODE(RN,2,PRIORITY))  PRIORITY2

      ,MAX(DECODE(RN,3,PEER)) PEER3

      ,MAX(DECODE(RN,3,PRIORITY)) PRIORITY3

 FROM (SELECT T.*, ROW_NUMBER() OVER(PARTITION BY hopbyhop,svcctx_id ORDER BY PEER,PRIORITY) RN FROM T)

WHERE RN<=3

GROUP BY hopbyhop,svcctx_id;
注:涉及到结果集多次使用的时候,尽量用WITH子句,来减少代码,并且易于维护,这个WITH子句处的处理逻辑如下,

只是为了取出Host = 的值和Priority = 的值

SQL>  SELECT substr('SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true',

  2                        instr('SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true', 'Host = ') + 7,

  3                        instr('SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true', 'Priority = ') - instr('SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true', 'Host = ') - 11) peer,

  4                 substr('SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true',

  5                        instr('SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true', 'Priority = ') + 11,

  6                        instr('SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true', 'reachable = ') -

  7                        instr('SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true', 'Priority = ') - 13) priority

  8  from dual;
写死长度比较不科学,万一数据变化了,值就错误了,写相对位置也比较简单,只要能将层次分清楚即显的简单:
with data as (SELECT 'SC路由应答:Host = SR2@001.ChinaTelecom.com, Priority = 1, reachable = true' as str

                    ,'Host = ' k1

                    ,'Priority = ' k2

               FROM DUAL)

,data2 AS (SELECT data.*,INSTR(str,k1) p1,INSTR(str,k2) p2 FROM data)

select SUBSTR(str,p1+LENGTH(k1),INSTR(str,',',p1+1)-p1-LENGTH(k1))

      ,SUBSTR(str,p2+LENGTH(k2),INSTR(str,',',p2+1)-p2-LENGTH(k2))

  from data2;
最终代码:
with data as (select hopbyhop,

               svcctx_id,

               cause as str,

               'Host = ' k1,

               'Priority = ' k2

               from dcc_sys_log  where cause like '%SC路由应答%')

,data2 as (select data.*,instr(str,k1) p1, instr(str,k2) p2 from data)

,data3 as

(select hopbyhop,

       svcctx_id,

       SUBSTR(str,p1+LENGTH(k1),INSTR(str,',',p1+1)-p1-LENGTH(k1)) peer

      ,SUBSTR(str,p2+LENGTH(k2),INSTR(str,',',p2+1)-p2-LENGTH(k2)) PRIORITY

  from data2)

SELECT hopbyhop,svcctx_id,

       MAX(DECODE(RN,1,PEER)) PEER1

      ,MAX(DECODE(RN,1,PRIORITY)) PRIORITY1

      ,MAX(DECODE(RN,2,PEER))  PEER2

      ,MAX(DECODE(RN,2,PRIORITY))  PRIORITY2

      ,MAX(DECODE(RN,3,PEER)) PEER3

      ,MAX(DECODE(RN,3,PRIORITY)) PRIORITY3

 FROM (SELECT data3.*, ROW_NUMBER() OVER(PARTITION BY hopbyhop,svcctx_id ORDER BY PEER,PRIORITY) RN FROM data3)

WHERE RN<=3

GROUP BY hopbyhop,svcctx_id;
最终的代码:
select distinct to_char(svcctx_id),

                to_char(0),

                to_char(nvl((select peer_id

                              from dcc_ne_config

                             where peer_name = PEER1),

                            0)),

                to_char(priority1),

                to_char(nvl((select peer_id

                              from dcc_ne_config

                             where peer_name =PEER2),

                            0)),

                to_char(priority2),

                to_char(nvl((select peer_id

                              from dcc_ne_config

                             where peer_name = PEER3),

                            0)),

                to_char(priority3)

  from

(with data as (select hopbyhop,

               svcctx_id,

               cause as str,

               'Host = ' k1,

               'Priority = ' k2

               from dcc_sys_log  where cause like '%SC路由应答%')

,data2 as (select data.*,instr(str,k1) p1, instr(str,k2) p2 from data)

,data3 as

(select hopbyhop,

       svcctx_id,

       SUBSTR(str,p1+LENGTH(k1),INSTR(str,',',p1+1)-p1-LENGTH(k1)) peer

      ,SUBSTR(str,p2+LENGTH(k2),INSTR(str,',',p2+1)-p2-LENGTH(k2)) PRIORITY

  from data2)

SELECT hopbyhop,svcctx_id,

       MAX(DECODE(RN,1,PEER)) PEER1

      ,MAX(DECODE(RN,1,PRIORITY)) PRIORITY1

      ,MAX(DECODE(RN,2,PEER))  PEER2

      ,MAX(DECODE(RN,2,PRIORITY))  PRIORITY2

      ,MAX(DECODE(RN,3,PEER)) PEER3

      ,MAX(DECODE(RN,3,PRIORITY)) PRIORITY3

 FROM (SELECT data3.*, ROW_NUMBER() OVER(PARTITION BY hopbyhop,svcctx_id ORDER BY PEER,PRIORITY) RN FROM data3)

WHERE RN<=3

GROUP BY hopbyhop,svcctx_id) t2
忽略SQL改造等价性
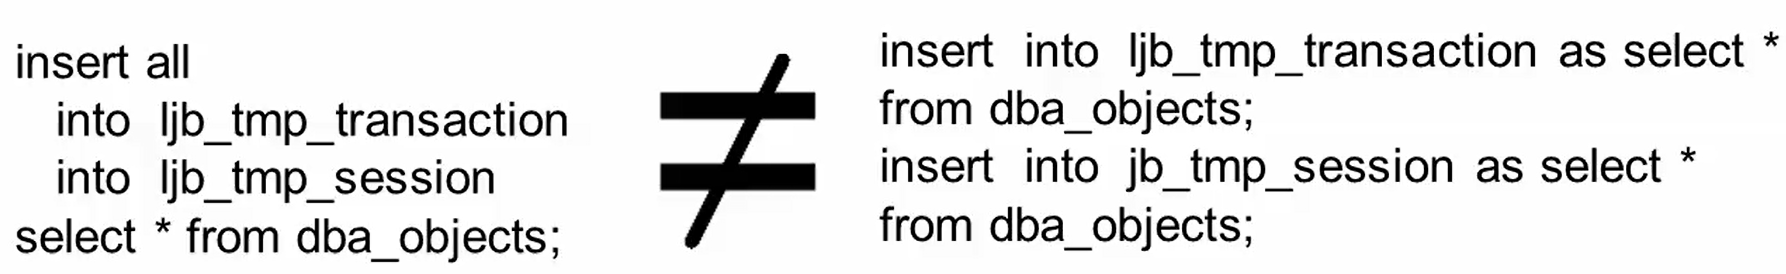
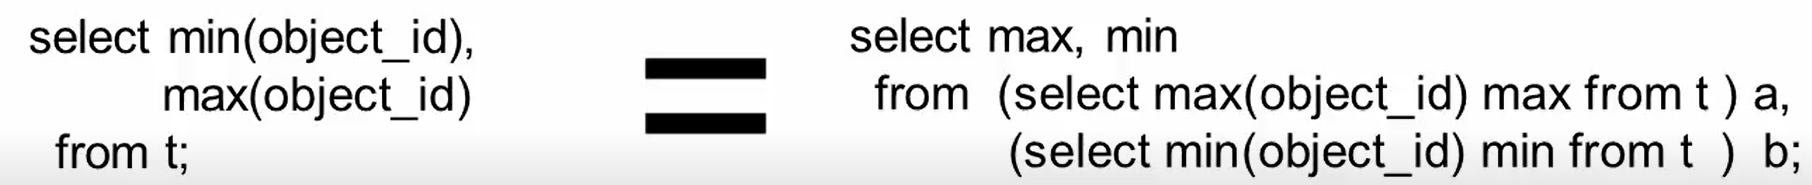
max min的写法,分开写性能快。
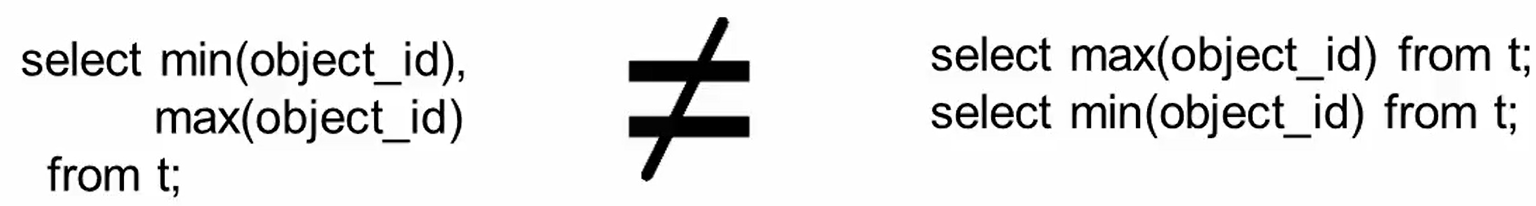
这样写是等价的
drop table t purge;

create table t as select * from dba_objects;

create index idx_object_id on t(object_id,object_type);

UPDATE t SET OBJECT_ID=20 WHERE ROWNUM<=26000;

UPDATE t SET OBJECT_ID=21 WHERE OBJECT_ID<>20;

COMMIT;

set linesize 266

set pagesize 1

alter session set statistics_level=all ;

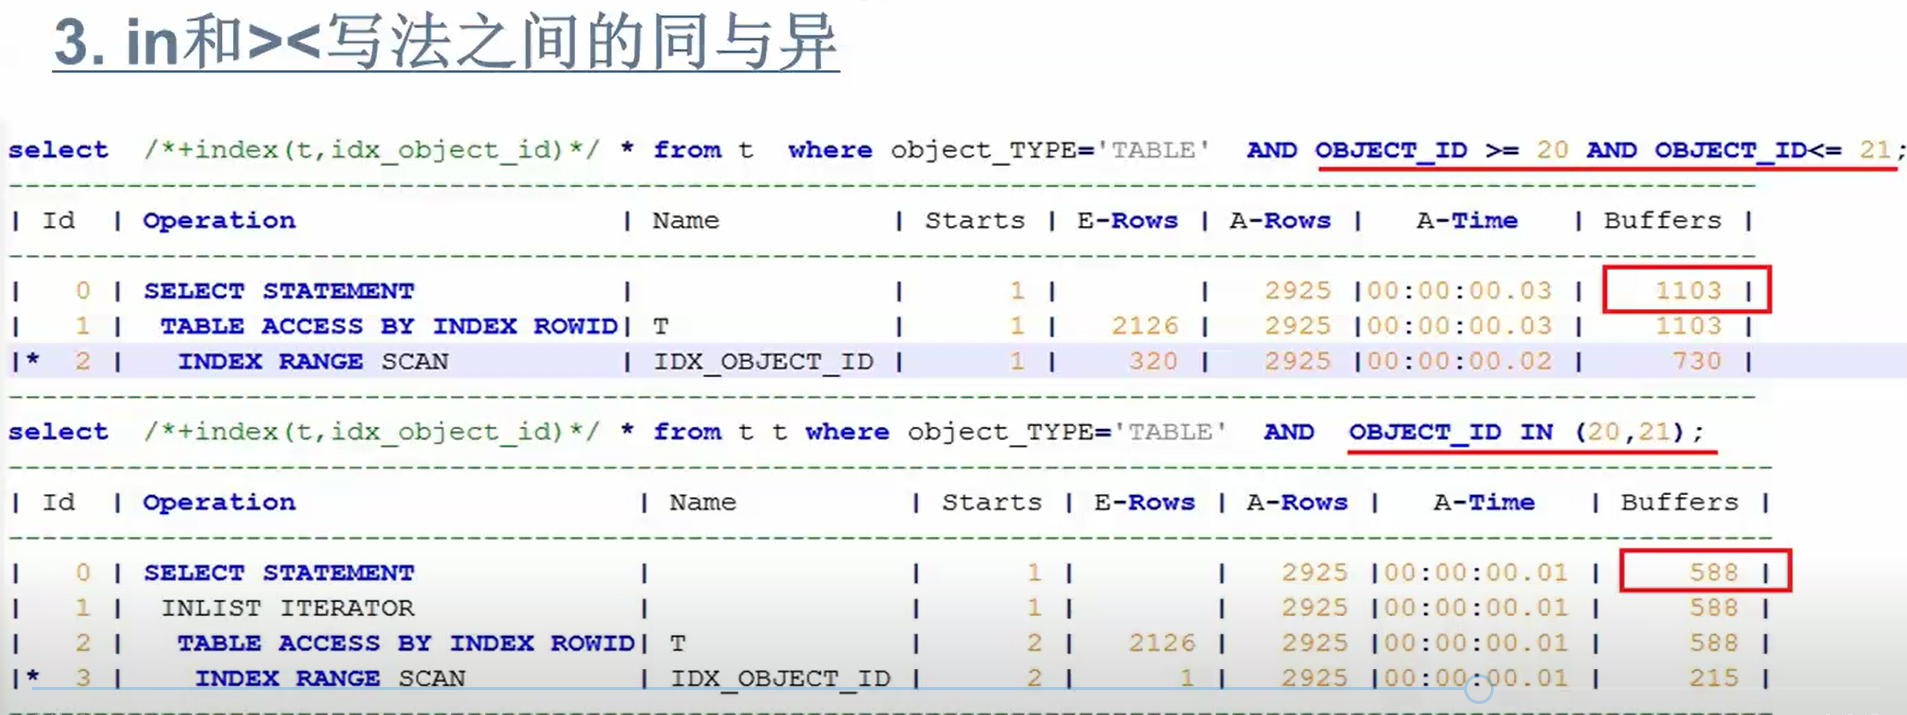
select  /*+index(t,idx_object_id)*/ * from t  where object_TYPE='TABLE'  AND OBJECT_ID >= 20 AND OBJECT_ID<= 21;

select * from table(dbms_xplan.display_cursor(null,null,'allstats last'));

-------------------------------------------------------------------------------------------------------

| Id  | Operation                   | Name          | Starts | E-Rows | A-Rows |   A-Time   | Buffers |

-------------------------------------------------------------------------------------------------------

|   0 | SELECT STATEMENT            |               |      1 |        |   2925 |00:00:00.03 |    1103 |

|   1 |  TABLE ACCESS BY INDEX ROWID| T             |      1 |   2126 |   2925 |00:00:00.03 |    1103 |

|*  2 |   INDEX RANGE SCAN          | IDX_OBJECT_ID |      1 |    320 |   2925 |00:00:00.02 |     730 |

-------------------------------------------------------------------------------------------------------

select  /*+index(t,idx_object_id)*/ * from t t where object_TYPE='TABLE'  AND  OBJECT_ID IN (20,21);

select * from table(dbms_xplan.display_cursor(null,null,'allstats last'));

---------------------------------------------------------------------------------------------------------

| Id  | Operation                    | Name           | Starts | E-Rows | A-Rows |   A-Time   | Buffers |

---------------------------------------------------------------------------------------------------------

|   1 |  INLIST ITERATOR             |                |      1 |        |   2920 |00:00:00.01 |     563 |

|   2 |   TABLE ACCESS BY INDEX ROWID| t              |      2 |   2592 |   2920 |00:00:00.01 |     563 |

|*  3 |    INDEX RANGE SCAN          | IDX1_OBJECT_ID |      2 |      1 |   2920 |00:00:00.01 |     214 |

--------------------------------------------------------------------------------------------------------

drop table t purge;

create table t as select * from dba_objects;

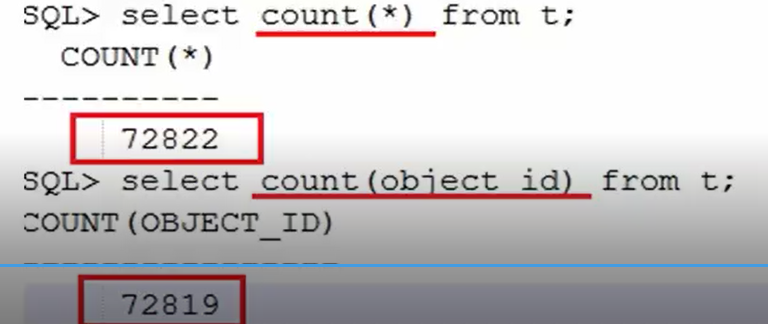
update t set object_id =null where rownum<=2;

set autotrace off

select count(*) from t;

select count(object_id) from t;
oracle学习笔记(三)的更多相关文章
- Oracle学习笔记三 SQL命令
SQL简介 SQL 支持下列类别的命令: 1.数据定义语言(DDL) 2.数据操纵语言(DML) 3.事务控制语言(TCL) 4.数据控制语言(DCL)
- Oracle学习笔记三
一.创建表空间 表空间是ORACLE数据库的逻辑单元.数据库--表空间 一个表空间可以与多个数据文件(物理结构)关联一个数据库下可以建立多个表空间,一个表空间可以建立多个用户个用户下可以建立多个表. ...
- oracle 学习笔记(三)
1. SQL(基础查询) 1.1. 基本查询语句 1.1.1. FROM子句 SQL查询语句的语法如下: SELECT <*, column [alias], -> FROM tabl ...
- Oracle学习笔记(三)
五.操作表 1.表分为行和列 约定:每行数据唯一性,每列数据同类性,每列列名唯一性. 2.数据类型 字符型 -- 固定长度的字符类型 字符类型:CHAR(n)(MAX n=2000).NCHAR(MA ...
- oracle学习笔记第一天
oracle学习笔记第一天 --oracle学习的第一天 --一.几个基础的关键字 1.select select (挑选) 挑选出显示的--列--(可以多列,用“,”隔开,*表示所有列),为一条 ...
- Oracle学习笔记—数据字典和常用命令(转载)
转载自: oracle常用数据字典和SQL语句总结 Oracle常用命令大全(很有用,做笔记) 一.Oracle数据字典 数据字典是Oracle存放有关数据库信息的地方,其用途是用来描述数据的.比如一 ...
- [Firefly引擎][学习笔记三][已完结]所需模块封装
原地址:http://www.9miao.com/question-15-54671.html 学习笔记一传送门学习笔记二传送门 学习笔记三导读: 笔记三主要就是各个模块的封装了,这里贴 ...
- JSP学习笔记(三):简单的Tomcat Web服务器
注意:每次对Tomcat配置文件进行修改后,必须重启Tomcat 在E盘的DATA文件夹中创建TomcatDemo文件夹,并将Tomcat安装路径下的webapps/ROOT中的WEB-INF文件夹复 ...
- java之jvm学习笔记三(Class文件检验器)
java之jvm学习笔记三(Class文件检验器) 前面的学习我们知道了class文件被类装载器所装载,但是在装载class文件之前或之后,class文件实际上还需要被校验,这就是今天的学习主题,cl ...
- VSTO学习笔记(三) 开发Office 2010 64位COM加载项
原文:VSTO学习笔记(三) 开发Office 2010 64位COM加载项 一.加载项简介 Office提供了多种用于扩展Office应用程序功能的模式,常见的有: 1.Office 自动化程序(A ...
随机推荐
- 记一次MyBatisPlus问题(如果表名是数据库关键字怎么办)
问题信息:如果表名是数据库关键字怎么办? 正常来说,如果是我们自己写sql的话,给表名加反引号即可解决问题. 但是由于我们使用MyBatisPlus,相关的sql基本上都是封装并自动生成的.如果是这种 ...
- [技术博客]使用adb命令获取app(游戏)错误和警告日志
adb命令的使用 直接在命令行中输入: adb logcat *:W 注意:这句命令的意思是显示所有优先级大于等于警告(Warning)的日志,查找崩溃问题一般用: adb logcat *:E 注意 ...
- android中SELINUX规则分析和语法简介
1. SELINUX是可以理解为一种android上面的安全机制,是有美国国家安全局和一些公司设计的一个针对linux的安全加强系统我们可以通过配置SELINUX的相关policy,来定制自己的手机的 ...
- Weblogic部署web项目代码中获取项目名为null的问题
写在前面 这个问题之前遇到一次, 时间久就忘了, 还是好记性不如烂笔头, 记一下吧.Windows下部署到Tomcat和Linux下部署到Weblogic的获取项目名写法. 关键代码 java代码 w ...
- 支付宝小程序开发——获取位置API没有城市区号的最佳处理方案
前言: 需要对城市区号进行判断,但是支付宝小程序提供的my.getLocation() API返回的数据中只有6位的城市行政代码,诸如:深圳(440300),并没有区号(0755),那么怎么办呢? 需 ...
- Could not find com.android.tools.build:gradle:3.3.0.
导入新项目时报错: Error:Could not find com.android.tools.build:gradle:3.3.0. Searched in the following locat ...
- OSI七层模型、TCP/IP五层模型
OSI网络互连的七层框架:物理层.数据链路层.网络层.传输层.会话层.表示层.应用层: <1>应用层 OSI参考模型中最靠近用户的一层,是为计算机用户提供应用接口,为用户直接提供各种网络服 ...
- 阶段一-01.万丈高楼,地基首要-第2章 单体架构设计与准备工作-2-27 为何不使用@EnableTransactionManagement就能使用事务?
使用了注解使用事务.但是没有开启注解的启用 启动类里面使用注解 @EnableTransactionManager开启事物的管理. 为什么我们没有开启这个注解,还需要在响应的Service里面使用事务 ...
- 【错误解决】UnicodeDecodeError: 'gbk' codec can't decode byte 0xad in position 840: illegal multibyte sequence
原文来源:https://www.zhihu.com/question/22699590 编码问题错误,读入文件的时候指定编码即可. with open(fname, encoding='utf-8' ...
- LODOP表格水平居中3(宽度为百分比)
如果一个表格在css样式等中设置了固定的宽度,想要实现表格在纸张中水平居中,可根据固定的宽度设置合适的左边距,如果打印项内容在打印项宽度中居中,可以设置打印项在纸张中居中.方法1:宽度固定,纸张大小固 ...