
processing data
获取有效数据
Scikit-learn will not accept categorical features by default
API里面不知使用默认的特征变量名,因此需要编码
这里我还是有疑问?
对于下载的数据集,一般的特征变量名,在进行分类的时候,机器是不能识别的,需要对特征名进行编码,因为计算机是二进制语言啊?Need to encode categorical features numerically
Convert to ‘dummy variables’
- 0: Observation was NOT that category
- 1: Observation was that category
Dealing with categorical features in Python
两种方式是一样的
- scikit-learn: OneHotEncoder()
- pandas: get_dummies()
pd.get_dummies
- 离散特征编码
- 可用来表示分类变量、非数量因素可能产生的影响
pandas加入虚拟变量的方式
get_dummies 是利用pandas实现one hot encode的方式。详细参数请查看官方文档
pandas.get_dummies(data, prefix=None, prefix_sep='_', dummy_na=False, columns=None, sparse=False, drop_first=False)[source]
- data 要处理的DataFrame
- prefix 列名的前缀,在多个列有相同的离散项时候使用
- prefix_sep 前缀和离散值的分隔符,默认为下划线,默认即可
- dummy_na 是否把NA值,作为一个离散值进行处理,默认为不处理
- columns 要处理的列名,如果不指定该列,那么默认处理所有列
- drop_first 是否从备选项中删除第一个,建模的时候为避免共线性使用
Pandas中的get_dummy()函数是将拥有不同值的变量转换为0/1数值。
举例说明:一群样本的年龄分别为19,32,56,94岁,19岁用1表示,32岁用2表示,56岁用3表示,94岁用4表示。1,2,3,4这些数值的大小本身没有意义,只是用来区分年龄。因此在实际问题中,需要将1,2,3,4转化为0/1,即如果是19岁,则为0,若不是则为1,以此类推。
- 举个例子
import pandas as pd

df = pd.DataFrame([

            ['green' , 'm'],

            ['red'   , 'n'],

            ['blue'  , 'q']])

df.columns = ['color',  'class']

pd.get_dummies(df)
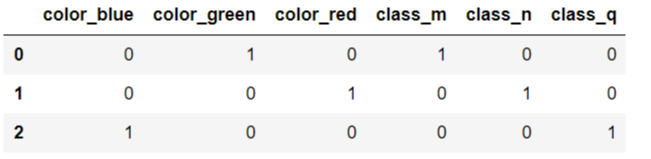
# Create dummy variables: df_region

df_region = pd.get_dummies(df)

# Print the columns of df_region

print(df_region.columns)

# Drop 'Region_America' from df_region

df_region = pd.get_dummies(df, drop_first=True)

# Print the new columns of df_region

print(df_region)
处理缺失数据
Imputer()
- 填补缺失值:
sklearn.preprocessing.Imputer(missing_values=’NaN’, strategy=’mean’, axis=0, verbose=0, copy=True)
主要参数说明:
missing_values:缺失值,可以为整数或NaN(缺失值numpy.nan用字符串‘NaN’表示),默认为NaN
strategy:替换策略,字符串,默认用均值‘mean’替换
- 若为mean时,用特征列的均值替换
- 若为median时,用特征列的中位数替换
- 若为most_frequent时,用特征列的众数替换
axis:指定轴数,默认axis=0代表列,axis=1代表行
copy:设置为True代表不在原数据集上修改,设置为False时,就地修改,存在如下情况时,即使设置为False时,也不会就地修改
- X不是浮点值数组
- X是稀疏且missing_values=0
- axis=0且X为CRS矩阵
- axis=1且X为CSC矩阵
statistics_属性:axis设置为0时,每个特征的填充值数组,axis=1时,报没有该属性错误
参考
# Import the Imputer module

from sklearn.preprocessing import Imputer

from sklearn.svm import SVC

# Setup the Imputation transformer: imp

imp = Imputer(missing_values='NaN', strategy='most_frequent', axis=0)

# Instantiate the SVC classifier: clf

clf = SVC()

# Setup the pipeline with the required steps: steps

steps = [('imputation', imp),

        ('SVM', clf)]
dropna()
直接删除缺失值
pipline
官方文档
连接多个转换器和预测器在一起,形成一个机器学习工作流,这句解释太官方了,因此我没懂
processing data的更多相关文章
- PatentTips - Data Plane Packet Processing Tool Chain
BACKGROUND The present disclosure relates generally to systems and methods for providing a data plan ...
- Becoming a Data Scientist – Curriculum via Metromap
From: http://nirvacana.com/thoughts/becoming-a-data-scientist/ Data Science, Machine Learning, Big D ...
- Monitoring and Tuning the Linux Networking Stack: Receiving Data
http://blog.packagecloud.io/eng/2016/06/22/monitoring-tuning-linux-networking-stack-receiving-data/ ...
- 基于Processing的数据可视化
虽然数据可视化领域有很多成熟.界面友好.功能强大的软件产品(例如Tableau.VIDI.NodeXL等),但是借助Processing我们可以基于Java语言框架进行丰富多元的可视化编程,熟悉了Pr ...
- Awesome Big Data List
https://github.com/onurakpolat/awesome-bigdata A curated list of awesome big data frameworks, resour ...
- IAB303 Data Analytics Assessment Task
Assessment TaskIAB303 Data Analyticsfor Business InsightSemester I 2019Assessment 2 – Data Analytics ...
- Python - 2. Built-in Collection Data Types
From: http://interactivepython.org/courselib/static/pythonds/Introduction/GettingStartedwithData.htm ...
- Stream processing with Apache Flink and Minio
转自:https://blog.minio.io/stream-processing-with-apache-flink-and-minio-10da85590787 Modern technolog ...
- [Windows Azure] Data Management and Business Analytics
http://www.windowsazure.com/en-us/develop/net/fundamentals/cloud-storage/ Managing and analyzing dat ...
随机推荐
- mixin很难吗?
实践类工作经常会遇到这样的问题,有些概念会用不会说,最近在学习Dart,遇到mixin便是如此.读了几篇网文总觉得良莠不齐,一群码友也说越读越懵,索性静下心来重新出发,一点一滴地弄明白.记录下来分享给 ...
- 转载 angularJS filter 过滤器
angularjs中的filter(过滤器) 标签: angularjsfilter 源文地址:http://www.ncloud.hk/技术分享/angularjs中的filter-过滤器/ f ...
- Go语言实现:【剑指offer】正则表达式匹配
该题目来源于牛客网<剑指offer>专题. 请实现一个函数用来匹配包括 . 和 * 的正则表达式.模式中的字符.表示任意一个字符,而 * 表示它前面的字符可以出现任意次(包含0次). 在本 ...
- 本地linux搭建的WordPress升级时需要输入FTP信息
转自:https://blog.csdn.net/weixin_43837883/article/details/88751871 这是因为目录权限不正确所致 解决方法: 1.使用命令chown -R ...
- 大文件切割(split)
split提供两种方式对文件进行切割: 根据行数切割,通过-l参数指定需要切割的行数 根据大小切割,通过-b参数指定需要切割的大小 1.1 根据行数切割 如下以一个3.4G大小的日志文件做切割演示,每 ...
- Linux 服务器注意事项
1.创建时 数据文件一定分盘挂载 2.LVM 虚拟磁盘卷是否创建 有争议??? 3.hosts 文件 最好添加本机映射 主机名 127.0.0.1 4.iptab ...
- 基于Travis CI实现 Gitbook在 Github 和 Coding 的同步部署
前言 最近发现自己的博客在使用vpn的情况下打开很慢,百度站点也抓取失败,于是将自己的博客借助hexo-deploy 插件很容易同步部署到了coding上.只需要在你的hexo配置文件_config. ...
- if-else连用时的陷阱
近日,在实现<The C Programing Language>上的一个练习题时,写出了下面一段代码 ; i<=right; i++) { ) ) swap(v, i, ++la ...
- 学习分享--python网络爬虫(一)关于如何更新python pip以及如何安装python requests库
一.python pip的更新(我的是window10 界面可能不太一样) 1.找到电脑左下角开始按钮,并点击: 2.输入cmd 3.打开以后,先查看自己的pip版本 输入:pip -V 敲回 ...
- 浅析word2vec(一)
1 word2vec 在自然语言处理的大部分任务中,需要将大量文本数据传入计算机中,用以信息发掘以便后续工作.但是目前计算机所能处理的只能是数值,无法直接分析文本,因此,将原有的文本数据转换为数值数据 ...