
hive笔记:转义字符的使用
hive中的转义符
Hadoop和Hive都是用UTF-8编码的,所以, 所有中文必须是UTF-8编码, 才能正常使用
备注:中文数据load到表里面, 如果字符集不同,很有可能全是乱码需要做转码的, 但是hive本身没有函数来做这个
一、转义字符的特殊情况:
自身的转义,比如java有时候需要两个转义字符"\\",或者四个转义字符“\\\\”。
1)java的俩种情况:
a.正则表达式匹配和string的split函数,这两种情况中字符串包含转义字符“\”时,需要先对转义字符自身转义,就是说需要两个转义字符“\\”。比如\n,\t等(java解析后,再有正则和split自身特定进行解析)
b.而当匹配字符正斜线“\”,则需要四个转义字符“\\\\”,因为,首先java(编译器?)自身先解析,转义成两个“\\”,再由正则或split的解析功能转义成一个“\”,才是最终要处理的字符。
这是因为解析过程需要两次,才能在字符串中出现正斜线“\”,出现后才能转义后面的字符。
2)hive中的split和正则表达式
hive用java写的,所以同Java一样,两种情况也需要两个“\\”,
split处理代码为例:
a.split(dealid,'\\\\')[0] as dealids,1: 代码中,如果以“\”作为分隔符的话,那么就需要4个转义字符“\\\\”,即
b.split(all,'~') :这里切分符号是正则表达式,按一个字符分隔没问题
c. split(all,'[|~]+'): 在[]内部拼接成字符串
3)hive语句在shell脚本中执行
shell语言也有转义字符,自身直接处理。
而hive语句在shell脚本中执行时,就需要先由shell转义后,再由hive处理。这个过程又造成二次转义。
如上面的hive语句写入shell脚本中,执行是错误的,shell先解析,转义成”|“后传给hive,hive解析这个转义字符后,split就无法正确的解析了。
所以,注意hive语句在shell脚本执行时,转义字符需要翻倍。hive处理的是shell转义后的语句,必须转以后正确,才能执行。
注意:是否使用转义字符是看这个字符在这个语言中有没有特殊意义,有的话,就需要加上\来进行转义、
|
转义字符的使用: |
||||
|
转义字符 |
无转义符 |
转义符\ |
转义符\\ |
转义符\\\ |
|
" |
" |
\" |
\\” |
|
|
\ |
不可识别 |
不可识别 |
不可识别 |
\\\\ |
|
/ |
/ |
\/ |
\\/ |
\\\/ |
|
' |
不可识别 |
\' |
不可识别 |
\\\' |
|
~ |
~ |
\~ |
\\~ |
|
|
| |
| |
\| |
\\| |
\\\| |
|
; |
; |
\; |
\\; |
|
|
: |
: |
\: |
\\: |
|
|
, |
, |
\, |
\\, |
|
|
. |
. |
\. |
\\. |
|
|
! |
! |
\! |
\\! |
|
|
( |
( |
\( |
\\( |
|
|
) |
) |
\) |
\\) |
|
|
[ |
不可识别 |
不可识别 |
\\[ |
|
|
] |
] |
\] |
\\] |
|
|
{ |
{ |
\{' |
\\{ |
|
|
} |
} |
\} |
\\} |
|
|
? |
? |
\? |
\\? |
|
|
_ |
_ |
\_ |
\\_ |
|
|
- |
- |
\- |
\\- |
|
|
# |
# |
\# |
\\# |
|
|
## |
## |
\## |
\\## |
\\\## |
|
& |
& |
\& |
\\& |
|
|
^ |
^ |
\^ |
\\^ |
|
二、案例:原数据表
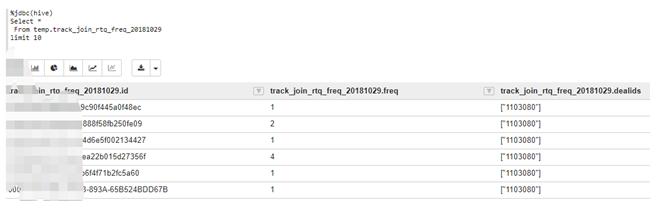
1.\符号
(1)regexp_replace(dealids,'\\[','\\\\')
%jdbc(hive)
Select regexp_replace(dealids,'\\[','\\\\')
as place
From
temp.track_join_rtq_freq_20181029
limit 10
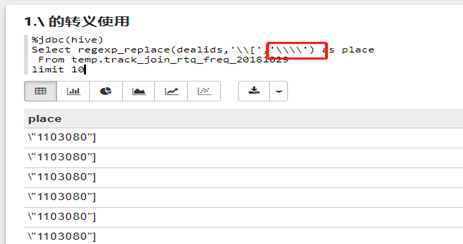
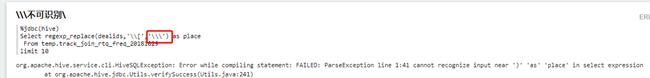
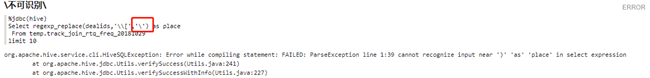
注意:
2.[与]符号
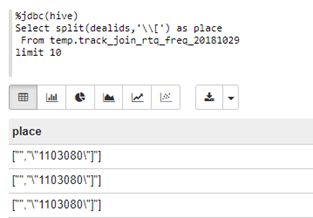
(1)\\[:split(dealids,'\\[')
%jdbc(hive)
Select split(dealids,'\\[') as place
From
temp.track_join_rtq_freq_20181029
limit 10
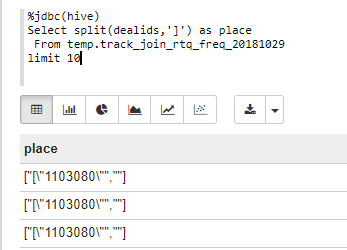
(2)]:split(dealids,']')
%jdbc(hive)
Select split(dealids,']') as place
From
temp.track_join_rtq_freq_20181029
limit 10
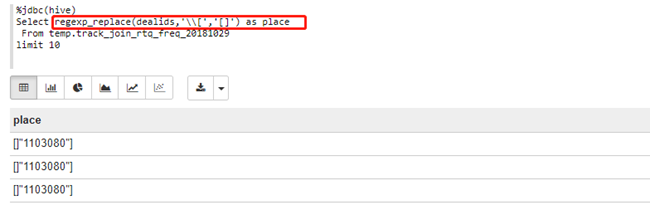
(3)\\[和[]:regexp_replace(dealids,'\\[','[]')
%jdbc(hive)
Select regexp_replace(dealids,'\\[','[]') as place
From temp.track_join_rtq_freq_20181029
limit 10
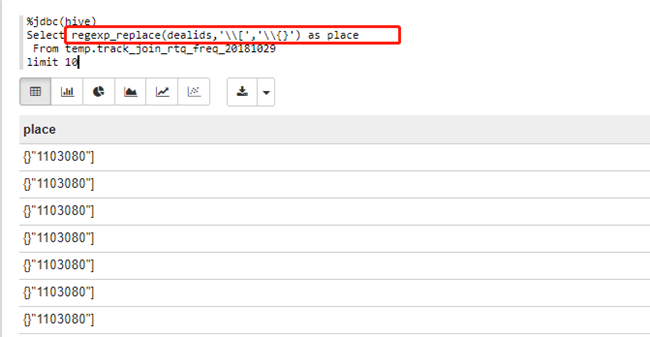
(4)\\[和\\{}:regexp_replace(dealids,'\\[','\\{}')
%jdbc(hive)
Select regexp_replace(dealids,'\\[','\\{}')
as place
From
temp.track_join_rtq_freq_20181029
limit 10
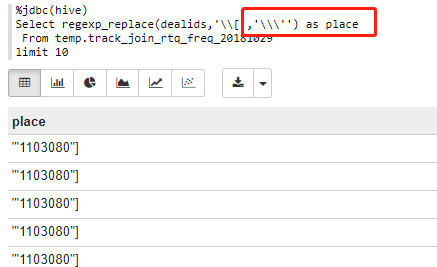
3.’符号
(1)\\\':regexp_replace(dealids,'\\[','\\\'')
%jdbc(hive)
Select regexp_replace(dealids,'\\[','\\\'') as place
From temp.track_join_rtq_freq_20181029
limit 10
hive笔记:转义字符的使用的更多相关文章
- Hive笔记--sql语法详解及JavaAPI
Hive SQL 语法详解:http://blog.csdn.net/hguisu/article/details/7256833Hive SQL 学习笔记(常用):http://blog.sina. ...
- Hive 笔记
DESCRIBE EXTENDED mydb.employees DESCRIBE EXTENDED mydb.employees DESCRIBE EXTENDED mydb.employees ...
- hive笔记(自学整理的)
第一部分:用户管理 创建用户:CREATE DATABASE XXX 查看用户:SHOW DATABASES; 关键查看用户:show databases like 'de.*' 讲解:创建一个用 ...
- Hive笔记--配置以及遇到的问题
ubuntu安装mysql http://www.2cto.com/database/201401/273423.html Hive安装: http://www.aboutyun.com/forum ...
- Hive笔记——技术点汇总
目录 · 概况 · 手工安装 · 引言 · 创建HDFS目录 · 创建元数据库 · 配置文件 · 测试 · 原理 · 架构 · 与关系型数据库对比 · API · WordCount · 命令 · 数 ...
- hive笔记:复杂数据类型-map结构
map 结构 1. 语法:map(k1,v1,k2,v2,…) 操作类型:map ,map类型的数据可以通过'列名['key']的方式访问 案例: select deductions['Feder ...
- hive笔记
cast cast(number as string), 可以将整数转成字符串 lpad rpad lpad(target, 10, '0') 表示在target字符串前面补0,构成一个长度为 ...
- hive笔记:时间格式的统一
一.string类型,年月日部分包含的时间统一格式: 原数据格式(时间字段为string类型) 取数时间和格式的语法 2018-11-01 00:12:49.0 substr(regexp_repl ...
- hive笔记:复杂数据类型-array结构
array 结构 (1)语法:array(val1,val2,val3,…) 操作类型:array array类型的数据可以通过'数组名[index]'的方式访问,index从0开始: (2)建表: ...
随机推荐
- OpenResty api网关设计
本文讲述 OpenResty api网关设计,主要涉及api网关介绍.openresty api网关 请求路由(路由判断.路由重写.服务判断.限流).授权验证(统一认证).动态Upstream 以及这 ...
- Docker之使用Dockerfile创建定制化镜像(四)--技术流ken
前言 在之前的博客<Docker端口映射及创建镜像演示(二)--技术流ken>,演示了如何使用一个现有容器创建一个镜像,以及镜像在阿里云的上传和下载. 但是这样的镜像有很大的局限性,不能根 ...
- camera测试之颜色还原
测试目的:camera对色彩的还原能力 测试主要设备:24色色卡,灯箱 测试环境:1.D65/CW/A光源,照度为600±100lux,整个chart表面的亮度值相差小于10% 2.D65光源,照度为 ...
- 操作数据库出现InvalidOpertionException(内部连接致命错误)
用DataTables时并发访问量较大,单个任务操作(获取数据)时间较长.连接数过多的时候就出现InvalidOpertionException错误.知道哪里有问题那就好办了,对GetDataTabl ...
- Webapi创建和使用 以及填坑(三)
WebApi使用填坑 前面工作跟别人做数据对接,因为我们是对接方所以东西都得按照他们的要求进行修改,于是给自己挖了很多坑,其实更多的都是自己能力还不够,在这里也做一个笔记了. 请求类型:applica ...
- Java学习笔记之——自动装箱与拆箱
自动装箱与拆箱 基本类型与引用类型的互相转换 1. 基本类型对应的包装类 byte short char int long flaot double ...
- python使用gevent实现并发下载器
并发下载原理 import gevent from gevent import monkey import urllib.request monkey.patch_all() def my_downl ...
- 【Spring】31、Spring的EL表达式
一.简介 Spring3中引入了Spring表达式语言—SpringEL,SpEL是一种强大,简洁的装配Bean的方式,他可以通过运行期间执行的表达式将值装配到我们的属性或构造函数当中,更可以调用JD ...
- Redis配置解读
- 现在有两个变量,分别是a = 3, b = 4,那么我们不用第三个变量来调换a和b的值。
现在有两个变量,分别是a = 3, b = 4,那么我们不用第三个变量来调换a和b的值. <!DOCTYPE html><html><head> <me ...