
spark RDD,DataFrame,DataSet 介绍
弹性分布式数据集(Resilient Distributed Dataset,RDD)
RDD是Spark一开始就提供的主要API,从根本上来说,一个RDD就是你的数据的一个不可变的分布式元素集合,在集群中跨节点分布,可以通过若干提供了转换和处理的底层API进行并行处理。每个RDD都被分为多个分区,这些分区运行在集群不同的节点上。
RDD支持两种类型的操作,转化操作(transform)和行动操作(action)。转化操作会有一个RDD生成一个新的RDD,行动操作则要计算出来一个结果。spark对于转化操作是惰性的,只有当遇到第一个action操作时才会去执行。
下面是使用RDD的场景和常见案例:
- 你希望可以对你的数据集进行最基本的转换、处理和控制;
- 你的数据是非结构化的,比如流媒体或者字符流;
- 你想通过函数式编程而不是特定领域内的表达来处理你的数据;
- 你不希望像进行列式处理一样定义一个模式,通过名字或字段来处理或访问数据属性;
- 你并不在意通过DataFrame和Dataset进行结构化和半结构化数据处理所能获得的一些优化和性能上的好处;
DataFrame 和DataSet
与RDD相似,DataFrame也是数据的一个不可变分布式集合。但与RDD不同的是,数据都被组织到有名字的列中,就像关系型数据库中的表一样。设计DataFrame的目的就是要让对大型数据集的处理变得更简单,它让开发者可以为分布式的数据集指定一个模式,进行更高层次的抽象。它提供了特定领域内专用的API来处理你的分布式数据,并让更多的人可以更方便地使用Spark,而不仅限于专业的数据工程师。
一图胜千言,先从一张图中看一下dataFrame和RDD的区别。
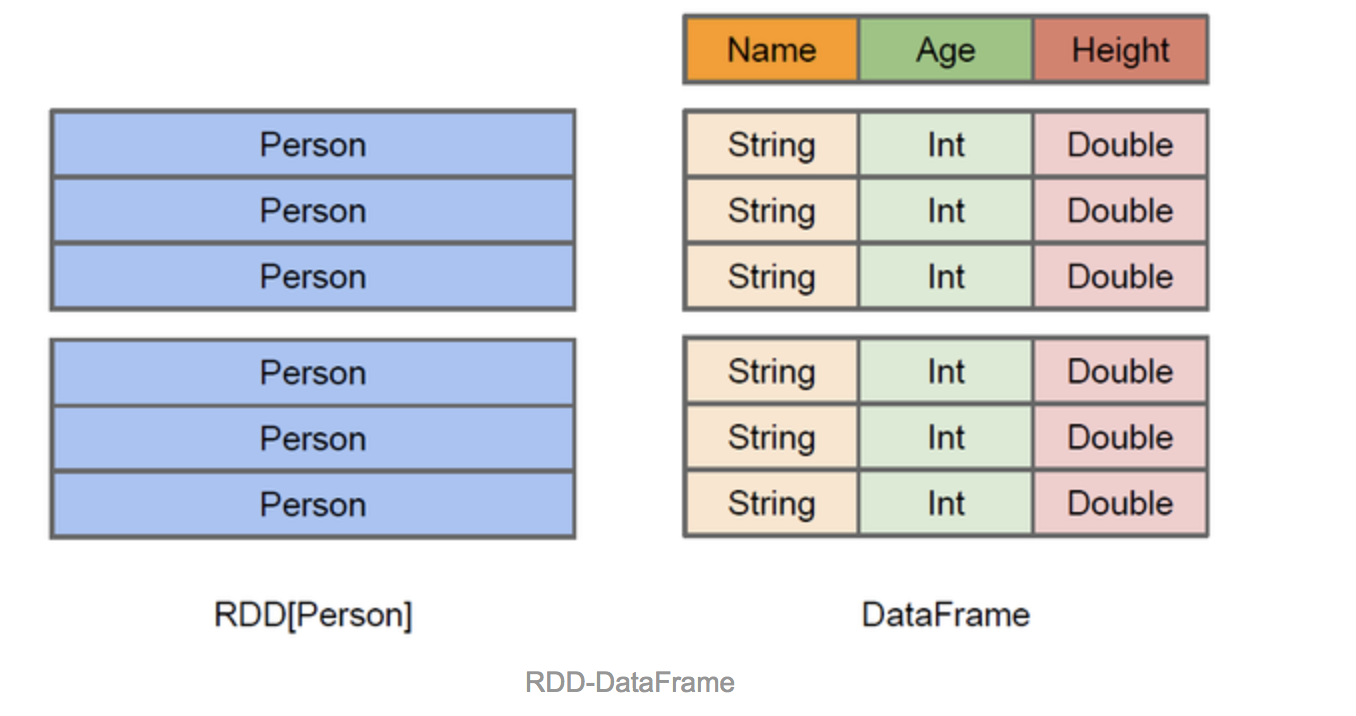
上图直观地体现了DataFrame和RDD的区别。左侧的RDD[Person]虽然以Person为类型参数,但Spark框架本身不了解Person类的内部结构。而右侧的DataFrame却提供了详细的结构信息,使得Spark SQL可以清楚地知道该数据集中包含哪些列,每列的名称和类型各是什么。DataFrame多了数据的结构信息,即schema。RDD是分布式的Java对象的集合。DataFrame是分布式的Row对象的集合。DataFrame除了提供了比RDD更丰富的算子以外,更重要的特点是提升执行效率、减少数据读取以及执行计划的优化,比如filter下推、裁剪等。
提升执行效率
RDD API是函数式的,强调不变性,在大部分场景下倾向于创建新对象而不是修改老对象。这一特点虽然带来了干净整洁的API,却也使得Spark应用程序在运行期倾向于创建大量临时对象,对GC造成压力。在现有RDD API的基础之上,我们固然可以利用mapPartitions方法来重载RDD单个分片内的数据创建方式,用复用可变对象的方式来减小对象分配和GC的开销,但这牺牲了代码的可读性,而且要求开发者对Spark运行时机制有一定的了解,门槛较高。另一方面,Spark SQL在框架内部已经在各种可能的情况下尽量重用对象,这样做虽然在内部会打破了不变性,但在将数据返回给用户时,还会重新转为不可变数据。利用 DataFrame API进行开发,可以免费地享受到这些优化效果。
减少数据读取
分析大数据,最快的方法就是 ——忽略它。这里的“忽略”并不是熟视无睹,而是根据查询条件进行恰当的剪枝。
上文讨论分区表时提到的分区剪 枝便是其中一种——当查询的过滤条件中涉及到分区列时,我们可以根据查询条件剪掉肯定不包含目标数据的分区目录,从而减少IO。
对于一些“智能”数据格 式,Spark SQL还可以根据数据文件中附带的统计信息来进行剪枝。简单来说,在这类数据格式中,数据是分段保存的,每段数据都带有最大值、最小值、null值数量等 一些基本的统计信息。当统计信息表名某一数据段肯定不包括符合查询条件的目标数据时,该数据段就可以直接跳过(例如某整数列a某段的最大值为100,而查询条件要求a > 200)。
此外,Spark SQL也可以充分利用RCFile、ORC、Parquet等列式存储格式的优势,仅扫描查询真正涉及的列,忽略其余列的数据。
执行优化
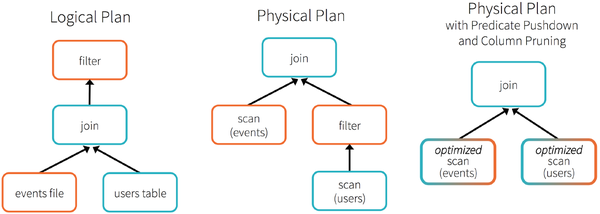
为了说明查询优化,我们来看上图展示的人口数据分析的示例。图中构造了两个DataFrame,将它们join之后又做了一次filter操作。如果原封不动地执行这个执行计划,最终的执行效率是不高的。因为join是一个代价较大的操作,也可能会产生一个较大的数据集。如果我们能将filter下推到 join下方,先对DataFrame进行过滤,再join过滤后的较小的结果集,便可以有效缩短执行时间。而Spark SQL的查询优化器正是这样做的。简而言之,逻辑查询计划优化就是一个利用基于关系代数的等价变换,将高成本的操作替换为低成本操作的过程。
得到的优化执行计划在转换成物 理执行计划的过程中,还可以根据具体的数据源的特性将过滤条件下推至数据源内。最右侧的物理执行计划中Filter之所以消失不见,就是因为溶入了用于执行最终的读取操作的表扫描节点内。
对于普通开发者而言,查询优化 器的意义在于,即便是经验并不丰富的程序员写出的次优的查询,也可以被尽量转换为高效的形式予以执行。
DataFrame和DataSet
Dataset可以认为是DataFrame的一个特例,主要区别是Dataset每一个record存储的是一个强类型值而不是一个Row。因此具有如下三个特点:
DataSet可以在编译时检查类型
并且是面向对象的编程接口。用wordcount举例:
//DataFrame

// Load a text file and interpret each line as a java.lang.String

val ds = sqlContext.read.text("/home/spark/1.6/lines").as[String]

val result = ds

  .flatMap(_.split(" "))               // Split on whitespace

  .filter(_ != "")                     // Filter empty words

  .toDF()                              // Convert to DataFrame to perform aggregation / sorting

  .groupBy($"value")                   // Count number of occurences of each word

  .agg(count("*") as "numOccurances")

  .orderBy($"numOccurances" desc)      // Show most common words first
//DataSet,完全使用scala编程,不要切换到DataFrame

val wordCount =

  ds.flatMap(_.split(" "))

    .filter(_ != "")

    .groupBy(_.toLowerCase()) // Instead of grouping on a column expression (i.e. $"value") we pass a lambda function

    .count()
后面版本DataFrame会继承DataSet,DataFrame是面向Spark SQL的接口。
DataFrame和DataSet可以相互转化,df.as[ElementType]这样可以把DataFrame转化为DataSet,ds.toDF()这样可以把DataSet转化为DataFrame。
参考资料:
1 《spark快速大数据分析》
2、https://www.jianshu.com/p/c0181667daa0
3、http://www.infoq.com/cn/articles/three-apache-spark-apis-rdds-dataframes-and-datasets
spark RDD,DataFrame,DataSet 介绍的更多相关文章
- spark rdd df dataset
RDD.DataFrame.DataSet的区别和联系 共性: 1)都是spark中得弹性分布式数据集,轻量级 2)都是惰性机制,延迟计算 3)根据内存情况,自动缓存,加快计算速度 4)都有parti ...
- APACHE SPARK 2.0 API IMPROVEMENTS: RDD, DATAFRAME, DATASET AND SQL
What’s New, What’s Changed and How to get Started. Are you ready for Apache Spark 2.0? If you are ju ...
- spark的数据结构 RDD——DataFrame——DataSet区别
转载自:http://blog.csdn.net/wo334499/article/details/51689549 RDD 优点: 编译时类型安全 编译时就能检查出类型错误 面向对象的编程风格 直接 ...
- sparkSQL中RDD——DataFrame——DataSet的区别
spark中RDD.DataFrame.DataSet都是spark的数据集合抽象,RDD针对的是一个个对象,但是DF与DS中针对的是一个个Row RDD 优点: 编译时类型安全 编译时就能检查出类型 ...
- Spark RDD、DataFrame和DataSet的区别
版权声明:本文为博主原创文章,未经博主允许不得转载. 目录(?)[+] 转载请标明出处:小帆的帆的专栏 RDD 优点: 编译时类型安全 编译时就能检查出类型错误 面向对象的编程风格 直接通过类 ...
- RDD, DataFrame or Dataset
总结: 1.RDD是一个Java对象的集合.RDD的优点是更面向对象,代码更容易理解.但在需要在集群中传输数据时需要为每个对象保留数据及结构信息,这会导致数据的冗余,同时这会导致大量的GC. 2.Da ...
- spark RDD、DataFrame、DataSet之间的相互转化
这三个数据集看似经常用,但是真正归纳总结的时候,很容易说不出来 三个之间的关系与区别参考我的另一篇blog http://www.cnblogs.com/xjh713/p/7309507.html ...
- Spark RDD、DataFrame原理及操作详解
RDD是什么? RDD (resilientdistributed dataset),指的是一个只读的,可分区的分布式数据集,这个数据集的全部或部分可以缓存在内存中,在多次计算间重用. RDD内部可以 ...
- spark第七篇:Spark SQL, DataFrame and Dataset Guide
预览 Spark SQL是用来处理结构化数据的Spark模块.有几种与Spark SQL进行交互的方式,包括SQL和Dataset API. 本指南中的所有例子都可以在spark-shell,pysp ...
随机推荐
- shell实例练习+详解
想着将Shell与Python和Java等脚本比较比较,当一有这个念头我就放弃了.这太侮辱Shell了.(哭笑脸!) 作为一个程序员,Linux那是最基本要求.而shell脚本有时候也会显示它在Lin ...
- python下划线作用初识
单下划线(例:_textchar) 以单下划线做前缀的名称指定了这个名称是"私有的".在 有些 导入import * 的场景中,下一个使用你代码的人(或者你本人)会明白这个名称仅内 ...
- Linux指令--chown
chown将指定文件的拥有者改为指定的用户或组,用户可以是用户名或者用户ID:组可以是组名或者组ID:文件是以空格分开的要改变权限的文件列表,支持通配符.系统管理员经常使用chown命令,在将文件拷贝 ...
- jdk源码->集合->ConcurrentHashMap
类的属性 public class ConcurrentHashMap<K,V> extends AbstractMap<K,V> implements ConcurrentM ...
- Linux命令:useradd
Linux下:useradd 等价于 adduser Aix下:useradd 来自为知笔记(Wiz)
- Firefox使用Poster插件发送post请求
目的:验证http请求功能正确与否,需要发送post,get请求,则可以使用Poster插件方便简单. 自我总结,有什么改正的地方请指出,感激不尽! 1.安装Poster插件. 点击firefox右上 ...
- Spring Boot快速入门(最新)
本章通过完成Spring Boot基础项目的构建并实现一个简单的Http请求处理,让大家对Spring Boot有一个初步的了解,并体验其结构简单.开发快速的特性.预计阅读及演练过程将花费约5分钟. ...
- jQuery的属性,事件及操作
1.属性操作 1.1 基本属性操作 $("img").attr("src") 返回文档中所有图像的src属性值 $("img").attr( ...
- phpstorm中配置真正的远程调试(xdebug)
这里说的是真正的远程调试,不是本地,本地不需要安装任何php程序!!! 这里略去xdebug的安装,安装很简单可以下载源码包,动态编译进去! 环境: Dev 服务器(IP:192.168.2.100) ...
- iOS-Wonderful 完美颜色库
开发中颜色的使用也是非常频繁的,这里推荐一个dsxNiubility大牛写的颜色库:Wonderful:它的好用就是很清楚的把每个常用的颜色进行了由浅到深的分层,让我们使用时可以根据自己对颜色的深浅直 ...