
Hadoop2.6.0 完全分布式搭建
1 搭建这个完全分布式的前提环境:
配置好了jdk环境
配置好了ssh免密码登录(详见我的另外一篇博客,专门说ssh免密码登录)
我这里设置了四台机器,一台做master,另外三台做slave,hosts配置如下
192.168.8.94    master

192.168.8.95    slave1

192.168.8.96    slave2

192.168.8.97    slave3
2 hadoop配置(以下的配置只在master上进行,配置好了hadoop之后,再发送到另外三台slave机器上,再配置环境变量就可以了)
首先把hadoop 2.6.0.tar.gz解压到/usr/local目录下
解压命令:sudo tar -xzvf hadoop 2.6.0.tar.gz
然后把解压后的文件夹改名为hadoop
2.1 下面配置环境变量:
配置bashrc,命令 sudo vim ~/.bashrc
配置信息如下图:
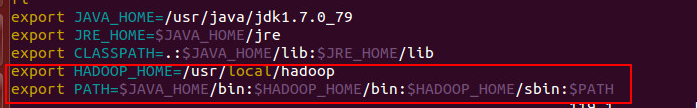
修改好了之后,执行source命令生效环境变量,命令 source ~/.bashrc
配置/etc/profile
配置信息如下:

修改好了之后,执行source /etc/profile 命令生效
2.2 配置hadoop的配置文件
所有hadoop的配置文件都在/usr/local/hadoop/etc/hadoop
首先是slaves文件,把所有slave的主机名都写在里面,一行一个,就可以了(注意,要与hosts里配置的名字相一致)
slave1

slave2

slave3
hadoop-env.sh文件
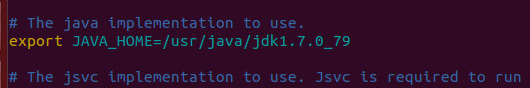
之前这一行是被注释掉的,解除注释后,加上自己的jdk绝对路径。
yarn-env.sh文件,和hadoop-env.sh一样,配置jdk环境变量

core-site.xml 文件
<property>

<name>fs.defaultFS</name>

<value>hdfs://master:9000</value>

</property>

<property>

<name>io.file.buffer.size</name>

<value>131072</value>

</property>

<property>

<name>hadoop.tmp.dir</name>

<value>file:/usr/local/hadoop/tmp</value>

</property>
hdfs-site.xml文件
<property>

<name>dfs.namenode.secondary.http-address</name>

<value>master:9001</value>

</property>

<property>

<name>dfs.namenode.name.dir</name>

<value>file:/usr/local/hadoop/tmp/name</value>

</property>

<property>

<name>dfs.datanode.data.dir</name>

<value>file:/usr/local/hadoop/tmp/data</value>

</property>

<property>

<name>dfs.replication</name>

<value>4</value>

</property>

<property>

<name>dfs.webhdfs.enabled</name>

<value>true</value>

</property>

<property>

<name>dfs.permissions</name>

<value>false</value>

</property>
mapred-site.xml
这个配置文件本来是不存在的,但是有一个名为mapred-site.xml.template的模板文件,执行mv mapred-site.xml.template mapred-site.xml复制重命名一份就行了,然后做配置
<property>

<name>mapreduce.framework.name</name>

<value>yarn</value>

</property>

<property>

<name>mapreduce.jobhistory.address</name>

<value>master:10020</value>

</property>

<property>

<name>mapreduce.jobhistory.webapp.address</name>

<value>master:19888</value>

</property>
yarn-site.xml文件
<property>

<name>yarn.nodemanager.aux-services</name>

<value>mapreduce_shuffle</value>

</property>

<property>

<name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name>
<value>org.apache.hadoop.mapred.ShuffleHandler</value>

</property>

<property>

<name>yarn.resourcemanager.address</name>

<value>master:8032</value>

</property>

<property>
<name>yarn.resourcemanager.scheduler.address</name>

<value>master:8030</value>

</property>

<property>

<name>yarn.resourcemanager.resource-tracker.address</name>

<value>master:8031</value>

</property>

<property>

<name>yarn.resourcemanager.admin.address</name>

<value>master:8033</value>

</property>

<property>
<name>yarn.resourcemanager.webapp.address</name>

<value>master:8088</value>

</property>
这样,hadoop的所有配置就做好了。
然后再把这个/usr/local/hadoop文件分别发送给另外三个slave,执行如下命令即可,不过要在目标文件夹设置好读写权限
比如在slave1上设置读写权限,在/usr/local目录下执行如下命令即可
sudo chown -R hadoop ./
其中hadoop是我的用户名,./表示当前目录
然后再master机器上执行如下命令就可以把hadoop文件发送到slave1上了,slave2和3方法相同
scp -r /usr/local/hadoop hadoop@slave1:/usr/local/
3 发送过去之后修改slave中几个配置文件
首先就是像master一样配置环境变量,前边写了,不赘述了。然后修改core-site.xml文件dfs.datanode.data.dir这一项,如下
<property>

<name>dfs.datanode.data.dir</name>

<value>file:/usr/local/hadoop/tmp/data/node1</value>

</property>
在data后边又添加了一个目录叫node1,在slave2上添加的就叫nade2,以此类推,不这样配置会检测不出当前存在的某些虚拟机。
以上就完成了,然后就是通过命令启动master上的hadoop,slave上的某些进程就会启动,就ok了。
Hadoop2.6.0 完全分布式搭建的更多相关文章
- hadoop2.2.0伪分布式搭建3--安装Hadoop
3.1上传hadoop安装包 3.2解压hadoop安装包 mkdir /cloud #解压到/cloud/目录下 tar -zxvf hadoop-2.2.0.tar.gz -C /cloud/ 3 ...
- hadoop2.2.0伪分布式搭建
1.准备Linux环境 1.0点击VMware快捷方式,右键打开文件所在位置 -> 双击vmnetcfg.exe -> VMnet1 host-only ->修改subnet ...
- Hadoop2.6.0伪分布式搭建
环境: 1.Ubuntu14.04 首先要在linux系统上新建一个账户,比如就叫做hadoop,用于专门运行hadoop. 2.配置jdk 我是使用的版本是jdk1.8. 解压:创建/usr/jav ...
- hadoop2.4.0伪分布式搭建以及分布式关机重启后datanode没起来的解决办法
1.准备Linux环境 1.0点击VMware快捷方式,右键打开文件所在位置 -> 双击vmnetcfg.exe -> VMnet1 host-only ->修改subnet ip ...
- hadoop2.2.0伪分布式搭建1--准备Linux环境
1.0修改网关 点击VMware快捷方式,右键打开文件所在位置 -> 双击vmnetcfg.exe -> VMnet1 host-only ->修改subnet ip 设置网段:19 ...
- hadoop2.2.0伪分布式搭建2--安装JDK
2.1上传FileZilla 上传 https://filezilla-project.org/ 2.2解压jdk #创建文件夹 mkdir /usr/java #解压 tar -zxvf jdk-7 ...
- Hadoop2.5.0伪分布式环境搭建
本章主要介绍下在Linux系统下的Hadoop2.5.0伪分布式环境搭建步骤.首先要搭建Hadoop伪分布式环境,需要完成一些前置依赖工作,包括创建用户.安装JDK.关闭防火墙等. 一.创建hadoo ...
- 在Win7虚拟机下搭建Hadoop2.6.0伪分布式环境
近几年大数据越来越火热.由于工作需要以及个人兴趣,最近开始学习大数据相关技术.学习过程中的一些经验教训希望能通过博文沉淀下来,与网友分享讨论,作为个人备忘. 第一篇,在win7虚拟机下搭建hadoop ...
- bayaim_hadoop1_2.2.0伪分布式搭建
------------------bayaim_hadoop1_2.2.0伪分布式搭建_2018年11月06日09:21:46--------------------------------- 1. ...
随机推荐
- UDP端口启动后一段时间无法接收到数据
接口需求:开发一个UDP协议的接口作为服务端接收来自客户端的认证数据,数据量每分钟7w+条; 数据格式:标准的redius协议,redius协议的相关知识在网上查资料,提供线索:http://blog ...
- Python语法糖
1.装饰器 ####装饰器的固定格式 ##普通版本 def timer(func): def inner(*args,**kwargs): '''执行函数之前要做的''' ret = func(*ar ...
- JS基础——数组API之数组操作(filter、map、some、every、sort)
var arr = [1,2,3,4]; forEach arr.forEach((item,index,arr) => { console.log(item) //结果为1,2,3,4 } ...
- [tree]合并果子(哈夫曼树+优先队列)
现在有n堆果子,第i堆有ai个果子.现在要把这些果子合并成一堆,每次合并的代价是两堆果子的总果子数.求合并所有果子的最小代价. Input 第一行包含一个整数T(T<=50),表示数据组数. 每 ...
- ABAP术语-Document Number
Document Number 原文:http://www.cnblogs.com/qiangsheng/archive/2008/01/28/1055636.html Key which ident ...
- 单机安装hadoop+hive+presto
系统环境 在个人笔记本上使用virtualbox虚拟机 os:centos -7.x86-64.everything.1611 ,内核 3.10.0-514.el7.x86_64 注:同样可以使用r ...
- python核心编程2 第九章 练习
9–1. 文件过滤. 显示一个文件的所有行, 忽略以井号( # )开头的行. 这个字符被用做Python , Perl, Tcl, 等大多脚本文件的注释符号.附加题: 处理不是第一个字符开头的注释. ...
- SI - 系统 - 操作系统简述 (Operating System)
Unix 操作系统:System V.BSD Microsoft Windows Apple Mac OS Linux FreeBSD 安装 https://jingyan.baidu.com/art ...
- JavaScript : CORS和Ajax请求
CORS(Cross-Origin Resource Sharing, 跨源资源共享)是W3C出的一个标准,其思想是使用自定义的HTTP头部让浏览器与服务器进行沟通,从而决定请求或响应是应该成功,还是 ...
- npm 如何提升最新版本
首先我们查看一下npm当前版本,打开cmd 运行命令: npm -v 如果不是最新版本,运行一下代码即可. npm install -g npm 这样npm就更新到最新版本了. 如果想更新到指定版本, ...