
python 案例:使用BeautifuSoup4的爬虫
我们以腾讯社招页面来做演示:http://hr.tencent.com/position.php?&start=10#a
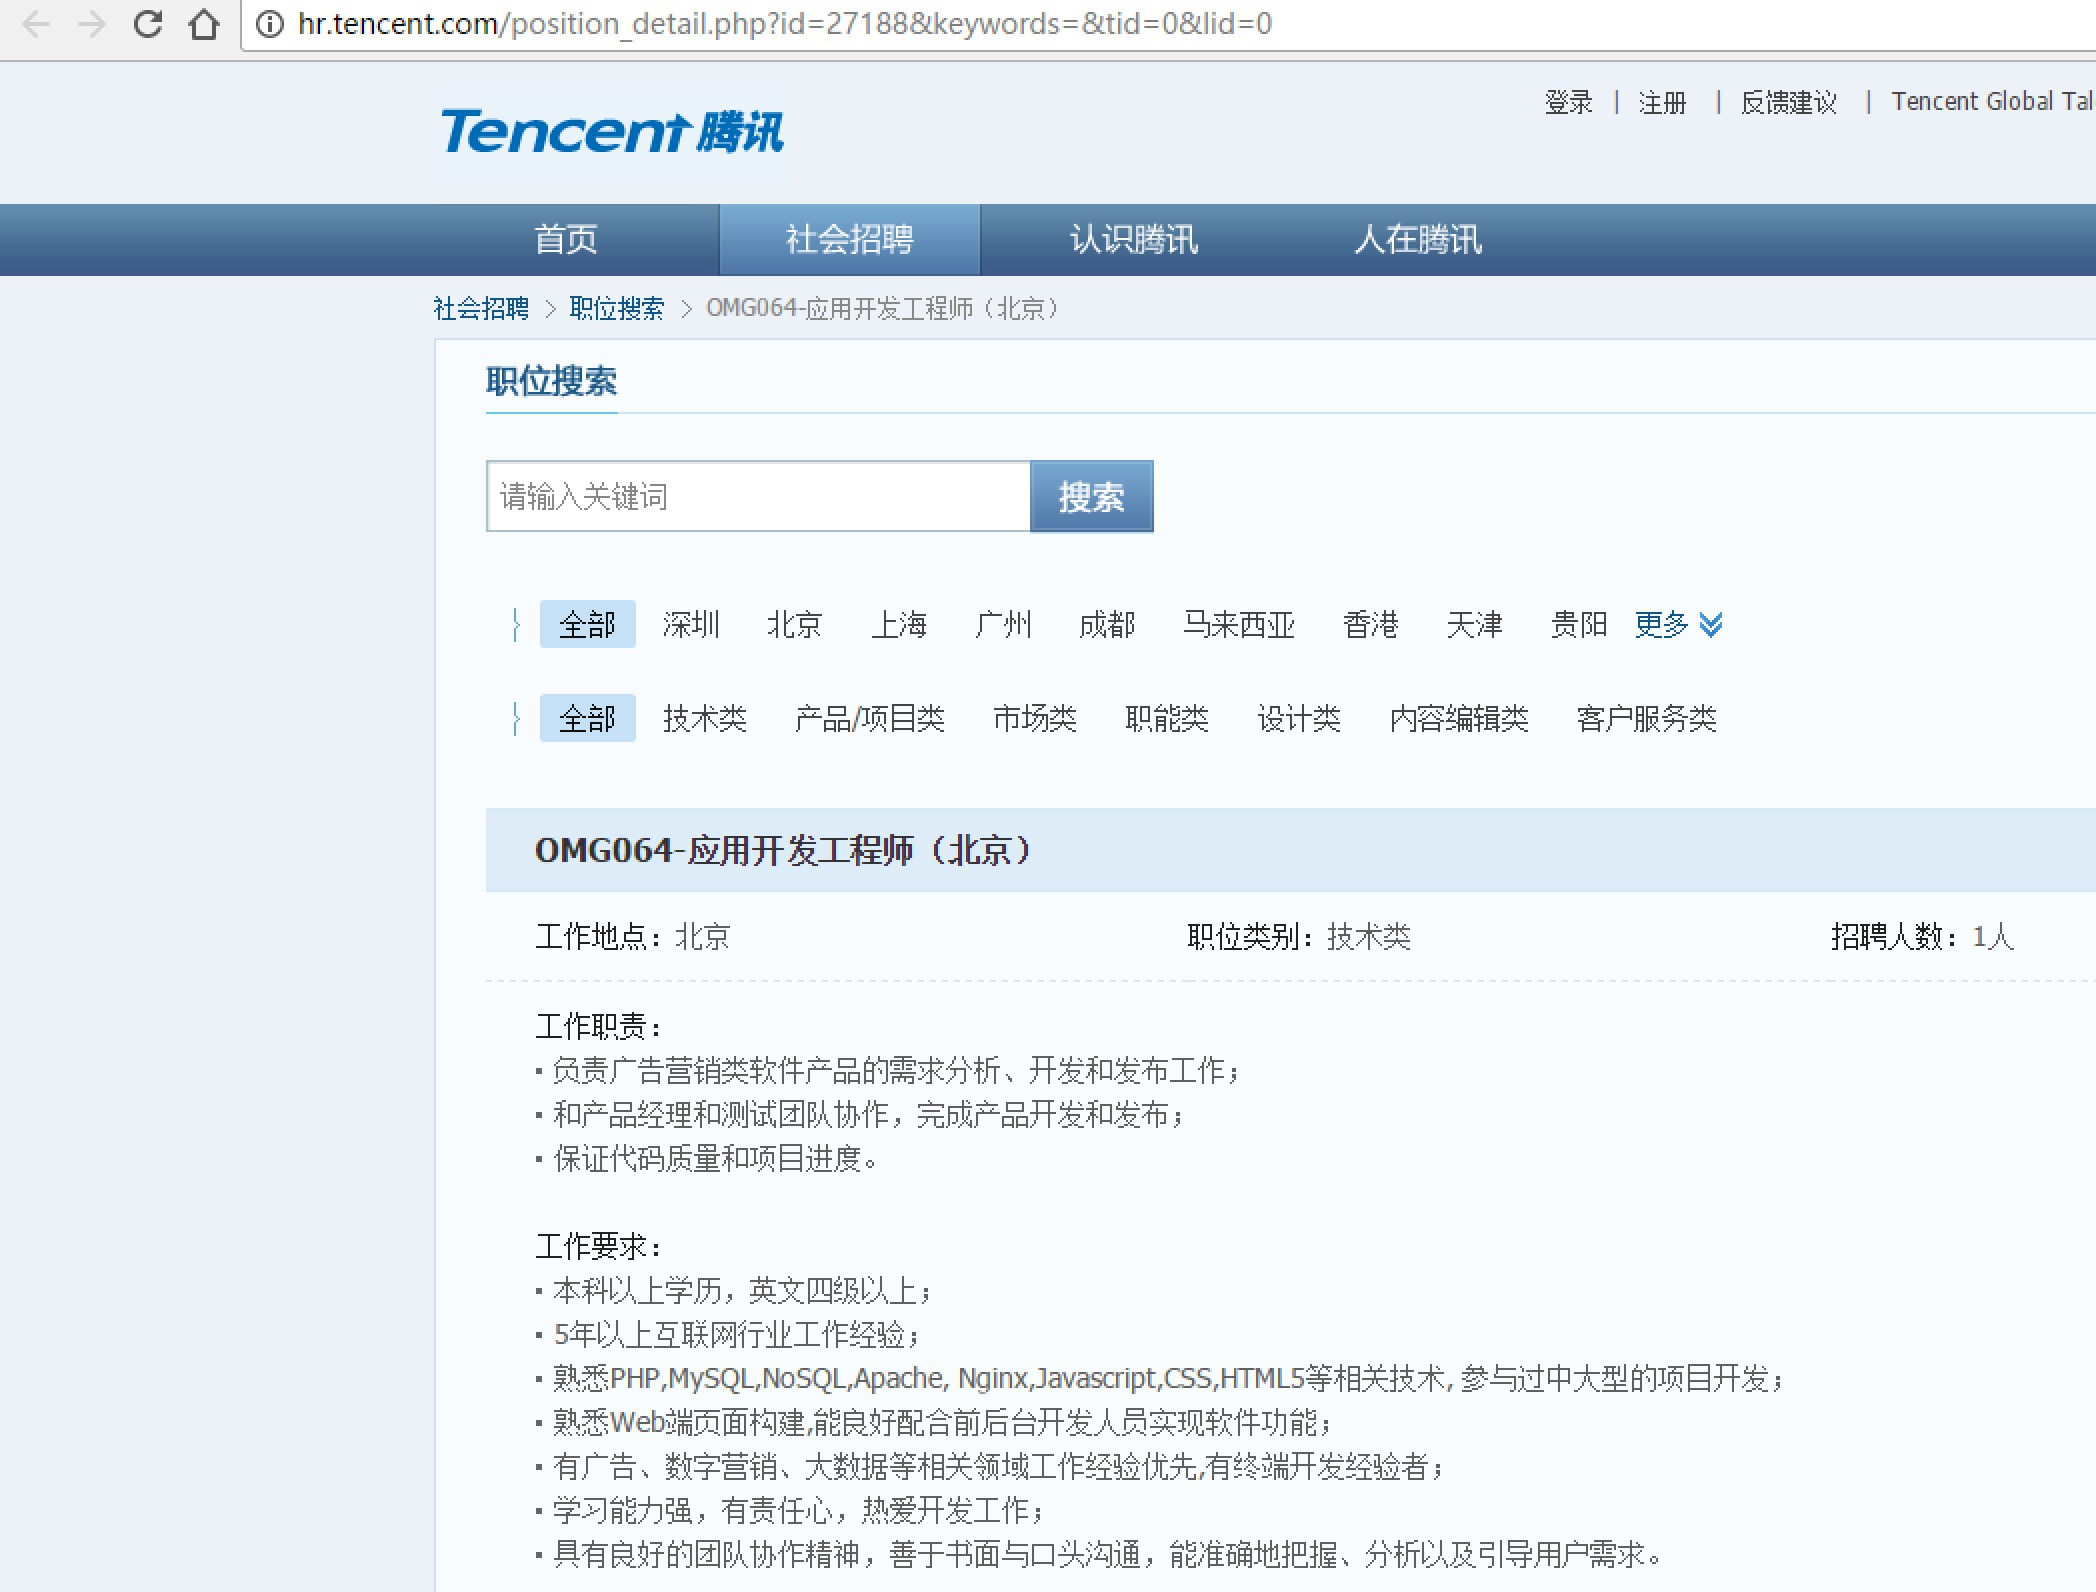
使用BeautifuSoup4解析器,将招聘网页上的职位名称、职位类别、招聘人数、工作地点、发布时间,以及每个职位详情的点击链接存储出来。
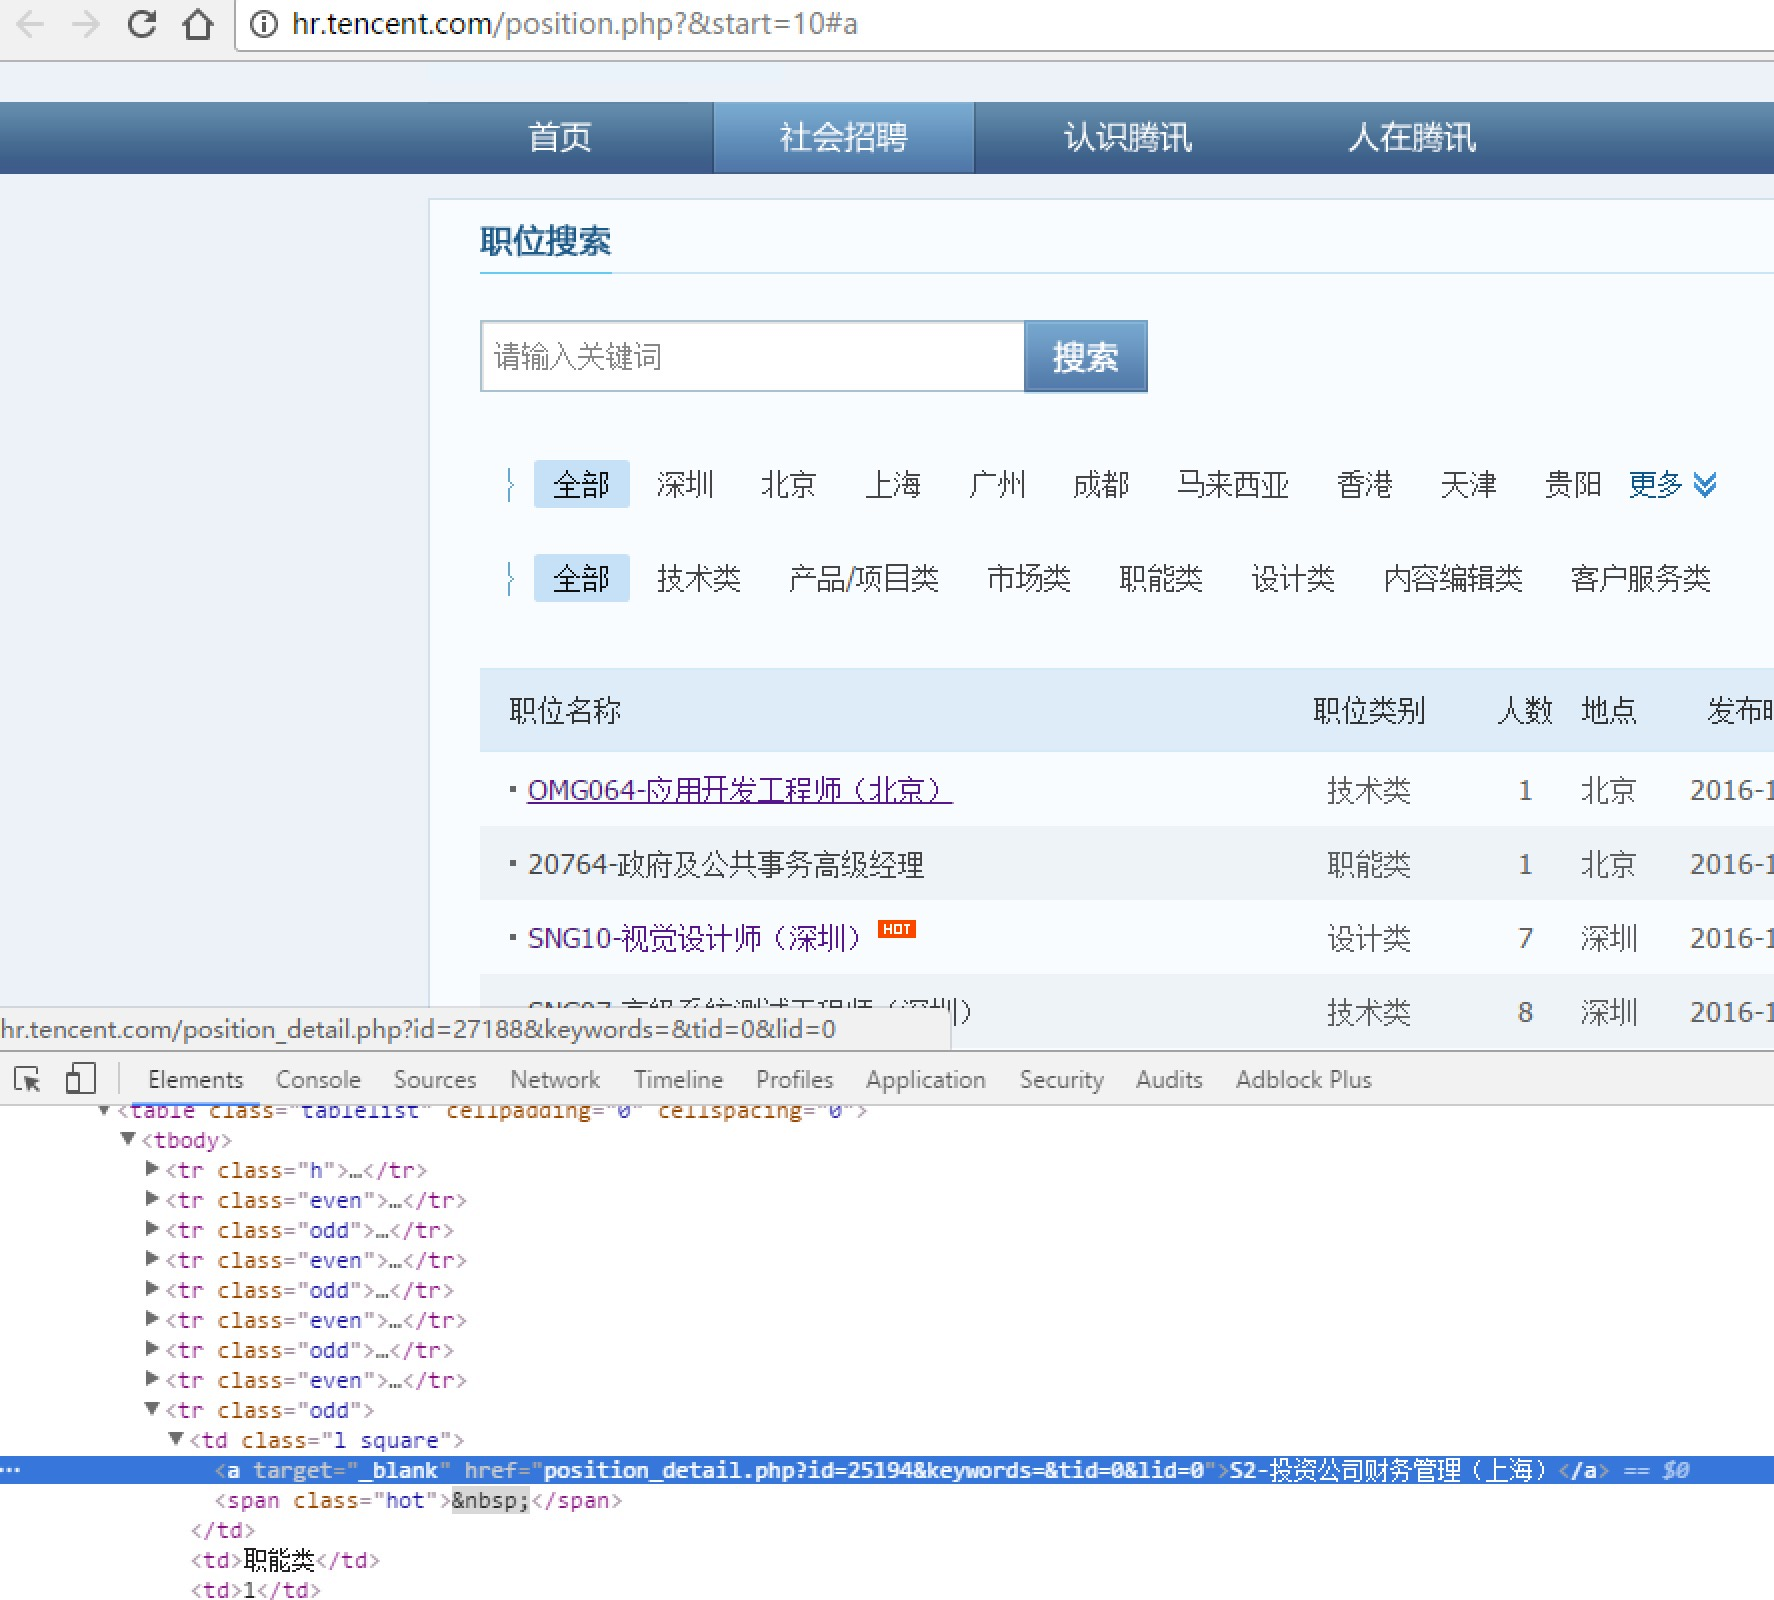
# bs4_tencent.py

from bs4 import BeautifulSoup

import urllib2

import urllib

import json    # 使用了json格式存储

def tencent():

    url = 'http://hr.tencent.com/'

    request = urllib2.Request(url + 'position.php?&start=10#a')

    response =urllib2.urlopen(request)

    resHtml = response.read()

    output =open('tencent.json','w')

    html = BeautifulSoup(resHtml,'lxml')

# 创建CSS选择器

    result = html.select('tr[class="even"]')

    result2 = html.select('tr[class="odd"]')

    result += result2

    items = []

    for site in result:

        item = {}

        name = site.select('td a')[0].get_text()

        detailLink = site.select('td a')[0].attrs['href']

        catalog = site.select('td')[1].get_text()

        recruitNumber = site.select('td')[2].get_text()

        workLocation = site.select('td')[3].get_text()

        publishTime = site.select('td')[4].get_text()

        item['name'] = name

        item['detailLink'] = url + detailLink

        item['catalog'] = catalog

        item['recruitNumber'] = recruitNumber

        item['publishTime'] = publishTime

        items.append(item)

    # 禁用ascii编码,按utf-8编码

    line = json.dumps(items,ensure_ascii=False)

    output.write(line.encode('utf-8'))

    output.close()

if __name__ == "__main__":

   tencent()
python 案例:使用BeautifuSoup4的爬虫的更多相关文章
- 2.6. 案例:使用BeautifuSoup4的爬虫
案例:使用BeautifuSoup4的爬虫 我们以腾讯社招页面来做演示:http://hr.tencent.com/position.php?&start=10#a 使用BeautifuSou ...
- python Cmd实例之网络爬虫应用
python Cmd实例之网络爬虫应用 标签(空格分隔): python Cmd 爬虫 废话少说,直接上代码 # encoding=utf-8 import os import multiproces ...
- 获取字段唯一值工具- -ArcPy和Python案例学习笔记
获取字段唯一值工具- -ArcPy和Python案例学习笔记 目的:获取某一字段的唯一值,可以作为工具使用,也可以作为函数调用 联系方式:谢老师,135-4855-4328,xiexiaokui# ...
- 使用python做最简单的爬虫
使用python做最简单的爬虫 --之心 #第一种方法import urllib2 #将urllib2库引用进来response=urllib2.urlopen("http://www.ba ...
- 14.python案例:爬取电影天堂中所有电视剧信息
1.python案例:爬取电影天堂中所有电视剧信息 #!/usr/bin/env python3 # -*- coding: UTF-8 -*- '''======================== ...
- 第7.27节 Python案例详解: @property装饰器定义属性访问方法getter、setter、deleter
上节详细介绍了利用@property装饰器定义属性的语法,本节通过具体案例来进一步说明. 一. 案例说明 本节的案例是定义Rectangle(长方形)类,为了说明问题,除构造函数外,其他方法都只 ...
- 第7.25节 Python案例详解:使用property函数定义与实例变量同名的属性会怎样?
第7.25节 Python案例详解:使用property函数定义与实例变量同名的属性会怎样? 一. 案例说明 我们上节提到了,使用property函数定义的属性不要与类内已经定义的普通实例变量重 ...
- 第7.24节 Python案例详解:使用property函数定义属性简化属性访问代码实现
第7.24节 Python案例详解:使用property函数定义属性简化属性访问代码实现 一. 案例说明 本节将通过一个案例介绍怎么使用property定义快捷的属性访问.案例中使用Rectan ...
- 案例:使用BeautifuSoup4的爬虫
使用BeautifuSoup4解析器,将招聘网页上的招聘单位名称存储出来.其他信息可类似爬取即可 # -*- coding:utf-8 -*- from bs4 import BeautifulSou ...
随机推荐
- 【mybatis】mybatis执行一个update方法,返回值为1,但是数据库中数据并未更新,粘贴sql语句直接在数据库执行,等待好久报错:Lock wait timeout exceeded; try restarting transaction
今天使用mybatis和jpa的过程中,发现这样一个问题: mybatis执行一个update方法,返回值为1,但是数据库中数据并未更新,粘贴sql语句直接在数据库执行,等待好久报错:Lock wai ...
- 【IntellJ IDEA】idea忽略隐藏文件、文件夹的设置操作
左上角setting 如果要忽略文件夹,则直接填写文件夹名字即可,例如:要忽略target文件夹[建议:尽量不要把target忽略,因为可能编译出问题排查,还需要查看target文件夹中的编译结果] ...
- ES6/ES2015核心内容(下)
import export 这两个家伙对应的就是es6自己的module功能. 我们之前写的Javascript一直都没有模块化的体系,无法将一个庞大的js工程拆分成一个个功能相对独立但相互依赖的小工 ...
- solr curl索引 CSV/Json/xml文件
在windows系统中,用curl命令工具索引文件命令: 启动solr 在solr-6.6.0\bin的同级目录下的文件夹ImportData下要索引的文件. 1.索引 json文件 curl &qu ...
- poj 3468 A Simple Problem with Integers 线段树区间更新
id=3468">点击打开链接题目链接 A Simple Problem with Integers Time Limit: 5000MS Memory Limit: 131072 ...
- python——深刻理解Python中的元类(metaclass)
译注:这是一篇在Stack overflow上 很热的帖子.提问者自称已经掌握了有关Python OOP编程中的各种概念,但始终觉得元类(metaclass)难以理解.他知道这肯定和自省有关,但仍然觉 ...
- WP8控件进度条(ProgressBar)的使用
--前台代码 <Grid x:Name="ContentPanel" Grid.Row="1" Margin="0,0,24,0"& ...
- SHOW CREATE DATABASE Syntax
SHOW CREATE {DATABASE | SCHEMA} [IF NOT EXISTS] db_name Shows the CREATE DATABASE statement that cre ...
- android-数据库SQLite相关
android平台下的SQLite数据库是一种轻量级数据库,支持标准的SQL语句. 本文将介绍 android数据库的创建 利用sql语句对数据库增删改查 系统api数据库增删改查 数据库的事务 1, ...
- UnicodeEncodeError: ‘gbk’ codec can’t encode character u’\u200e’ in position 43: illegal multibyte sequence
[问题] python中已获取网页: http://blog.csdn.net/hfahe/article/details/5494895 的html源码,其时UTF-8编码的. 提取出其标题部分: ...