
Bagging Classifier+Regressor
from sklearn.ensemble import BaggingRegressor
Bagging通过引入随机化增大每个估计器之间的差异。
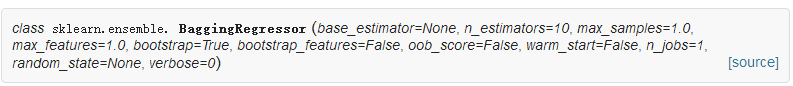
参数介绍:
base_estimator:Object or None。None代表默认是DecisionTree,Object可以指定基估计器(base estimator)。
n_estimators:int, optional (default=10) 。 要集成的基估计器的个数。
max_samples: int or float, optional (default=1.0)。决定从x_train抽取去训练基估计器的样本数量。int 代表抽取数量,float代表抽取比例
max_features : int or float, optional (default=1.0)。决定从x_train抽取去训练基估计器的特征数量。int 代表抽取数量,float代表抽取比例
bootstrap : boolean, optional (default=True) 决定样本子集的抽样方式(有放回和不放回)
bootstrap_features : boolean, optional (default=False)决定特征子集的抽样方式(有放回和不放回)
oob_score : bool 决定是否使用包外估计(out of bag estimate)泛化误差
warm_start : bool, optional (default=False) true代表
n_jobs : int, optional (default=1)
random_state : int, RandomState instance or None, optional (default=None)。如果int,random_state是随机数生成器使用的种子; 如果RandomState的实例,random_state是随机数生成器; 如果None,则随机数生成器是由np.random使用的RandomState实例。
verbose : int, optional (default=0)
属性介绍:
estimators_ : list of estimators。The collection of fitted sub-estimators.
estimators_samples_ : list of arrays
estimators_features_ : list of arrays
oob_score_ : float,使用包外估计这个训练数据集的得分。
oob_prediction_ : array of shape = [n_samples]。在训练集上用out-of-bag估计计算的预测。 如果n_estimator很小,则可能在抽样过程中数据点不会被忽略。 在这种情况下,oob_prediction_可能包含NaN。
还要解决三个问题
①他到底是什么,用于什么情况?
BaggingRegressor就是一个Bagging的回归器组合。说到底还是用于集成多个回归器,所以还是会勇于回归预测的情况,集成一下解决过拟合的问题。
②他的优缺点?
③调参过程?
from sklearn.ensemble import BaggingClassifier
Bagging Classifier+Regressor的更多相关文章
- sklearn中各种分类器回归器都适用于什么样的数据呢?
作者:匿名用户链接:https://www.zhihu.com/question/52992079/answer/156294774来源:知乎著作权归作者所有.商业转载请联系作者获得授权,非商业转载请 ...
- scikit-learn:class and function reference(看看你究竟掌握了多少。。)
http://scikit-learn.org/stable/modules/classes.html#module-sklearn.decomposition Reference This is t ...
- 我的第一个 Kaggle 比赛学习 - Titanic
背景 Titanic: Machine Learning from Disaster - Kaggle 2 年前就被推荐照着这个比赛做一下,结果我打开这个页面便蒙了,完全不知道该如何下手. 两年后,再 ...
- AdaBoost Classifier和Regressor
Adaboost原理传送门 AdaBoost在我看理论课程的时候,以分类为例子来讲解的,谁知道sklearn里面基本上都有classifier和regressor两种.这个倒是我没想到的!!! fro ...
- Keras(三)backend 兼容 Regressor 回归 Classifier 分类 原理及实例
backend 兼容 backend,即基于什么来做运算 Keras 可以基于两个Backend,一个是 Theano,一个是 Tensorflow 查看当前backend import keras ...
- 集成学习---bagging and boosting
作为集成学习的二个方法,其实bagging和boosting的实现比较容易理解,但是理论证明比较费力.下面首先介绍这两种方法. 所谓的集成学习,就是用多重或多个弱分类器结合为一个强分类器,从而达到提升 ...
- 模式识别与机器学习—bagging与boosting
声明:本文用到的代码均来自于PRTools(http://www.prtools.org)模式识别工具箱,并以matlab软件进行实验. (1)在介绍Bagging和Boosting算法之前,首先要简 ...
- [机器学习]集成学习--bagging、boosting、stacking
集成学习简介 集成学习(ensemble learning)通过构建并结合多个学习器来完成学习任务. 如何产生"好而不同"的个体学习器,是集成学习研究的核心. 集成学习的思路是通过 ...
- 集成学习算法汇总----Boosting和Bagging(推荐AAA)
sklearn实战-乳腺癌细胞数据挖掘(博主亲自录制视频) https://study.163.com/course/introduction.htm?courseId=1005269003& ...
随机推荐
- mvc4 初体验(一)
[AllowAnonymous] [AllowAnonymous] 属性,允许匿名 在BaseControler里面加一个[Authorize],所有要验证的页面都继承BaseControler, 不 ...
- Android 本地搭建Tomcat服务器供真机测试
准备工具:tomcat 环境:win7 + JDK1.8 + tomcat 9.0.13(64bit) 准备工具:tomcat 1.tomcat官网下载 https://tomcat. ...
- linux学习路线图
- C程序设计语言习题(3-3)
编写函数expand(s1,s2), 将字符串s1中类似于a-z一类的速记符号在字符串s2中扩展为等价的完整列表abc……xyz.该函数可以处理大小写字母和数字,并可以处理a-b-c.a-z0-9与a ...
- 在稳定性测试中,将测试结果持续填加进入html报告
公司需要设计一个稳定性测试,就是一直持续的跑不同的用例,直到人为停止,用例基本完成,基本框架思路就是随机选择一个testcase,跑完后输出结果.但存在一个问题,现在的unittest或nose测试报 ...
- dhroid - Perference
SharedPreferences 是我们开发android使用很多的工具通常我们是这样使用的 SharedPreferences share=getSharedPreferences("n ...
- Python - 3MySQL 数据库连接
Python3 MySQL 数据库连接 本文我们为大家介绍 Python3 使用 PyMySQL 连接数据库,并实现简单的增删改查. 什么是 PyMySQL? PyMySQL 是在 Python3.x ...
- 基本类型互相之间转化可以用Covent类来实现。
一.C#类型的转换 在c#中类型的转换分两种:显式和隐式,基本的规则如下: 1.基类对象转化为子类对象,必须显式转换,规则:(类型名) 对象.2.值类型和引用类型的转换采用装箱(boxing)或拆箱( ...
- cp命令取消提示的方法
Linux默认cp命令带参数-i如果有重复的文件会提示覆盖 查看cp别名 在大量复制的时候这个提示不友好,在脚本写复制命令也无法使用交互式输入 解决办法 1,修改别名 vi ~/.bashrc 注释掉 ...
- HOJ 1438 The Tower of Babylon(线性DP)
The Tower of Babylon My Tags Cancel - Seperate tags with commas. Source : University of Ulm Internal ...