
Spark 概述
Spark 是什么?
● 官方文档解释:Apache Spark is a fast and general engine for large-scale data processing.
通俗的理解:Spark是基于内存计算的大数据并行计算框架。Spark基于内存计算,提高了在大数据环境下数据处理的实时性,同时保证了高容错性和高可伸缩性,允许用户将Spark 部署在大量廉价硬件之上,形成集群。
● 扩展了MapReduce计算模型;相比与MapReduce编程模型,Spark提供了更加灵活的DAG(Directed Acyclic Graph) 编程模型, 不仅包含传统的map、reduce接口, 还增加了filter、flatMap、union等操作接口,使得编写Spark程序更加灵活方便。
● 高效支持多种计算模式;Spark 不仅可以做离线运算,还可以做流式运算以及迭代式运算。
Spark与Hadoop的关系
Spark与Hadoop的关系---青出于蓝
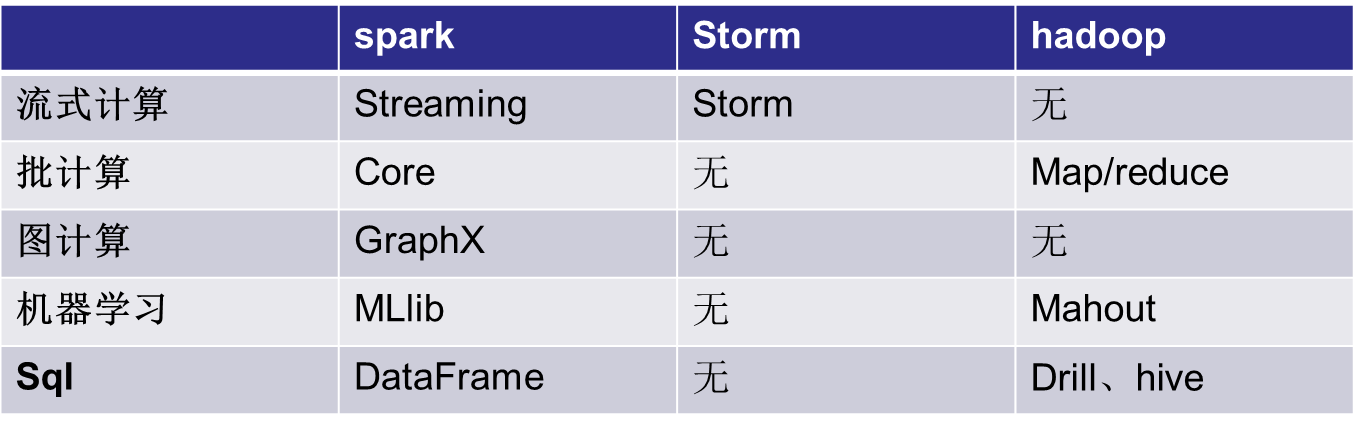
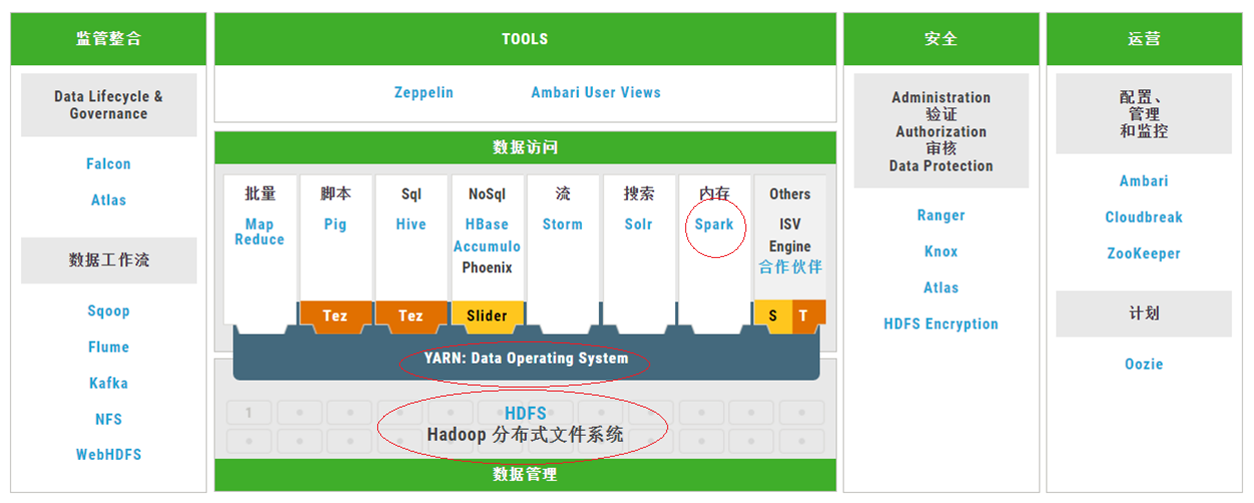
Spark与Hadoop的关系---相辅相成
Spark的竞争对手---Flink

● Flink是先有流处理后有批处理
● Pipeline vs Stage
● 详细内容参看http://note.youdao.com/share/?id=f3b0a1832e4ee43e3e3635913d5e00e1&type=note
Spark的竞争对手---Storm/JStorm

● Storm仅限于流计算(topology)
● JStorm参照Flink改进了Storm
Spark的竞争对手---Hadoop3.x
详细内容参看http://blog.51cto.com/zero01/2096435
以上就是博主为大家介绍的这一板块的主要内容,这都是博主自己的学习过程,希望能给大家带来一定的指导作用,有用的还望大家点个支持,如果对你没用也望包涵,有错误烦请指出。如有期待可关注博主以第一时间获取更新哦,谢谢!
Spark 概述的更多相关文章
- 大数据技术之_19_Spark学习_01_Spark 基础解析 + Spark 概述 + Spark 集群安装 + 执行 Spark 程序
第1章 Spark 概述1.1 什么是 Spark1.2 Spark 特点1.3 Spark 的用户和用途第2章 Spark 集群安装2.1 集群角色2.2 机器准备2.3 下载 Spark 安装包2 ...
- Spark概述及集群部署
Spark概述 什么是Spark (官网:http://spark.apache.org) Spark是一种快速.通用.可扩展的大数据分析引擎,2009年诞生于加州大学伯克利分校AMPLab,2010 ...
- 大话Spark(1)-Spark概述与核心概念
说到Spark就不得不提MapReduce/Hadoop, 当前越来越多的公司已经把大数据计算引擎从MapReduce升级到了Spark. 至于原因当然是MapReduce的一些局限性了, 我们一起先 ...
- Spark入门:第1节 Spark概述:1 - 4
2.spark概述 2.1 什么是spark Apache Spark™ is a unified analytics engine for large-scale data processing. ...
- 1 Spark概述
第1章 Spark概述 1.1 什么是Spark Spark是一种快速.通用.可扩展的大数据分析引擎,2009年诞生于加州大学伯克利分校AMPLab,2010年开源,2013年6月成为Apache孵 ...
- Spark概述
背景 目前按照大数据处理类型来分大致可以分为:批量数据处理.交互式数据查询.实时数据流处理,这三种数据处理方式对应的业务场景也都不一样: 关注大数据处理的应该都知道Hadoop,而Hadoop的核心为 ...
- Hive On Spark概述
Hive现有支持的执行引擎有mr和tez,默认的执行引擎是mr,Hive On Spark的目的是添加一个spark的执行引擎,让hive能跑在spark之上: 在执行hive ql脚本之前指定执行引 ...
- 3.1 Spark概述
一.Spark简介 1.Spark的特点 特点1:运行速度快(内存计算,循环数据流.有向无环图设计机制) 把所有针对数据集的操作转换成一张有向无环图,整个执行引擎调度都是基于这个有向无环图,对这个有向 ...
- Spark学习一:Spark概述
1.1 什么是Spark Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎. 一站式管理大数据的所有场景(批处理,流处理,sql) spark不涉及到数据的存储,只 ...
随机推荐
- JAVA 1.7并发之Fork/Join框架
在之前的博文里有说过executor框架,其实Fork/Join就是继承executor的升级版啦 executor用于创建一个线程池,但是需要手动的添加任务,如果需要将大型任务分治,显然比较麻烦 而 ...
- java ----一个函数传回多个值的总结
java 一个函数如何返回多个值 参考方法: 1.使用map返回值:这个方法问题是,你并不知道如何返回值的key是什么,只能通过doc或者通过源代码来查看. 2.传入一个引用进去,修改引用的属性值.问 ...
- ss3
1)执行如下命令,进行安装shadowsocks(命令需要一条条的输入,然后回车,执行完一条,在执行下一条命令),过程中可能会让你选择确认的地方,直接输入"y"回车即可: yum ...
- nop前端分页实现思路及步骤
注:nop本身已经有啦可以实现分页的类,所以我们直接去使用就可以啦 . (编程部分)步骤如下: 第一步,针对Model操作,在需要使用分页的界面Model中将分页类作为该Model类的成员,并在Mod ...
- oracle 实现 自增主键功能
转自:https://blog.csdn.net/zxh2075/article/details/78488141 之前有一项工作是将mysql的数据库实现转移到oracle,遇到了自增主键实现的问题 ...
- new/delete 和malloc/free 的区别
new/delete 和malloc/free 的区别 一.基本概念malloc/free:1.函数原型及说明: void *malloc(long NumBytes):该函数分配了NumB ...
- (补)Java解析XML之dom4j
上次记得忘了记最流行的dom4j方法了,用的还是上次的那个XML文件 注:需要添加dom4j.jar文件 package com.xujingyang.dom4j; import org.dom4j. ...
- spider(一)
此爬虫内容无架构: 1.URL管理器:用集合,mysql表,缓存等 2.网页下载器:实现网页下载, urllib2:官方基础模块 requests:三方的(更强):伪装成浏览器访问,代理登录,http ...
- Jenkins配置有用摘抄笔记
使用jenkins配置.net mvc5网站自动构建全过程记录 转自:http://www.cnblogs.com/baiyunchen/p/4724350.html 持续集成是个简单重复劳动,人来 ...
- IFrame与window对象(contentWindow)
ref:http://blog.csdn.net/dongzhiquan/article/details/5851201 var detialIframe=document.all("det ...