
火山引擎云原生数据仓库 ByteHouse 技术白皮书 V1.0(上)
更多技术交流、求职机会,欢迎关注字节跳动数据平台微信公众号,回复【1】进入官方交流群
近日,《火山引擎云原生数据仓库 ByteHouse 技术白皮书》正式发布。白皮书简述了 ByteHouse 基于 ClickHouse 引擎的发展历程,首次详细展现 ByteHouse 的整体架构设计及自研核心技术,为云原生数据仓库发展,及企业数字化转型实战运用提供最新的参考和启迪。
以下为 ByteHouse 技术白皮书前两个版块摘录。
1.ByteHouse 简介
ByteHouse 是字节跳动自主研发的云原生数据仓库产品,在开源 ClickHouse 引擎之上做了技术架构重构,实现了云原生环境的部署和运维管理、存储计算分离、多租户管理等功能。在可扩展性、稳定性、可运维性、性能以及资源利用率方面都有巨大的提升。
截至 2022 年 2 月,ByteHouse 在字节跳动内部部署规模超过 1 万 8000 台,单集群超过 2400 台。经过内部数百个应用场景和数万用户锤炼,并在多个外部企业客户中得到推广应用。
产品特性
ByteHouse 以提供高性能、高资源利用率、高稳定性、低运维成本为目标,进行了优化设计和工程实现,产品特性和优势如下:
存储计算分离:解决了全局元数据管理,过多小文件存储性能差等等技术难题。在最小化性能损耗的情况下,实现存储层与计算层的分离,独立扩缩容。
新一代 MPP 架构:结合 Shared-nothing 的计算层以及 Shared-everything 的存储层,有效避免了传统 MPP 架构中的 Re-sharding 问题,同时保留了 MPP 并行处理能力。
数据一致性与事务支持。
计算资源隔离,读写分离:通过计算组(VW)概念,对宿主机硬件资源进行灵活切割分配,按需扩缩容。资源有效隔离,读写分开资源管理,任务之间互不影响,杜绝了大查询打满所有资源拖垮集群的现象。
ANSI-SQL:SQL 兼容性全面提升,支持 ANSI-SQL 2011 标准,TPC-DS 测试集 100%通过率。
UDF:支持 Python UDF/UDAF 创建与管理,补足函数的可扩展性。(Java UDF/UDAF 已在开发中)
自研优化器:自研 Cost-Based Optimizer,优化多表 JOIN 等复杂查询性能,性能提升若干倍。
产品能力上,在引擎外提供更加丰富的企业级功能和可视化管理界面:
库表资产管理:控制台建库建表,管理元信息。
多租户管理:支持多租户模型,租户间互相隔离,独立计费。
RBAC 权限管理:支持库、表、列级,读、写、资源管理等权限。通过角色进行管理。
VW 自动启停,弹性扩展:计算资源按需分配,闲时关闭。降低总成本,提高资源使用率。
性能诊断:提供 Query History 和 Query Profiler 功能,帮助用户自助地排查慢查询的原因。
适用场景
ByteHouse 定位为一款数据仓库产品,主要用于 OLAP 查询和计算场景。在实时数据接入、大宽表聚合查询、海量数据下复杂分析计算、多表关联查询场景下有非常好的性能。
主要的的应用场景如下:
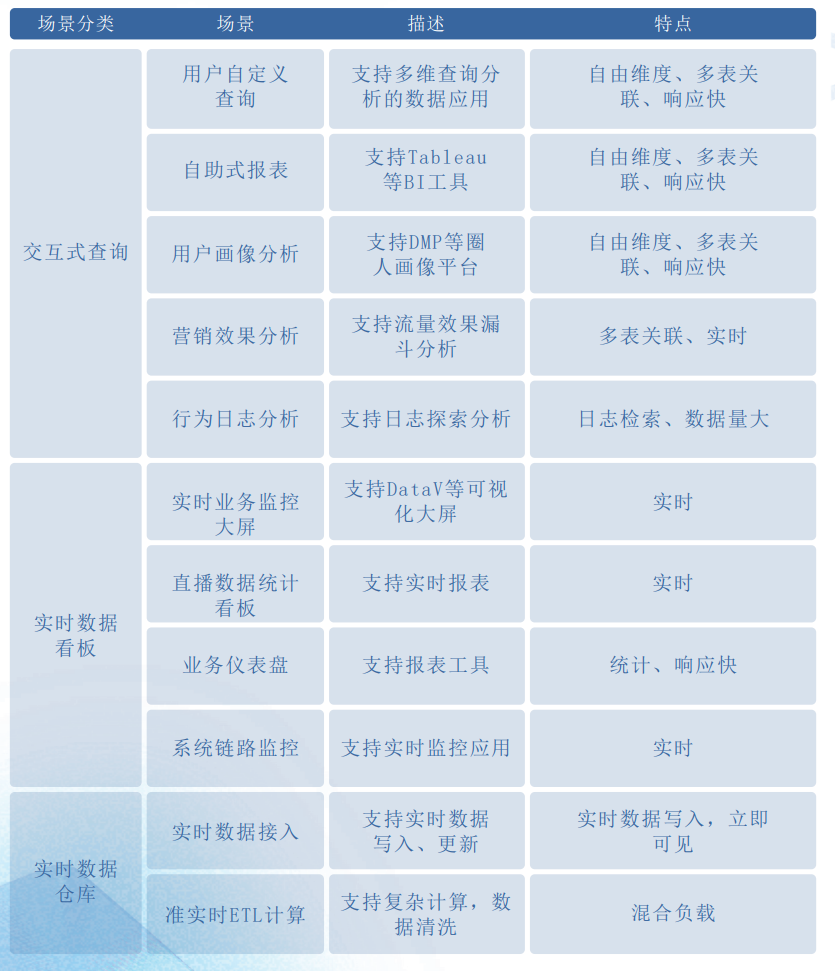
2.技术趋势和挑战
业务需求
企业级数据仓库场景中,需要融合来自多个业务系统数据库的业务数据,主要是交易记录,例如银行存取记录、用户订单记录等,通常是数千万至数亿条规模;用户行为日志是数据量最大的数据源,包括用户访问日志、用户操作记录等,这部分数据记录数量通常是业务数据的数百倍。
ByteHouse 需要支持海量数据的实时接入、无限扩展存储、实时合并计算和关联聚合查询。
随着大数据应用的深入发展,最核心的业务需求如下:
1)提高分析的实时性
最近 10 年,以 hadoop 技术体系为代表的大数据平台大规模部署,大大小小的企业和政府部门都搭建了大数据平台和分析应用,以隔天和小时级数据延迟的应用得到了普及;以 Flink 为代表的实时计算引擎解决了数据统计场景的时效性问题。
随着业务的发展和技术的进步,业务部门不再满足于 T+1 的分析需求和固化的实时统计,希望业务发生后秒级/分钟级延迟就能看到统计结果;希望能交互性探查分析数据,要求毫秒/秒级返回结果保持良好的用户体验。
在新的企业级数据架构中,对于已经构建大数据平台的企业,对时效性要求高的业务,用云原生数据仓库构建实时数据仓库,作为 hadoop 平台的补充;在数据量低于 1PB,没有构建 hadoop 等大数据平台的企业,直接以云原生数据仓库构建轻量级数据仓库。
2)成本可控
大数据应用逐步从互联网企业和政府部门,并深入到工业企业,先后进行了业务数据的大集中、用户行为数据和 IOT 数据的广泛采集存储,企业和政府单位的数据量每年呈现 30%以上的增长速度。
在过去集中式架构的数据仓库方案中,建设成本与数据总量正相关,成本居高不下;采用基于分布式架构的大数据方案中,由于存储计算耦合,为了满足存储空间膨胀,需要采购越来越多的服务器。
实时的数据采集和存储,导致数据量持续高速增长。
在新的云原生数据仓库方案中,既要解决数据和应用增长带来的扩展性问题,同时要解决成本问题,将数据存储和计算成本处于可控范围。
3)支持业务上云
根据智库报告的研究,目前业务上云已经形成趋势,除游戏视频电商等泛互联网企业之外,在政务、金融、制造业正在以私有云和混合云的方式持续上云,从而实现数据上云。
政务云和金融云是两大主要的行业云,平台建设水平较高,同时制造业、医疗卫生、交通等领域的行业云也在加速变革和加快建设行业云平台大规模建设和升级,实现数字化管理和运营。
制造业设备上云和云化改造能够实现制造业企业的数据互通和业务互联,支撑形成以数据驱动的智能化制造、实现供应链和上下游业务的网络化协同,以及实现对业务和设备的数字化管理等制造业发展新模式,引领制造业数字化转型。
业务上云从而数据上云,也在推动数据处理平台的云原生升级。
技术趋势
近年来,以 Snowflake 为代表的云原生数据仓库得到了客户的认同,市场上取得了巨大的成功。其核心功能和技术点是云原生的架构设计,利用 IAAS 的高可用和资源池化特性,通过存储计算分离、多租户隔离、容器化技术,提供数据仓库的扩展性、稳定性、可维护性和易用性,整体上提高资源利用率。
国际上,除了 Snowflake 之外,谷歌的 BigQuery、AWS 的 RedShift、Azure 的 Synapse 都实现了云原生的架构升级,实现了存储计算分离和多租户管理。Databricks、Firebolt 等新生的厂商及产品如雨后春笋一样涌现出来。
在国内,阿里云、华为云、腾讯云都推出了自己的云原生数据仓库产品;PingCap 的 TiDB、鼎石科技的 StarRocks 等独立产品也选择了云原生道路。
OLAP 产品有如下几个技术趋势:
1)云原生的整体架构
基于公共云、私有云或混合云的架构设计,应用容器化和微服务等云原生技术,实现敏捷开发、敏捷运维,天然解决扩展性问题。
2)存储服务化
对数据存储层进行统一抽象,灵活采用 HDFS 分布式存储或 S3 等对象存储作为数据存储载体,最终实现存储服务化,便于解决存储扩展性、读写吞吐瓶颈问题、数据一致性问题,同时能大幅降低存储成本。
此外,实现存储服务化后,对于产品的跨云兼容和多云部署带来方便。
3)计算资源池化
由于 OLAP 应用负载的波动特点,特别在支持多租户的场景下,通过计算资源池化,根据实时负载进行计算资源统一调度管理,实现资源隔离的同时,又能支持资源共享和实时弹性扩缩。从而提高集群整体利用率。
4)支持混合负载
在企业级应用中,OLAP 场景可以细分为交互查询和批量计算,前者要求毫秒/秒级响应并支持高并发查询,后者可以接受分钟/小时级延迟,但要求计算性能的稳定性和较好的 failover 机制。自适应支持多场景的混合负载是 OLAP 产品的核心能力。
5)其他
OLAP 平台中的计算资源、内存、网络带宽是最宝贵的资源,系统资源利用率通常围绕这三个资源进行优化。很多产品开始在计算 Serverless 化、分布式内存等方向进行探索。
技术挑战
ClickHouse 是近几年最热门的开源大数据产品,以其优异的查询性能引人瞩目,在全球得到了大量的推广和应用。字节跳动从 2017 年开始大规模使用 ClickHouse,总部署规模超过 1 万 8000 台,投入巨大的研发团队,对 ClickHouse 进行了大量的优化和改进,积累了丰富的应用场景和应用经验。
ByteHouse 的云原生技术方案也遇到了非常多的技术挑战,主要表现在几个方面。
数据实时写入性能
在大批量实时数据写入场景下,需要平衡数据一致性与写入吞量的矛盾,特别在存储计算分离后,远程数据访问网络开销加大,写入性能问题会显得更加突出,需要有新的解决方案。
多场景下查询性能
ClickHouse 以单表查询性能好著称,但在多表关联查询方面性能不理想,极大地限制了 ClickHouse 的应用场景。ByteHouse 定位为综合性能强的云原生数仓,需要兼顾多种应用场景下都能把持优异的性能。
资源弹性和隔离
ByteHouse 旨在提高整个集群的资源利用率,从而降低平台建设成本。由于 OLAP 应用的负载通常具有峰谷特性和随机性,要求具备资源弹性共享和资源隔离的能力,在保证性能和 SLA 的情况下降低资源成本。
提升产品易用性
ByteHouse 需要提供计算资源管理、数据资源管理、数据接入、数据应用的可视化管理功能,降低维护和应用成本,成为真正 SaaS 化的云原生数据仓库产品。
点击链接,立即下载完整版白皮书
https://www.wjx.cn/vm/Ot0YJFq.aspx#
点击跳转 火山引擎云原生数据仓库ByteHouse了解更多
火山引擎云原生数据仓库 ByteHouse 技术白皮书 V1.0(上)的更多相关文章
- OpenFlow技术白皮书-V1.0
1. 概述 OpenFlow是由斯坦福大学的Nick McKeown教授在2008年4月ACM Communications Review上发表的一篇论文OpenFlow: enabling inn ...
- 灵雀云CTO陈恺:从“鸿沟理论”看云原生,哪些技术能够跨越鸿沟?
灵雀云CTO陈恺:从“鸿沟理论”看云原生,哪些技术能够跨越鸿沟? 历史进入2019年,放眼望去,今天的整个技术大环境和生态都发生了很大的变化.在己亥猪年春节刚刚过去的早春时节,我们来梳理和展望一下整个 ...
- 混部之殇-论云原生资源隔离技术之CPU隔离(一)
作者 蒋彪,腾讯云高级工程师,10+年专注于操作系统相关技术,Linux内核资深发烧友.目前负责腾讯云原生OS的研发,以及OS/虚拟化的性能优化工作. 导语 混部,通常指在离线混部(也有离在线混部之说 ...
- [华三] IPv6技术白皮书(V1.00)
IPv6技术白皮书(V1.00) http://www.h3c.com/cn/d_200802/605649_30003_0.htm H3C S7500E IPv6技术白皮书 关键词:IPv6,隧道 ...
- waf 引擎 云原生平台tproxy 实现调研
了解了基本 云原生架构,不清楚的查看之前的文章:https://www.cnblogs.com/codestack/p/13914134.html 现在来看看云原生平台tproxy waf引擎串联实现 ...
- waf 引擎云原生调研---扫盲
概念: lstio Istio是一个用于服务治理的开放平台 Istio是一个Service Mesh形态的用于服务治理的开放平台 Istio是一个与Kubernetes紧密结合的适用于云原生场景的Se ...
- 火山引擎MARS-APM Plus x 飞书 |降低线上OOM,提高App性能稳定性
通过使用火山引擎MARS-APM Plus的memory graph功能,飞书研发团队有效分析定位问题线上case多达30例,线上OOM率降低到了0.8‰,降幅达到60%.大幅提升了用户体验,为飞书的 ...
- NodeJS 基于 Dapr 构建云原生微服务应用,从 0 到 1 快速上手指南
Dapr 是一个可移植的.事件驱动的运行时,它使任何开发人员能够轻松构建出弹性的.无状态和有状态的应用程序,并可运行在云平台或边缘计算中,它同时也支持多种编程语言和开发框架.Dapr 确保开发人员专注 ...
- 接口性能测试方案 白皮书 V1.0
一. 性能测试术语解释 1. 响应时间 响应时间即从应用系统发出请求开始,到客户端接收到最后一个字节数据为止所消耗的时间.响应时间按软件的特点再可以细分,如对于一个 C/S 软件的响应时间可以细分为网 ...
- 高性能、快响应!火山引擎 ByteHouse 物化视图功能及入门介绍
更多技术交流.求职机会,欢迎关注字节跳动数据平台微信公众号,回复[1]进入官方交流群 物化视图是指将视图的计算结果存储在数据库中的一种技术.当用户执行查询时,数据库会直接从已经预计算好的结果中获取数据 ...
随机推荐
- Web Woeker和Shared Worker的使用以及案例
目录 1.前言 2.介绍 Web Worker 3.使用须知及兼容性 3.1.使用须知 3.2.兼容性 4.使用 Web Worker 4.1.创建 Web Worker 4.2.与主线程通信 4.3 ...
- raspberry pi Pico使用MicroPython变砖后的解决方法
使用raspberry pi Pico的原因 在硬件产品(单片机)的开发中我们往往需要借助一些额外的仪器/设备进行产品的辅助测试, 假设我们需要一个IO+ADC类型辅助设备, 以往的做法是 原理图-& ...
- 一键整合,万用万灵,Python3.10项目嵌入式一键整合包的制作(Embed)
我们知道Python是一门解释型语言,项目运行时需要依赖Python解释器,并且有时候需要安装项目中对应的三方依赖库.对于专业的Python开发者来说,可以直接通过pip命令进行安装即可.但是如果是分 ...
- Modbus转PROFIBUS DP 通信网关-应用案例
针对西门子S7系列的PLC,通用串口/PROFIBUS-DP网关(PM-160)为建立西门子PLC与现场RS232/485设备的连接提供了理想解决方案
- 【uniapp】【外包杯】学习笔记day04 | 学习模板+vue相关知识+环境搭建
没啥好说的,人与人的悲欢并不相同,我只觉得吵闹. 好烦啊,虽然不应该总说一些低气压的话,不过目前预见的就是有很多工作要做,并且对于完成的希望也有点没有,就这样吧,没啥好说的. 昨天做了python的作 ...
- bi报表软件开发的特点什么,产品和流程?
BI报表软件是一种针对企业数据分析和决策支持的工具,具有高度灵活性和易用性.在当前数据化的时代,越来越多的企业开始关注BI报表软件的开发和应用,因为它们可以帮助企业更好地管理数据,更好地进行商业决策. ...
- Springboot整合shiro,带你学会shiro,入门级别教程,由浅入深,完整代码案例,各位项目想加这个模块的人也可以看这个,又或者不会mybatis-plus的也可以看这个
如果你对shiro有问题的话,请看这篇文章:Springboot+shiro,完整教程,带你学会shiro-CSDN博客 第一步,先准备数据库: 数据库需要准备三个表,一个user表,一个role表, ...
- 一款开源免费美观的WinForm UI控件库 - ReaLTaiizor
前言 今天推荐一款基于MIT license开源.免费.美观的.NET WinForm UI控件库:ReaLTaiizor. 什么是WinForm? WinForm是一个传统的桌面应用程序框架,它基于 ...
- vue3在父子组件使用v-model双向绑定
父组件: <script setup> import InputBox from "@/compon/InputBox.vue"; import {ref} from ...
- 【Python】【OpenCV】定位条形码(二)moments和HuMoments
根据上一篇博客可知,单纯的通过求取最大面积而进行定位的局限性,因此我们接下来将通过cv2.moments()和cv2.HuMoments()这两个方法来在更复杂的环境中去找到我们的目标区域. cv2. ...