
AWVS批量导入网站(刷漏洞入门)
今天整了一天这个AWVS批量扫描脚本,主要是下了好几个版本的AWVS,都不稳定,一次次删除又一次次安装。
做这件事儿目的就是为了批量刷漏洞,不过弄好之后又不打算刷漏洞了,不太喜欢无脑刷漏洞,没什么意义,并且现在水平也不是很高,先踏实学习吧。
这个文章目的就是记录一下整体的思路。
要想较为高效的刷漏洞(这里指的是和菜鸟相比),需要两步,一 : 获取大量的网页链接 ; 二 : 误报率低,比较牛逼一点的漏洞扫描工具
一 :获取大量的网页链接
这个有三种方法:
① fofa 这个有前提 ,必须得有 fofa 的VIP会员,直接下载工具 输入 账号 和 key 即可批量导,软件直接在 github 下载就行
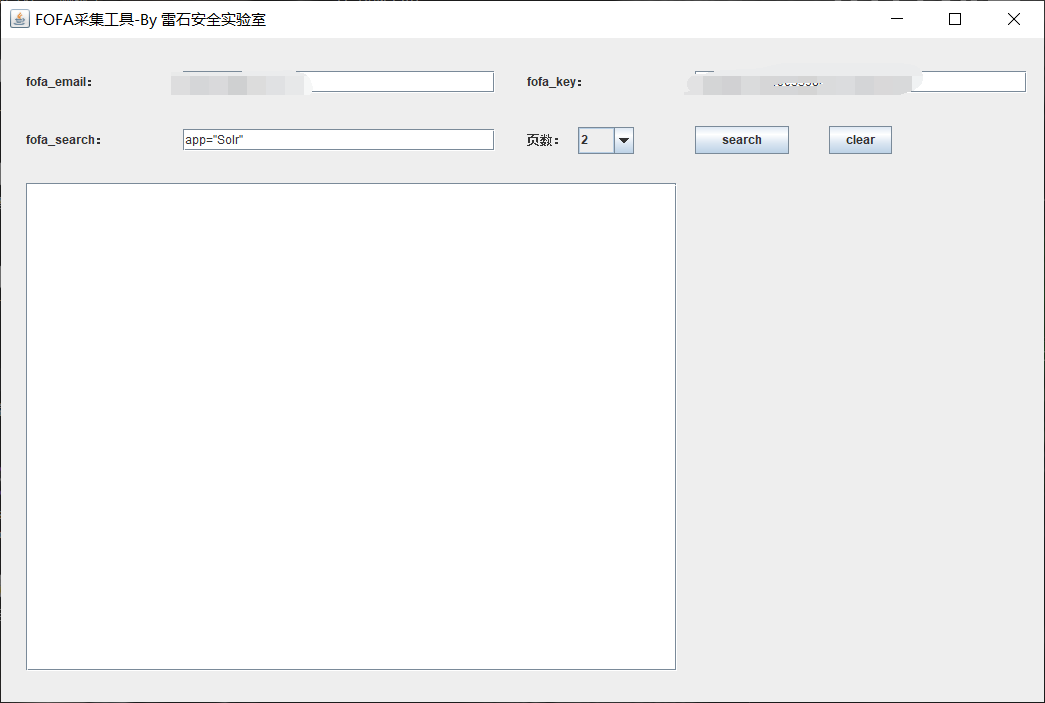
软件下载链接 : https://github.com/tangxiaofeng7/Fofa-collect/releases/tag/V1.0
② 利用crawlergo工具,
这个工具 功能就是能爬取 你导入好的txt文件中 每个链接中 源码的 链接
这个工具的原理就是爬虫,开启多个chrom一起爬,(这个chrom不是咱们用的那个谷歌浏览器,只是名字差不多)
这个工具如果和 xray 联动 ,那就比较完美 ,这个工具可以设置代理 ,流量先通过 xray 最后在放出去,实现了被动扫描。具体详情可以看 我写的文章 在分类中的 xray和crawlergo联动
https://github.com/0Kee-Team/crawlergo
这个是crawlergo在github中的下载链接,里面也有 crawlergo 使用说明
③ 这种方法就比较普通了,就是使用 layer 子域名挖掘机去一个个挖掘,不太推荐这种方法,layer扫出来的网站质量一般
二 : 选一款牛批的漏洞扫描工具
常见的漏洞扫描工具无非就是 AWVS ,appscan ,OWAsp ,xray 等等 ,因为以前用awvs感觉不错,所以这次也选的 awvs (没想到坑死我。。。)
网上许多的 awvs破解版都不太稳定,要不就是没 api,要不就是使会儿就不行了,现在是2020.7.24 实测下面这款比较不错,有需要的可以下载
https://www.sqlsec.com/2020/04/awvs.html
下载完了之后按照步骤破解安装就行
AWVS这里有个小缺点就是只支持批量导入 csv 文件,这就有点xx,几百上千个网站,我总不能一个个导入,于是就在网上找了半天批量导入的脚本,还好,试了几个之后就找到了个合适的,
直接把文章链接放出来 https://www.imzzj.com/2020/05/18/shi-yong-python-gei-awvs13-pi-liang-tian-jia-ren-wu.html 顺便感谢下博主,给了我很大帮助!!
这里需要提示一点的就是 使用 pycharm打开的时候,import 导入包儿那块儿会报一些错误,也没明白是啥情况,反正我给改对了,直接贴出来前部分的代码
import requests
import json
import  requests.packages
import  urllib3.packages
from urllib3.exceptions import InsecureRequestWarning
# from requests.packages.urllib3.exceptions import InsecureRequestWarning
# requests.packages.urllib3.disable_warnings(InsecureRequestWarning)
urllib3.disable_warnings(InsecureRequestWarning)

apikey = '1986ad8c0a5b3df4d7028dc51b15d120bf015197e'
# 去 AWVS 配置文件里面  有个 API KEY  复制填进去就行
apikey = str(apikey)
headers = {'Content-Type': 'application/json',"X-Auth": apikey}

def addTask(url,target):
    try:
        url = ''.join((url, '/api/v1/targets/add'))
        data = {"targets":[{"address": target,"description":""}],"groups":[]}
        r = requests.post(url, headers=headers, data=json.dumps(data), timeout=30, verify=False)
        result = json.loads(r.content.decode())
        return result['targets'][0]['target_id']
    except Exception as e:
        return e
def scan(url,target,Crawl,user_agent,profile_id,proxy_address,proxy_port):
    scanUrl = ''.join((url, '/api/v1/scans'))
    target_id = addTask(url,target)

    if target_id:
        data = {"target_id": target_id, "profile_id": profile_id, "incremental": False, "schedule": {"disable": False, "start_date": None, "time_sensitive": False}}
        try:
            configuration(url,target_id,proxy_address,proxy_port,Crawl,user_agent)
            response = requests.post(scanUrl, data=json.dumps(data), headers=headers, timeout=30, verify=False)
            result = json.loads(response.content)
            return result['target_id']
        except Exception as e:
            print(e)

def configuration(url,target_id,proxy_address,proxy_port,Crawl,user_agent):
    configuration_url = ''.join((url,'/api/v1/targets/{0}/configuration'.format(target_id)))
    data = {"scan_speed":"fast","login":{"kind":"none"},"ssh_credentials":{"kind":"none"},"sensor": False,"user_agent": user_agent,"case_sensitive":"auto","limit_crawler_scope": True,"excluded_paths":[],"authentication":{"enabled": False},"proxy":{"enabled": Crawl,"protocol":"http","address":proxy_address,"port":proxy_port},"technologies":[],"custom_headers":[],"custom_cookies":[],"debug":False,"client_certificate_password":"","issue_tracker_id":"","excluded_hours_id":""}
    r = requests.patch(url=configuration_url,data=json.dumps(data), headers=headers, timeout=30, verify=False)
def main():
    Crawl = False
    proxy_address = '127.0.0.1'
    proxy_port = '8888'
    awvs_url = 'https://127.0.0.1:3443' #awvs url
    with open('url.txt','r',encoding='utf-8') as f:
        targets = f.readlines()
    profile_id = "11111111-1111-1111-1111-111111111111"
    user_agent = "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.21 (KHTML, like Gecko) Chrome/41.0.2228.0 Safari/537.21" #扫描默认UA头
    if Crawl:
        profile_id = "11111111-1111-1111-1111-111111111117"
    for target in targets:
        target = target.strip()
        if scan(awvs_url,target,Crawl,user_agent,profile_id,proxy_address,int(proxy_port)):
            print("{0} 添加成功".format(target))

if __name__ == '__main__':
    main()
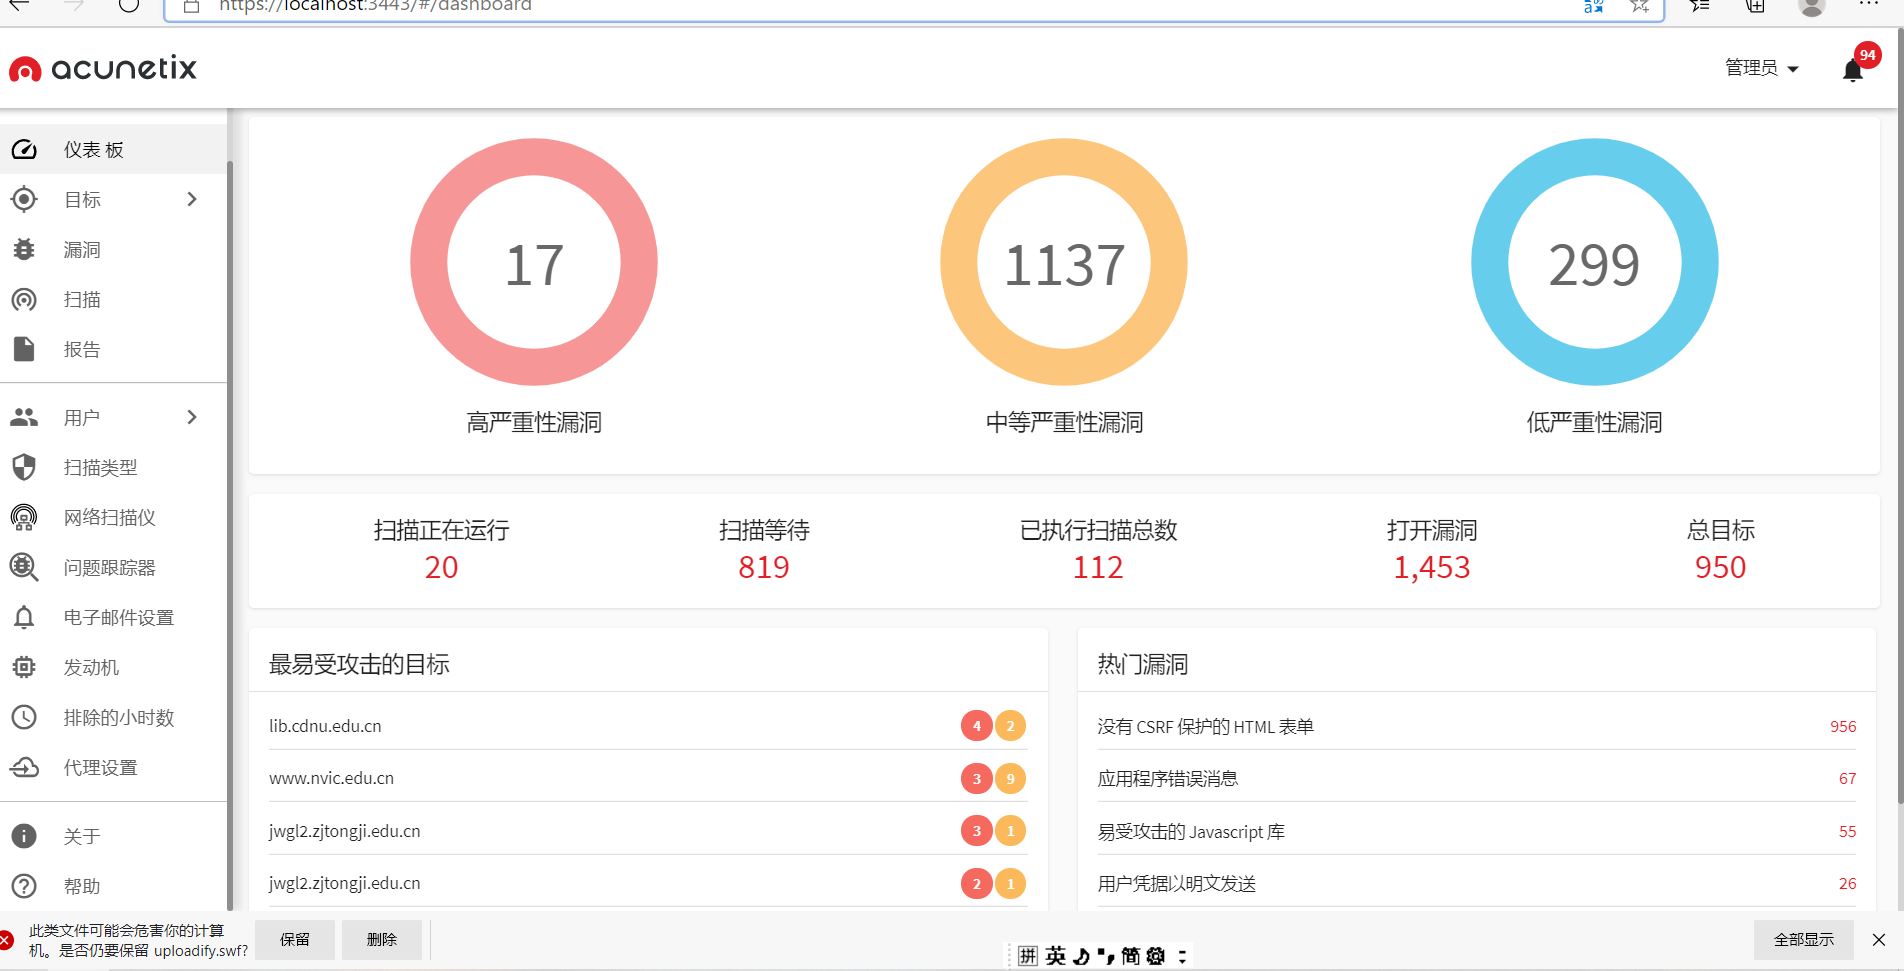
使用说明就是 先更改配置 ,添加api_key ; 把需要扫描的站点放在 url.txt 中 ; 运行awvs.py ; 显示 XXX 导入成功;打开awvs,可以看到站点添加成功,直接就开始自动扫描了
最后哔哔一句,不知道为啥,AWVS误报率有些高,没太仔细看,也没准是我的问题,等真正投入到挖漏洞的时候在研究吧。
最后推荐几篇文章:
https://zhuanlan.zhihu.com/p/108065469
AWVS批量导入网站(刷漏洞入门)的更多相关文章
- 各大漏洞平台及SRC的区别和如何批量刷漏洞
批量刷漏洞: 01刷指纹->02刷原始漏洞->03刷CMS->04刷指定政府.教育->05刷众测平台->06刷SRC->07刷国内外.活动 搜索引擎: 百度.goo ...
- 如何实现Magento产品批量导入?
从事外贸的我们在工作中,经常需要添加成千上万个的产品,如果一个一个的去上传,要花费很多时间,有是很让人头痛,那么应该如何实现产品批量上传?如果使用的是Magento系统的话,那么你现在有福利了,因为M ...
- Magento产品批量导入方法?
从事外贸的我们在工作中,经常需要添加成千上万个的产品,如果一个一个的去上传,要花费很多时间,有是很让人头痛,那么应该如何实现产品批量上传?如果使用的是Magento系统的话,那么你现在有福利了,因为M ...
- IIS6批量转移网站
IIS6.0有个导出配置的功能,但你却找不到界面上的直接导入配置功能,需要用到操作系统自带的iiscnfg.vbs脚本. 1.导出当前的IIS网站配置 打开Internet信息服务(IIS)---&g ...
- mysql中把一个表的数据批量导入另一个表中
mysql中把一个表的数据批量导入另一个表中 不管是在网站开发还是在应用程序开发中,我们经常会碰到需要将MySQL或MS SQLServer某个表的数据批量导入到另一个表的情况,甚至有时还需要指定 ...
- JAVA实现Excel批量导入
一.模板下载: 先将模板放在项目WebRoot下的download文件夹下: /** * @Title: downloadFile * @Description: 模板下载 (网络地址) * @par ...
- [原创] SiteServer 3.5 批量导入文章的SQL处理脚本
2005时做过一个小网站,当时是用ASP+Access做的,功能很简单,但里面的文章不少 现在就像把它转移到SS上来,重点就是如何导入文章 本来SS本身提供了批量导入功能,但对于在WEB上一次性导入一 ...
- mysql 如何提高批量导入的速度
mysql 如何提高批量导入的速度 最近一个项目测试,有几个mysql数据库的表数据记录达到了几十万条,在搭建测试环境 导入 测试数据时,十分慢.在网上搜索了一下,有下面一些方法可以加快mysql数据 ...
- 基于.NetCore开发博客项目 StarBlog - (4) markdown博客批量导入
系列文章 基于.NetCore开发博客项目 StarBlog - (1) 为什么需要自己写一个博客? 基于.NetCore开发博客项目 StarBlog - (2) 环境准备和创建项目 基于.NetC ...
随机推荐
- Camtasia绿幕素材的视频合成
随着科技和互联网的快速发展,让越来越多的人喜欢上了视频的各项制作,那么怎么让两个视频进行合成并一起播放呢?操作很简单,下面来讲解具体的操作步骤.小编选用的是Camtasia2019版本的视频编辑软件进 ...
- SQL server分页的四种方法(算很全面了)
这篇博客讲的是SQL server的分页方法,用的SQL server 2012版本.下面都用pageIndex表示页数,pageSize表示一页包含的记录.并且下面涉及到具体例子的,设定查询第2 ...
- 4 种高可用 RocketMQ 集群搭建方案!
背景 笔者所在的业务线,最初化分为三个服务,由于业务初期业务复杂度相对简单,三个业务服务都能很好的独立完成业务功能. 随着产品迭代,业务功能越来越多后慢慢也要面对高并发.业务解耦.分布式事务等问题,所 ...
- jvm系列(一)运行时数据区
C++程序员肩负着每一个对象生命周期开始到终结的维护责任.Java程序员则可以借助自动内存管理机制,不需要自己手动去释放内存.由虚拟机进行内存管理,不容易出现内存泄漏和内存溢出的问题,但是一旦出现这些 ...
- V-指令,细节补充
v-for遍历对象的时候 v-for=" (item) in person" 这里item是person对象里面的value值 而v-for=" (item,key) i ...
- Nebula Flink Connector 的原理和实践
摘要:本文所介绍 Nebula Graph 连接器 Nebula Flink Connector,采用类似 Flink 提供的 Flink Connector 形式,支持 Flink 读写分布式图数据 ...
- C++里面this关键字的用法和功能
1.this指针的用处 一个对象的this指针并不是对象本身的一部分,不会影响sizeof(对象)的结果.this作用域是在类内部,当在类的非静态成员函数中访问类的非静态成员的时候,编译器会自动将对象 ...
- 【Usaco 2009 Gold】JZOJ2020年9月19日提高B组T4 过路费
[Usaco 2009 Gold]JZOJ2020年9月19日提高B组T4 过路费 题目 Description 跟所有人一样,农夫约翰以着宁教我负天下牛,休叫天下牛负我的伟大精神,日日夜夜苦思生财之 ...
- moviepy执行TextClip.search方法时报错TypeError: a bytes-like object is required, not str
☞ ░ 前往老猿Python博文目录 ░ 执行TextClip.search方法时,报错: >>> from moviepy.editor import * >>> ...
- 第7.10节 Python类中的实例变量定义与使用
一. 引言 在前面章节已经引入介绍了类变量和实例变量,类体中定义的变量为类变量,默认属于类本身,实例变量是实例方法中定义的self对象的变量,对于每个实例都是独有数据,而类变量是该类所有实例共享 ...