
包-logging-hashlib-深浅拷贝
一、包:
包的本质就是一个模块
什么是包:它是一系列模块文件的结合体,表示形式就是一个文件夹,该文件夹内部通常会有一个__init__..py的文件
导入包的过程:先产生一个执行文件的名称空间
1:创建包下面的__init__.py文件的名称空间
2:执行包下面的__init__.py文件中的代码,将产生的名字放入下面的__init__.py文件的名称空间中
3:在执行文件中拿到一个指向包下面的__init__.py文件名称空间的名字
在导入的语句中.号的左边肯定是一个包(文件夹):from dir.dir1 import p 格式
需要强调的:
1、在Python3中,即使包下面没有__init__.py文件,import包也不会报错,而在Python2中一定要有__init__.py文件存在,不然会报错
2、创建包的目的不是为了运行,而是被导入使用,包只是模块的一种形式,包的本质就是一个模块
3、在删除程序不必要的文件时,务必记住不要删除带有__init__的文件,否则会导致文件或程序不能正常运行
二、为何要使用包
包的本质就是一个文件夹,那么文件夹唯一的功能就是将文件组织起来
随着功能越写越多,我们无法将所以功能都放到一个文件中,于是我们使用模块去组织功能,而随着模块越来越多,我们就需要用文件夹将模块文件组织起来,以此来提高程序的结构性和可维护性
三、包的相对路径导入和绝对路径导入:
1、站在包的开发者看,如果使用绝对路径来管理自己的模块,那么只需要永远以包的路径为基准依次导入模块
2、站在包的使用者看,必须到将包所在的那个文件夹路径添加到sys.path中(**)
四、包的使用之import和from import
1、单独导入包名称时不会导入包中所有包含的所有子模块
 import glance.db.models

 glance.db.models.register_models('mysql')
2、需要注意的是from后import导入的模块,必须是明确的一个不能带点,否则会有语法错误,如:from a import b.c是错误语法
 from glance.db import models

 models.register_models('mysql')
五、logging(日志模块):
import logging 日志的等级:critical(50级别) >error(40)>warning(30)>info(20)>debug(10)
longging.debug(debug日志')  # 调试

longging.info('info日志') #记录数据

longging.warning('warning日志‘)  # 警告

longging.error('日志’)   #  错误提示

logging.critical('critical日志') # 严重的
默认的日志格式为日志日志级别:loggermin名称:用户输出的消息。
重点掌握:1、logger对象:负责产生日志
2、filter对象:过滤日志
3、handler:控制日志输出的位置(文件/终端)切割
4、formmater 对象:规定日志内容的格式
logging.basicConfig()函数中可通过具体参数来更改logging模块默认行为,可用参数有:

filename:用指定的文件名创建FiledHandler,这样日志会被存储在指定的文件中。

filemode:文件打开方式,在指定了filename时使用这个参数,默认值为“a”还可指定为“w”。

format:指定handler使用的日志显示格式。

datefmt:指定日期时间格式。

level:设置rootlogger(后边会讲解具体概念)的日志级别

stream:用指定的stream创建StreamHandler。可以指定输出到sys.stderr,sys.stdout或者文件(f=open(‘test.log’,’w’)),默认为sys.stderr。若同时列出了filename和stream两个参数,则stream参数会被忽略。

format参数中可能用到的格式化串:

%(name)s Logger的名字

%(levelno)s 数字形式的日志级别

%(levelname)s 文本形式的日志级别

%(pathname)s 调用日志输出函数的模块的完整路径名,可能没有

%(filename)s 调用日志输出函数的模块的文件名

%(module)s 调用日志输出函数的模块名

%(funcName)s 调用日志输出函数的函数名

%(lineno)d 调用日志输出函数的语句所在的代码行

%(created)f 当前时间,用UNIX标准的表示时间的浮 点数表示

%(relativeCreated)d 输出日志信息时的,自Logger创建以 来的毫秒数

%(asctime)s 字符串形式的当前时间。默认格式是 “2003-07-08 16:49:45,896”。逗号后面的是毫秒

%(thread)d 线程ID。可能没有

%(threadName)s 线程名。可能没有

%(process)d 进程ID。可能没有

%(message)s用户输出的消息
logging对象配置:
import logging

logger = logging.getLogger()

# 创建一个handler,用于写入日志文件

fh = logging.FileHandler('test.log',encoding='utf-8')
 再创建一个handler,用于输出到控制台

ch = logging.StreamHandler()

formatter = logging.Formatter('%(asctime)s - %(name)s - %(levelname)s - %(message)s')

fh.setLevel(logging.DEBUG)

fh.setFormatter(formatter)

ch.setFormatter(formatter)

logger.addHandler(fh) #logger对象可以添加多个fh和ch对象

logger.addHandler(ch)
import logging.config 字典的配置(直接复制粘贴,修改即可)
定义三种日志输出格式 开始
standard_format = '[%(asctime)s][%(threadName)s:%(thread)d][task_id:%(name)s][%(filename)s:%(lineno)d]' \

                  '[%(levelname)s][%(message)s]' #其中name为getlogger指定的名字

simple_format = '[%(levelname)s][%(asctime)s][%(filename)s:%(lineno)d]%(message)s'
定义日志输出格式 结束
# 定义日志输出格式 结束

"""

下面的两个变量对应的值 需要你手动修改

"""

logfile_dir = os.path.dirname(__file__)  # log文件的目录

logfile_name = 'a3.log'  # log文件名

# 如果不存在定义的日志目录就创建一个

if not os.path.isdir(logfile_dir):

    os.mkdir(logfile_dir)

# log文件的全路径

logfile_path = os.path.join(logfile_dir, logfile_name)
logger与handler之间的控制关系
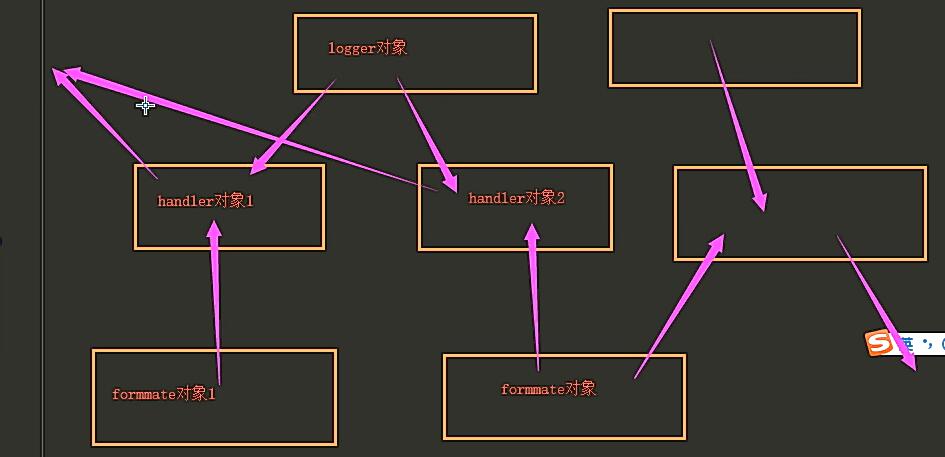
重点:
#1、logging.config.dictConfig(LOGGING_DIC) # 自动加载字典中的配置

#2、logger1=loggong.getlogger('come on')

#3、logger1.debug('革命尚未成功,任需努力')
logging日志在项目中的使用:
例子:比如在购物车中自动添加日志功能,让用户自定义生成日志记录
mport logging.config

from conf import settings  # 文件规范在文件中添加相应的功能模块

def get_logger(name):

        logging.config.dictConfig(settings.LOGGING_DIC) # 自动加载字典中的配置

        logger1=logging.getLogger(name)

        return logger1  #封装成函数调用  让用户输入
六、hashlib 加密模块
常用的有:MD5,SHA1系列等 两种加密方式 ,后面学有UUID唯一的。
MD5:摘要算法:又称哈希算法,通过一个函数,把任意长度的字符串转换成一个长度固定的数据串
关键字:pycharm里没有提示: update(往对象里传明文数据) hexdigest(获取明文数据对应的密文)
import hashlib

md=hashlib.md5()  # 生成一个帮你造密文的对象

md.update('come'.encode('utf-8'))

            # 往对象里传明文数据 update只能接受bytes类型的数据

md.update(b'come_on')

print(md.hexdigest())   # 获取明文数据对应的密文

结果:dd55e5aab7c4839be5932f399638ddb1

# encode('utf-8')等价于’b‘

md.update('come'.encode('utf-8'))

>>md.update(b'come')

这个加密的过程是无法解密的
撞库
"""

1.不同的算法 使用方法是相同的

密文的长度越长 内部对应的算法越复杂

但是

    1.时间消耗越长

    2.占用空间更大

通常情况下使用md5算法,就可以足够了

"""
2、import hashilb 传入的内容可以分多次传入,只要传入的内容相同,那么生成的密文肯定也相同。
import hashlib

md=hashlib.md5()

md.update('Hao aye you'.encode('utf-8'))

# md.update('Hao'.encode('utf-8'))

# md.update('are'.encode('utf-8'))

# md.update('you'.encode('utf-8'))

print(md.hexdigest())

>>684758727ad2809177ca0b08711580ba
3、hashilb 模块应用场景
1:密码的蜜文存储
2:校验文件内容是否一致
4、加盐处理
在传入密文前,将上自定义的密文。
 import hashlib

 md = hashlib.md5()

     公司自己在每一个需要加密的数据之前 先手动添加一些内容

 md.update(b'oldboy.com')  # 加盐处理

 md.update(b'hello')  # 真正的内容

 print(md.hexdigest())

不影响结果,只是让加密更严谨一些
5、动态加盐
获取用户的输入生成密文,在获取用户输入时加入随机的字符串。
import hashlib

def get_md5(data):

    md = hashlib.md5()

    md.update('加盐'.encode('utf-8'))

    md.update(data.encode('utf-8'))

    return md.hexdigest()

password = input('password>>>:')

res = get_md5(password)

print(res)

>>>password>>>:123 #输入 密码后生成密文

f9eddd2f29dcb3136df2318b2b2c64d3
七、openpyxl
比较火的操作Excel表格的模块 第三方模块需下载安装才能使用
 # 03版本之前的Excel文件的后缀名叫 xls

 # 03版本之后的Excel文件的后缀名叫  xlsx
1、之前的模块:xlwd 写excel xlrt 读Excel 同样也可以操作Excel的模块,支持03版本之前的Excel文件也支持03版本之后的文件处理,openpyxl 是后面产生的,仅支持03版本后的xlsx
2、模块功能的使用
(1)写操作
from openpyxl import Workbook

wb=Workbook()  # 先生成一个工作簿

wb1=wb.create_sheet('最喜欢的歌曲',0) #创建一个表单页,可以通过索引来确定位置

we2=wb.create_sheet('喜欢的明星')

we3=wb.create_sheet('喜欢的')

wb1.title='调查'

wb1['A3']=('陈奕迅'.encode('utf-8'))

wb1.append([b'歌曲名'],'热度'.encode('utf-8')) #往列表里添加内容

wb1.append([b'不说再见'],'top3')

wb.save('test.xlsx')  # 保存创建的文件
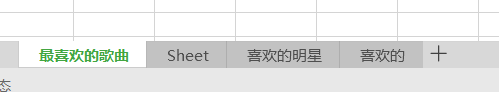
(2)、读操作:可以锁定想要读取的内容
from openpyxl import load_workbook

wb=load_workbook(('test.xlsx'),read_only=True,data_only=True)

print(wb['最喜欢的歌曲']['A3'].value)
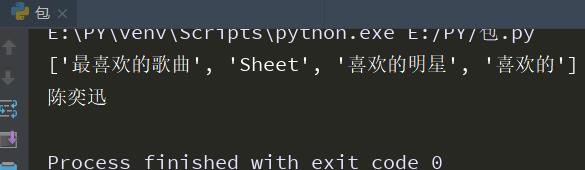
八、深浅拷贝
拷贝就是拷贝,何来深浅之说?
Python中,对象的赋值,拷贝(深/浅拷贝)之间是有差异的,如果使用的时候不注意,就可能产生意外的结果
其实这个是由于共享内存导致的结果
拷贝:原则上就是把数据分离出来,复制其数据,并以后修改互不影响。
先举个非拷贝的例子:
"""

 =赋值:数据完全共享(=赋值是在内存中指向同一个对象,如果是可变(mutable)类型,比如列表,修改其中一个,另一个必定改变

如果是不可变类型(immutable),比如字符串,修改了其中一个,另一个并不会变

)"""
l1 = [1, 2, 3, ['aa', 'bb']]

l2 = l1

l2[0]='aaa'

l2[3][0]='bbb'

print(l1)  #['aaa', 2, 3, ['bbb', 'bb']]

print(id(l1)==id(l2))  #True
结果
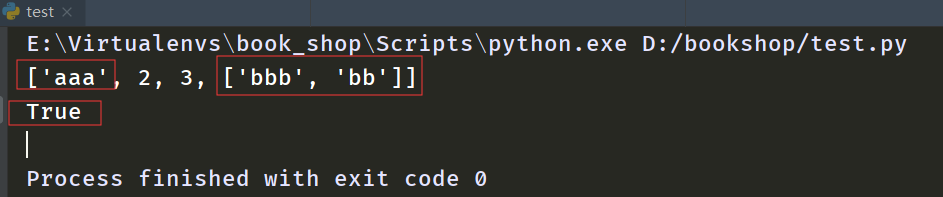
分析:l2 = l1 ,l1 完全赋值给l2 ,l2的内存地址与l1 相同,即内存完全指向
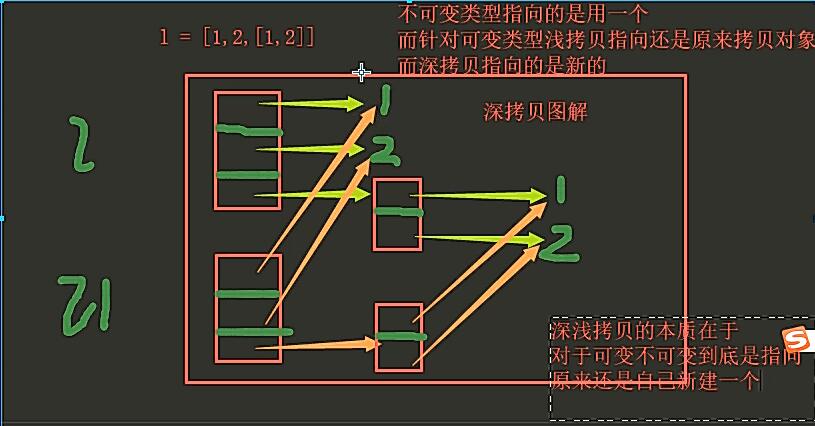
两者之间的区别主要当拷贝是可变类型时,浅拷贝指向的还是原来的,而深拷贝指向的是其他的内存地址。
概念:
浅拷贝:只是拷贝最外层,里面的内容没有完全复制,也可以指向其他的内存空间
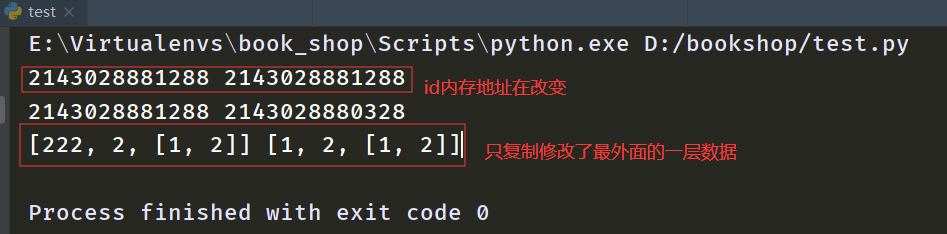
浅拷贝:数据半共享(复制其数据独立内存存放,但是只拷贝成功第一层)
import copy

l1 = [1,2,[1,2]]
l2 = l1
print(id(l1),id(l2))
l2 = copy.copy(l1)  # 拷贝一份 .......  浅拷贝
print(id(l1),id(l2))
l1[0] = 222  #修改了l1的值
print(l1,l2)
j结果:

>>  1975941374408 1975941374408
1975941374408 1975941510664
[222, 2, [1, 2]] [1, 2, [1, 2]]  值一样拷贝完ID也在变化,往里面添加值后,只改变其中一个
深拷贝:数据完全不共享(复制其数据完完全全放独立的一个内存,完全拷贝,数据不共享
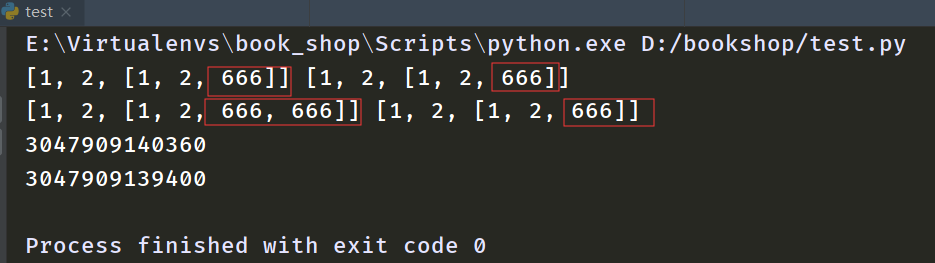
import copy,deepcopy
l1 = [1,2,[1,2]]

l1=l2

l1[2].append(666)

print(l1,l2)

l2 = copy.deepcopy(l)

l1[2].append(666)

print(l1,l2)
print(id(l1))
print(id(l))
常考面试题:
包-logging-hashlib-深浅拷贝的更多相关文章
- python包-logging-hashlib-openpyxl模块-深浅拷贝-04
包 包: # 包是一系列模块文件的结合体,表现形式是文件夹,该文件夹内部通常会包含一个__init__.py文件,本质上还是一个模块 包呢,就是前两篇博客中提到的,模块的四种表现形式中的第三种 # 把 ...
- python基础--包、logging、hashlib、openpyxl、深浅拷贝
包:它是一系列模块文件的结合体,表现形式就是一个文件夹,该文件夹内部通常会有一个__init__.py文件,包的本质还是一个模块. 首次导入包:(在导入语句中中 . 号的左边肯定是一个包(文件夹)) ...
- 包、logging模块、hashlib模块、openpyxl模块、深浅拷贝
包.logging模块.hashlib模块.openpyxl模块.深浅拷贝 一.包 1.模块与包 模块的三种来源: 1.内置的 2.第三方的 3.自定义的 模块的四种表现形式: 1.py文件 2.共享 ...
- day17_7.19包与logging模块,深浅拷贝
一.包 在模块的定义里,模块就是方法的集合,可以将一些常用的方法封装到一个py文件中,通过调用使用,而且,其中的表现形式也有以包的形式导入. 其实,包就是一系列模块的结合体,表示形式就是一个文件夹,在 ...
- python掉包侠与深浅拷贝
今日所得 包 logging模块 hashlib模块 openpyxl模块 深浅拷贝 包 在学习模块的时候我们了解过模块的四种表现形式,其中的一种就是包. 什么是包? 它是一系列模块文件的结合体,表示 ...
- 人生苦短之我用Python篇(深浅拷贝、常用模块、内置函数)
深浅拷贝 有时候,尤其是当你在处理可变对象时,你可能想要复制一个对象,然后对其做出一些改变而不希望影响原来的对象.这就是Python的copy所发挥作用的地方. 定义了当对你的类的实例调用copy.c ...
- day2学python 数据类型+深浅拷贝+循环
数据类型+深浅拷贝+循环 别的语言的数组 python不用定义 直接使用 color=['红','橙','黄','绿','青','蓝','紫'] print(color[1:3]) //打印[1,3) ...
- 深浅拷贝、集合set、函数、日志
#-----深浅拷贝---- import copy a = ["xiaoming",111,[5000,2000]] b = a print("b:%s" % ...
- Python 从零学起(纯基础) 笔记 之 深浅拷贝
深浅拷贝 1. import copy#浅拷贝copy.copy()#深拷贝copy.deepcopy()#赋值 = 2. 对于数字和字符串而言,赋值.浅拷贝和深拷贝无意义,因为其永远指向同一个 ...
- python——赋值与深浅拷贝
初学编程的小伙伴都会对于深浅拷贝的用法有些疑问,今天我们就结合python变量存储的特性从内存的角度来谈一谈赋值和深浅拷贝~~~ 预备知识一——python的变量及其存储 在详细的了解python中赋 ...
随机推荐
- 吴裕雄--天生自然JAVA SPRING框架开发学习笔记:Spring DI(依赖注入)的实现方式属性注入和构造注入
依赖注入(Dependency Injection,DI)和控制反转含义相同,它们是从两个角度描述的同一个概念. 当某个 Java 实例需要另一个 Java 实例时,传统的方法是由调用者创建被调用者的 ...
- 201771010123汪慧和《面向对象程序设计Java》第十六周实验总结
一.理论部分 1.程序与进程的概念 ‐程序是一段静态的代码,它是应用程序执行的蓝本. ‐进程是程序的一次动态执行,它对应了从代码加载.执行至执行完毕的一个完整过程. ‐操作系统为每个进程分配一段独立的 ...
- ES6的一些语法
let, const, class, extends, super, arrow functions, template string, destructuring, default, rest ar ...
- POJ - 1631 Bridging signals(最长上升子序列---LIS)
题意:左右各n个端口,已知n组线路,要求切除最少的线路,使剩下的线路各不相交,按照左端口递增的顺序输入. 分析: 1.设左端口为l,右端口为r,因为左端口递增输入,l[i] < l[j](i & ...
- Python String startswith() Method
一,摘自官方API https://docs.python.org/3/library/stdtypes.html#methods str.startswith(prefix[, start[, e ...
- Navicat for Mysql 11.2 的下载,安装与激活
1. Navicat for Mysql 11.2 的下载 链接:https://pan.baidu.com/s/1w54F-MYTLuy4TQwpzUE7bQ 密码:zsfu 2.下载的 ...
- CocoaPods为多个target添加依赖库/Podfile的配置
Podfile的相关配置,请看官方文档http://guides.cocoapods.org/syntax/podfile.html 1)多个target公用相同库,还可以添加额外的不同第三方库 编辑 ...
- kafka 零拷贝
kafka通过零拷贝实现高效的数据传输 https://blog.csdn.net/lxlmycsdnfree/article/details/78973864 Kafka零拷贝 https://bl ...
- 吴裕雄--天生自然C++语言学习笔记:C++简介
C++ 是一种中级语言,它是由 Bjarne Stroustrup 于 年在贝尔实验室开始设计开发的.C++ 进一步扩充和完善了 C 语言,是一种面向对象的程序设计语言.C++ 可运行于多种平台上,如 ...
- count(1),count(*)和count(列)的比较
转自:https://www.cnblogs.com/Caucasian/p/7041061.html 1.关于count(1),count(*),和count(列名)的区别 相信大家总是在工作中,或 ...