
pandas分组运算(groupby)
1. groupby()
import pandas as pd

df = pd.DataFrame([[1, 1, 2], [1, 2, 3], [2, 3, 4]], columns=["A", "B", "C"])

print(df)

g = df.groupby('A').mean()   # 按A列分组(groupby),获取其他列的均值

print(g)

# 方法1

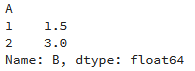
b = df['B'].groupby(df['A']).mean()    # 按A列分组,获取B列的均值

print(b)

# 方法2

b = df.ix[:,1].groupby(df.ix[:, 0]).mean()    # 按A列分组(0对应A列,1对应B列),获取B列的均值

print(b)

# 方法3

m = df.groupby('A')

b = m['B'].mean()

print(b)
2. 聚合方法size()和count()
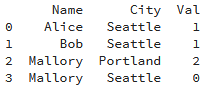
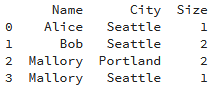
size跟count的区别: size计数时包含NaN值,而count不包含NaN值
import pandas as pd

import numpy as np

df = pd.DataFrame({"Name":["Alice", "Bob", "Mallory", "Mallory", "Bob" , "Mallory"],

                   "City":["Seattle", "Seattle", "Portland", "Seattle", "Seattle", "Portland"],

                   "Val":[4,3,3,np.nan,np.nan,4]})

print(df)
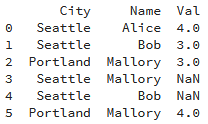
count()
a = df.groupby(["Name", "City"], as_index=False)['Val'].count()

print(a)
size()
b = df.groupby(["Name", "City"])['Val'].size().reset_index(name='Size')

print(b)
来自:https://blog.csdn.net/m0_37870649/article/details/80979809
pandas分组运算(groupby)的更多相关文章
- pandas聚合和分组运算——GroupBy技术(1)
数据聚合与分组运算——GroupBy技术(1),有需要的朋友可以参考下. pandas提供了一个灵活高效的groupby功能,它使你能以一种自然的方式对数据集进行切片.切块.摘要等操作.根据一个或多个 ...
- Pandas分组运算(groupby)修炼
Pandas分组运算(groupby)修炼 Pandas的groupby()功能很强大,用好了可以方便的解决很多问题,在数据处理以及日常工作中经常能施展拳脚. 今天,我们一起来领略下groupby() ...
- Pandas分组(GroupBy)
任何分组(groupby)操作都涉及原始对象的以下操作之一.它们是 - 分割对象 应用一个函数 结合的结果 在许多情况下,我们将数据分成多个集合,并在每个子集上应用一些函数.在应用函数中,可以执行以下 ...
- pandas学习(数据分组与分组运算、离散化处理、数据合并)
pandas学习(数据分组与分组运算.离散化处理.数据合并) 目录 数据分组与分组运算 离散化处理 数据合并 数据分组与分组运算 GroupBy技术:实现数据的分组,和分组运算,作用类似于数据透视表 ...
- 【学习】数据聚合和分组运算【groupby】
分组键可以有多种方式,且类型不必相同 列表或数组, 某长度与待分组的轴一样 表示DataFrame某个列名的值 字典或Series,给出待分组轴上的值与分组名之间的对应关系 函数用于处理轴索引或索引中 ...
- Python数据聚合和分组运算(1)-GroupBy Mechanics
前言 Python的pandas包提供的数据聚合与分组运算功能很强大,也很灵活.<Python for Data Analysis>这本书第9章详细的介绍了这方面的用法,但是有些细节不常用 ...
- python库学习笔记——分组计算利器:pandas中的groupby技术
最近处理数据需要分组计算,又用到了groupby函数,温故而知新. 分组运算的第一阶段,pandas 对象(无论是 Series.DataFrame 还是其他的)中的数据会根据你所提供的一个或多个键被 ...
- 利用Python进行数据分析-Pandas(第六部分-数据聚合与分组运算)
对数据集进行分组并对各组应用一个函数(无论是聚合还是转换),通常是数据分析工作中的重要环节.在将数据集加载.融合.准备好之后,通常是计算分组统计或生成透视表.pandas提供了一个灵活高效的group ...
- python中pandas数据分析基础3(数据索引、数据分组与分组运算、数据离散化、数据合并)
//2019.07.19/20 python中pandas数据分析基础(数据重塑与轴向转化.数据分组与分组运算.离散化处理.多数据文件合并操作) 3.1 数据重塑与轴向转换1.层次化索引使得一个轴上拥 ...
随机推荐
- mysql explain解析一 extra中的using index,using where,using index condition
1.简单介绍 using index 和using where只要使用了索引我们基本都能经常看到,而using index condition则是在mysql5.6后新加的新特性,我们先来看看mysq ...
- 1、linux基础优化
1.添加一个用户 [root@oldboy ~]# useradd oldboy [root@oldboy ~]# id oldboy uid=500(oldboy) gid=500 (oldboy) ...
- linux服务器硬件信息查看
1.linux 查看服务器序列号(S/N) [root@oss20hb106 ~]# dmidecode -t 1 # dmidecode 2.11 # SMBIOS entry point at 0 ...
- java8学习之收集器用法详解与多级分组和分区
收集器用法详解: 在上次已经系统的阅读了Collector收集器的Javadoc对它已经有一个比较详细的认知了,但是!!!它毕境是只是一个接口,要使用的话还得用它的实现类,所以在Java8中有它进行了 ...
- 双向BFS统计
Hdu1195 两个四位密码 问你最少多少步能到达 /*Huyyt*/ #include<bits/stdc++.h> #define mem(a,b) memset(a,b,sizeof ...
- 获取页面url信息
方法: window.location.href = prefixURL+'webstatic/messageAnalysis/datadetail.html?id=' + num + "& ...
- Spring mvc i18n国际化的简单demo
在渲染视图的xml文件中,配置一个i18nBean 实现两个接口: SessionLocaleResolver --> 加载资源主题 ReloadableResourceBundleMessag ...
- electron-vue 引入 vue.ant.design报错
ERROR in ./node_modules/ant-design-vue/dist/antd.less (./node_modules/css-loader!./node_modules/less ...
- Java-Shiro(五):Shiro Realm讲解(二)IniRealm的用法、JdbcRelam的用法、自定义Realm
引入 上一篇在讲解Realm简介时,介绍过Realm包含大概4类缺省的Realm,本章主要讲解: 1)IniRealm的用法: 2)JdbcRealm基于mysql 默认表及查询语句实现认证.授权 ...
- 闰年计算——JavaScript 语言计算
㈠闰年是如何来的? 闰年(Leap Year)是为了弥补因人为历法规定造成的年度天数与地球实际公转周期的时间差而设立的.补上时间差的年份为闰年. ㈡什么是闰年? 凡阳历中有闰日(二月为二十九日)的年, ...