
python之----------字符编码的原理
1.内存和硬盘都是用来存储的。
CPU:速度快
硬盘:永久保存

2.文本编辑器存取文件的原理(nodepad++,pycharm,word)
打开编辑器就可以启动一个进程,是在内存中的,所以在编辑器编写的内容也都是存放在内存中的,断电后数据就丢失了。因而需要保存在硬盘上,点击保存按钮或快捷键,就把内存中的数据保存到了硬盘上。在这一点上,我们编写的py文件(没有执行时),跟编写的其他文件没有什么区别,都只是编写一堆字符而已。
3.python解释器执行py文件的原理,例如python test.py
第一阶段:python解释器启动,此时就相当于启动了一个文本编辑器
第二阶段:python解释器相当于文本编辑器,去打开test.py,从硬盘上将test.py的文件内容读入到内存中
第三阶段:python解释器执行刚刚加载到内存中的test.py的代码(在该阶段,即执行时,才会识别python的语法,执行到字符串时,会开辟内存空间存放字符串)
总结:python解释器与文本编辑器的异同
相同点:python解释器是解释执行文件内容的,因而python解释器具备读py文件的功能,这一点与文本编辑器一样
不同点:文本编辑器将文件内容读入内存后,是为了显示/编辑,而python解释器将文件内容读入内存后,是为了执行(识别python的语法)
4.什么是编码?
计算机想要工作必须通电,高低电平(高电平即二进制数1,低电平即二进制数0),也就是说计算机只认识数字。那么让计算机如何读懂人类的字符呢?
这就必须经过一个过程:
字符---------(翻译过程)-------------数字
这个过程实际就是一个字符如何对应一个特定数字的标准,这个标准称之为字符编码。
5.以下两个场景涉及到字符编码的问题:
1.一个python文件中的内容是由一堆字符组成的(python文件未执行时)
2.python中的数据类型字符串是由一串字符组成的(python文件执行时)
6.字符编码的发展史
阶段一:现代计算机起源于美国,最早诞生也是基于英文考虑的ASCII
ASCII:一个Bytes代表一个字符(英文字符/键盘上的所有其他字符),1Bytes=8bit,8bit可以表示0-2**8-1种变化,即可以表示256个字符
ASCII最初只用了后七位,127个数字,已经完全能够代表键盘上所有的字符了(英文字符/键盘的所有其他字符)
后来为了将拉丁文也编码进了ASCII表,将最高位也占用了
阶段二:为了满足中文,中国人定制了GBK
GBK:2Bytes代表一个字符,为了满足其他国家,各个国家纷纷定制了自己的编码,日本把日文编到Shift_JIS里,韩国把韩文编到Euc-kr里
阶段三:各国有各国的标准,就会不可避免地出现冲突,结果就是,在多语言混合的文本中,显示出来会有乱码。
于是产生了unicode, 统一用2Bytes代表一个字符, 2**16-1=65535,可代表6万多个字符,因而兼容万国语言
但对于通篇都是英文的文本来说,这种编码方式无疑是多了一倍的存储空间(二进制最终都是以电或者磁的方式存储到存储介质中的)
于是产生了UTF-8,对英文字符只用1Bytes表示,对中文字符用3Bytes
需要强调的是:
unicode:简单粗暴,多有的字符都是2Bytes,优点是字符--数字的转换速度快;缺点是占用空间大。
utf-8:精准,可变长,优点是节省空间;缺点是转换速度慢,因为每次转换都需要计算出需要多长Bytes才能够准确表示。
1.内存中使用的编码是unicode,用空间换时间(程序都需要加载到内存才能运行,因而内存应该是越快越好)
2.硬盘中或网络传输用utf-8,保证数据传输的稳定性。
七、字符编码转换
unicode------>encode(编码)-------->utf-8
utf-8---------->decode--------->unicode
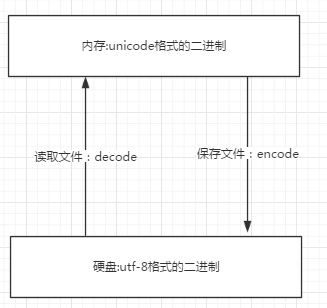
文件从内存刷到硬盘的操作简称存文件
文件从硬盘读到内存的操作简称读文件
乱码:存文件时就已经乱码 或者 存文件时不乱码而读文件时乱码
总结:
无论是何种编辑器,要防止文件出现乱码(请一定注意,存放一段代码的文件也仅仅只是一个普通文件而已,此处指的是文件没有执行前,我们打开文件时出现的乱码)
核心法则就是,文件以什么编码保存的,就以什么编码方式打开
八、 文本编辑器之python解释器
文件test.py以gbk格式保存,内容为:
x='林'
无论是
python2 test.py
还是
python3 test.py
都会报错(因为python2默认ascii,python3默认utf-8)
除非在文件开头指定#coding:gbk
九、程序的执行
python3 test.py 或 python2 test.py(执行test.py的第一步,一定是先将文件内容读入到内存中)
阶段一:启动python解释器
阶段二:python解释器此时就是一个文本编辑器,负责打开文件test.py,即从硬盘中读取test.py的内容到内存中
此时,python解释器会读取test.py 的第一行内容,#coding :utf-8,来决定以什么编码格式来读入内存,这一行就是来设定python解释器这个软件的编码使用的编码格式这个编码,python2默认使用ASCII,python3中默认使用utf-8
阶段三:读取已经加载到内存的代码(unicode编码的二进制),然后执行,执行过程中可能会开辟新的内存空间,比如x="egon"
内存的编码使用unicode,不代表内存中全都是unicode编码的二进制,
在程序执行之前,内存中确实都是unicode编码的二进制,比如从文件中读取了一行x="egon",其中的x,等号,引号,地位都一样,都是普通字符而已,都是以unicode编码的二进制形式存放与内存中的
但是程序在执行过程中,会申请内存(与程序代码所存在的内存是俩个空间),可以存放任意编码格式的数据,比如x="egon",会被python解释器识别为字符串,会申请内存空间来存放"hello",然后让x指向该内存地址,此时新申请的该内存地址保存也是unicode编码的egon,如果代码换成x="egon".encode('utf-8'),那么新申请的内存空间里存放的就是utf-8编码的字符串egon了
十、python2与python3的区别
在python2中有两种字符串类型str和unicode
在python2中,str就是编码后的结果bytes,所以在Python2中,unicode字符编码的结果就是str/bytes
python之----------字符编码的原理的更多相关文章
- python之----------字符编码具体原理
1.内存和硬盘都是用来存储的. CPU:速度快 硬盘:永久保存 2.文本编辑器存取文件的原理(nodepad++,pycharm,word) 打开编辑器就可以启动一个进程,是在内存中的,所以在编辑器编 ...
- Python基础-字符编码与转码
***了解计算机的底层原理*** Python全栈开发之Python基础-字符编码与转码 需知: 1.在python2默认编码是ASCII, python3里默认是utf-8 2.unicode 分为 ...
- Python的字符编码
Python的字符编码 1. Python字符编码简介 1. 1 ASCII Python解释器在加载.py文件的代码时,会对内容进行编码,一般默认为ASCII码.ASCII(American St ...
- Python常用字符编码(转)
Python常用字符编码 字符编码的常用种类介绍 第一种:ASCII码 ASCII(American Standard Code for Information Interchange,美国信息交 ...
- Python常见字符编码间的转换
主要内容: 1.Unicode 和 UTF-8的爱恨纠葛 2.字符在硬盘上的存储 3.编码的转换 4.验证编码是否转换正确 5.Python bytes类型 前 ...
- python 3字符编码
python 3字符编码 官方链接:http://legacy.python.org/dev/peps/pep-0263/ 在Python2中默认是ascii编码,Python3是utf-8编码 在p ...
- Python 的字符编码
配置: Python 2.7 + Sublime Text 2 + OS X 10.10 本文意在理清各种编码的关系并以此解决 Python 中的编码问题. 1 编码基本概念 只有先了解字符表.编码字 ...
- 转:Python常见字符编码及其之间的转换
参考:Python常见字符编码 + Python常见字符编码间的转换 一.Python常见字符编码 字符编码的常用种类介绍 第一种:ASCII码 ASCII(American Standard Cod ...
- Python遇到字符编码出问题的一个相对万能的办法
在使用Python做爬虫的过程中,经常遇到字符编码出问题的情况. UnicodeEncodeError: 'ascii' codec can't encode character u'\u6211' ...
随机推荐
- HTML创建链接框
使用CSS样式创建一个漂亮的链接框吧 <!DOCTYPE html> <html> <head> <style> a:link,a:visited { ...
- [好好学习]在VMware中安装Oracle Enterprise Linux (v5.7) - (2/5)
- Opencv中KNN背景分割器
背景分割器BackgroundSubtractor是专门用来视频分析的,会对视频中的每一帧进行"学习",比较,计算阴影,排除检测图像的阴影区域,按照时间推移的方法提高运动分析的结果 ...
- nodejs 模板引擎
自制替换模板 template.js var fs = require('fs') var http = require('http') var server = http.createServer( ...
- TS中补充的六个类型
1. 元组 元组可以看做是数组的拓展,它表示已知元素数量和类型的数组.确切地说,是已知数组中每一个位置上的元素的类型 当我们为 元组 赋值时:各个位置上的元素类型都要对应,元素个数也要一致. let ...
- 函数柯里化(Currying)小实践
什么是函数柯里化 在计算机科学中,柯里化(Currying)是把接受多个参数的函数变换成接受一个单一参数(最初函数的第一个参数)的函数,并且返回接受余下的参数且返回结果的新函数的技术.这个技术由 Ch ...
- CF1090J Two Prefixes
神仙题++ 还是在某校梁大讲的题qaq 我们考虑容斥 也就是本质不同字串=全部-重复的 我们只需要求重复的即可 考虑相同的s=ab 我们用长度最长的a作为代表串 如果存在一个a'b'且|a'|> ...
- SSM三大框架整合梳理
整合步骤 0.搭建动态web项目 1.需要的jar包 spring(包括springmvc) mybatis相关jar包 mybatis与spring的整合包(个人建议尽量使用高版本的,避免出现一些奇 ...
- Java常用类库API之数字处理工具类
数字处理工具类BigDecimal和DecimalFormat Java提供的java.text.DecimalFormat类,帮助我们用最快的速度将数据格式化为我们想要的样子.例如,取两位小数 im ...
- java基础复习(四)
---恢复内容开始--- 一.for循环的掌握 语法格式: for( 初始化语句A ; 条件判断B ; 循环后功能语句C){ //循环体D } for的执行流程: 整个for循环结构中 ...