
Task4.文本表示:从one-hot到word2vec
参考:https://blog.csdn.net/wxyangid/article/details/80209156
1.one-hot编码
中文名叫独热编码、一位有效编码。方法是使用N位状态寄存器来对N个状态进行编码,每个状态都有其独立的寄存器位,并且任意时刻,有且仅有一个状态位是有效的。比如,手写数字识别,数字为0-9共10个,那么每个数字的one-hot编码为10位,数字i的第i位为1,其余为0,如数字2的one-hot表示为:[0,0,1,0,0,0,0,0,0,0]。
1.2one-hot在提取文本特征上的应用
one-hot在特征提取上属于词袋模型(bags of words)
假设语料库有这么三段话:
我爱中国
爸爸妈妈爱我
爸爸妈妈爱中国
对语料库分词并进行编号
1我;2爱;3爸爸;4妈妈;5中国
对每段话用onehot提取特征向量
则三段话由onehot表示为:
我爱中国 -> 1,1,0,0,1
爸爸妈妈爱我 ->1,1,1,1,0
爸爸妈妈爱中国 ->0,1,1,1,1
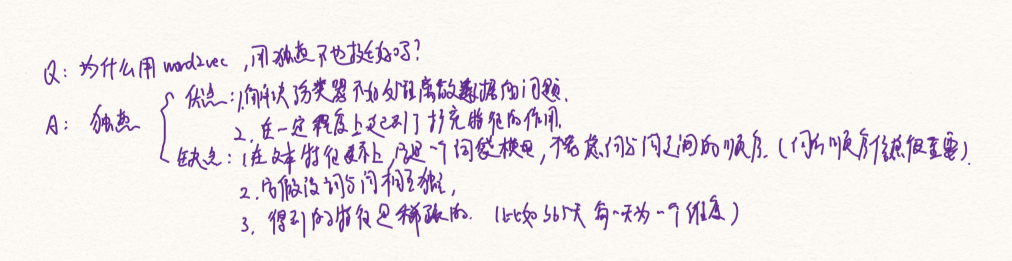
优点:可以将数据用onehot进行离散化,在一定程度上起到了扩充特征的作用
缺点:没有考虑词与词之间的顺序,并且假设词与词之间相互独立,得到的特征是离散稀疏的(如果365天用onehot,就是365维,会很稀疏)
在实际的机器学习的应用任务中,特征有时候并不总是连续值,有可能是一些分类值,如性别可分为“male”和“female”。在机器学习任务中,对于这样的特征,通常我们需要对其进行特征数字化,如下面的例子:
有如下三个特征属性:
性别:["male","female"] # 所有可能取值,0,1 两种情况
地区:["Europe","US","Asia"] #0,1,2 三种情况
浏览器:["Firefox","Chrome","Safari","Internet Explorer"] #0,1,2,3四种情况
所以样本的第一维只能是0或者1,第二维是0,1,2三种情况中的一种,第三维,是0,1,2,3四种情况中的一种。
对于某一个样本,如["male","US","Internet Explorer"],我们需要将这个分类值的特征数字化,最直接的方法,我们可以采用序列化的方式:[0,1,3]。但是这样的特征处理并不能直接放入机器学习算法中。
对上述问题,我们发现性别2维,地区3维,浏览器4维则我们进行onehot编码需要9维。对["male","US","Internet Explorer"]进行onehot编码为:[1,0,0,1,0,0,0,0,1]
下面看如何用代码实现:
 from sklearn import preprocessing

 oh = preprocessing.OneHotEncoder()

 oh.fit([[0,0,3],[1,1,0],[0,2,1],[1,0,2]])#四个样本

 oh.transform([[0,1,3]]).toarray()
结果:[[ 1. 0. 0. 1. 0. 0. 0. 0. 1.]]
[0,0,3] #表示是该样本是,male Europe Internet Explorer
[1,1,0] #表示是 female,us Firefox
[0,2,1]#表示是 male Asia Chrome
[1,0,2] #表示是 female Europe Safari
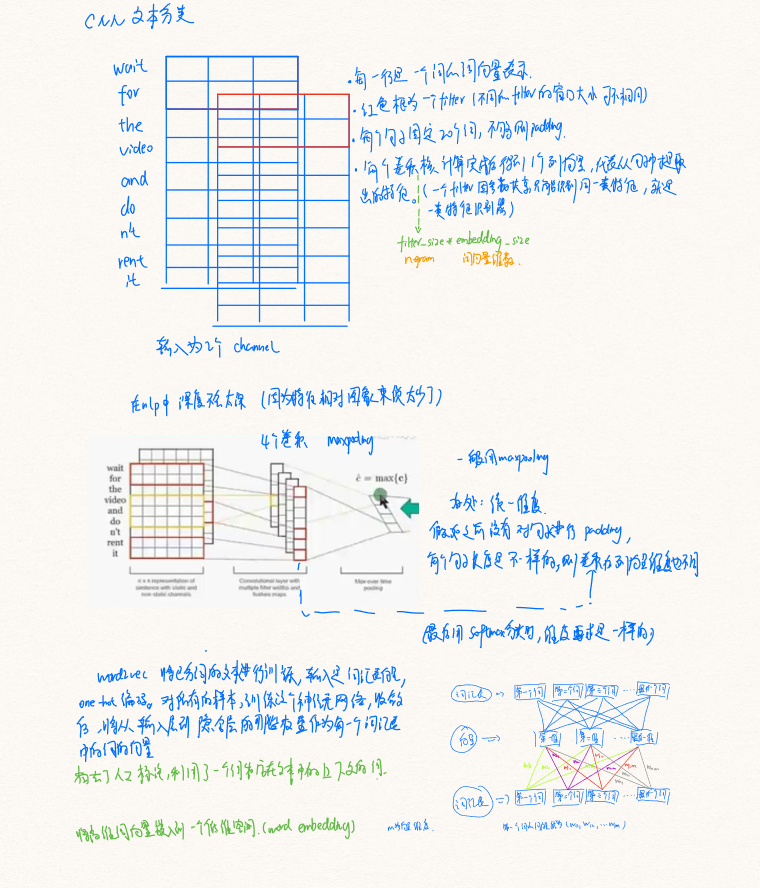
word2vec
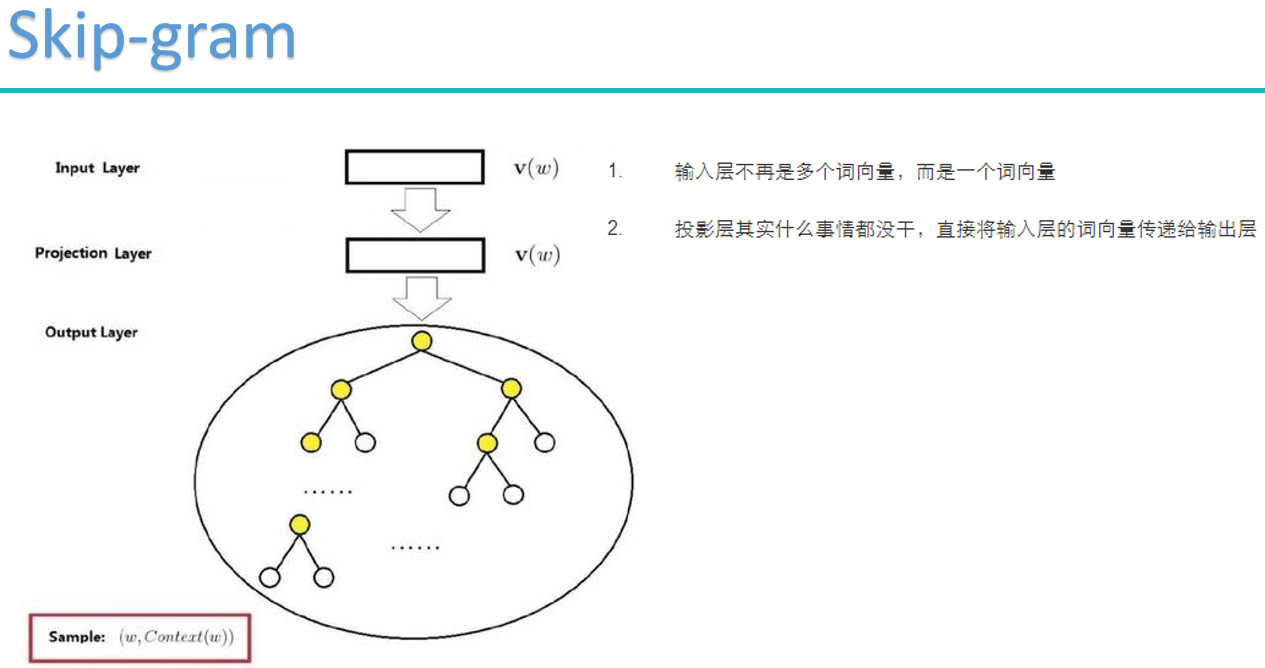
word2vec的两种重要模型:
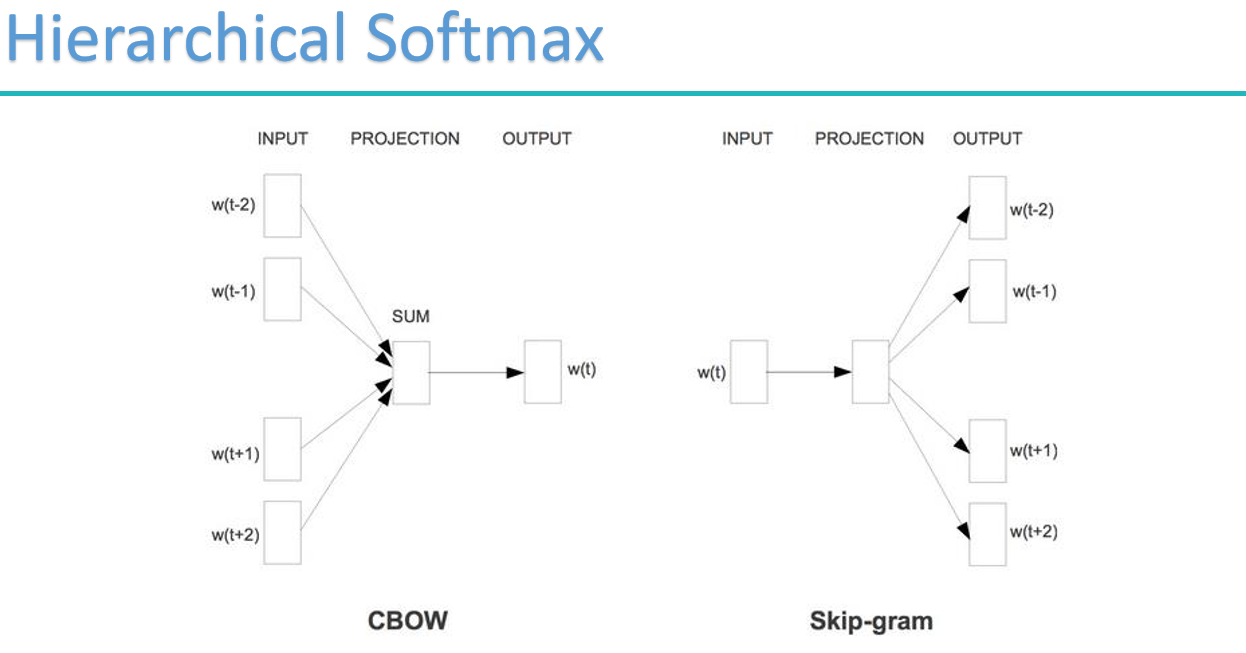
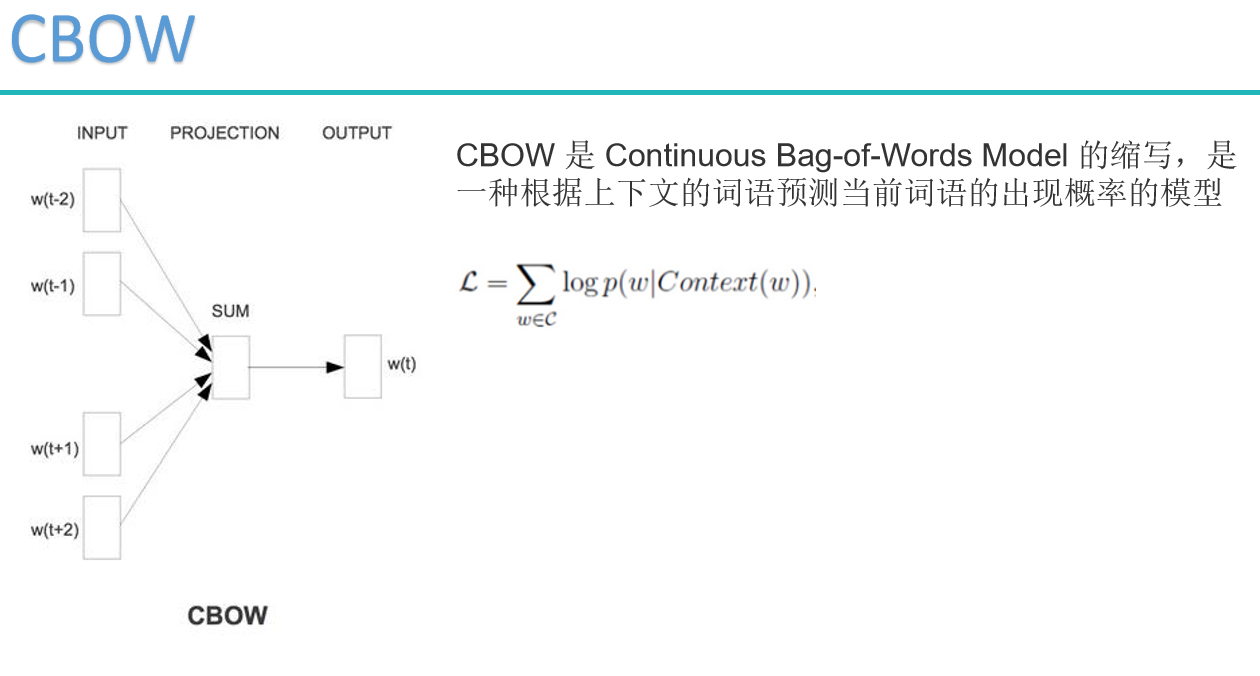


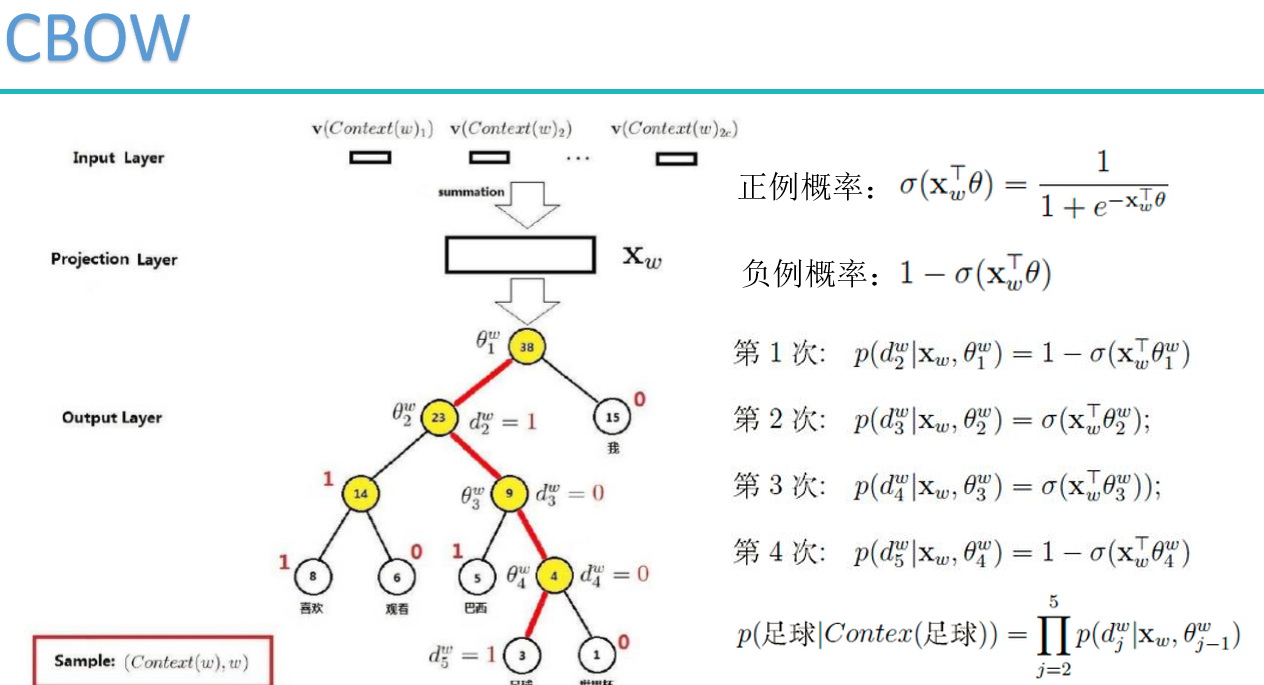
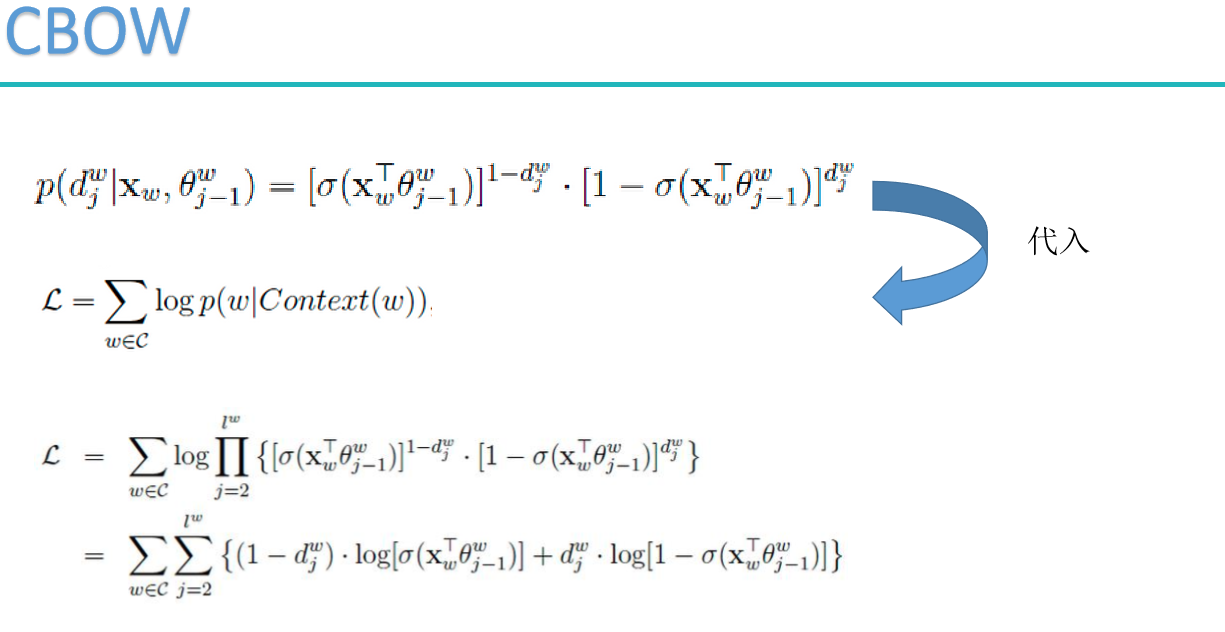


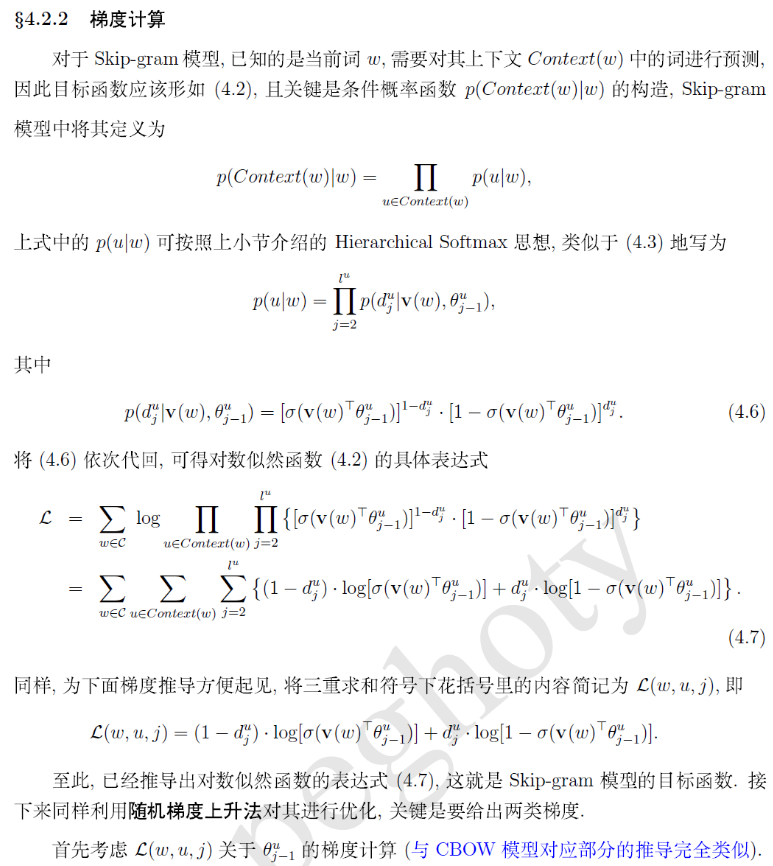
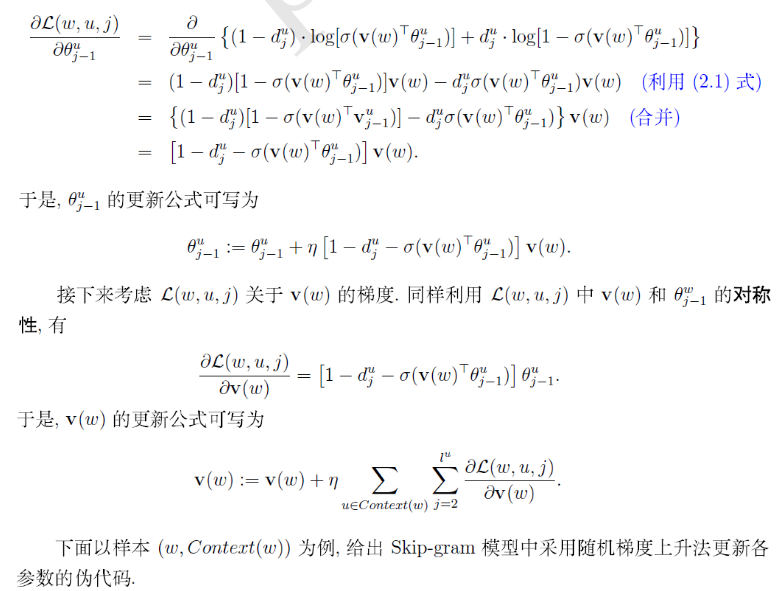
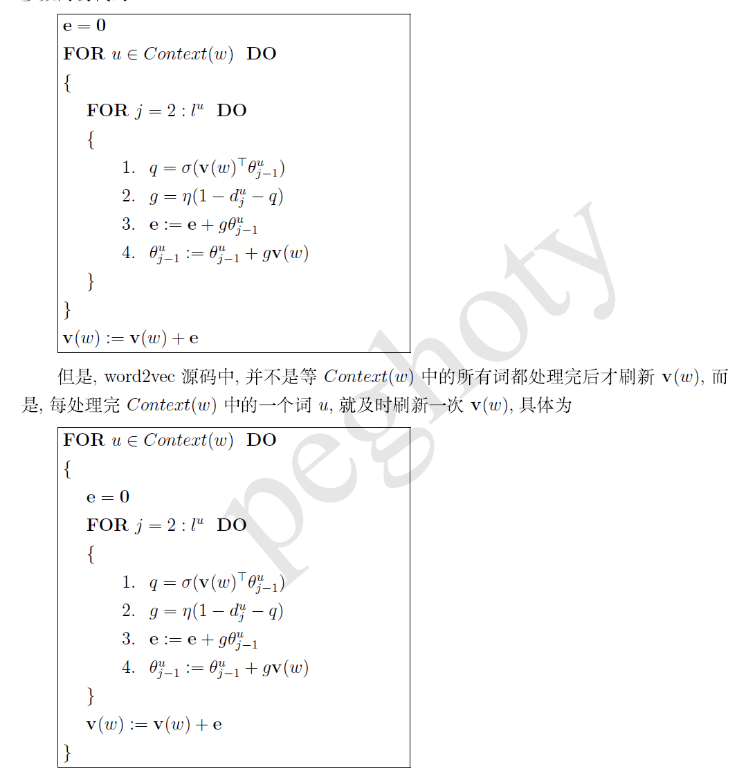
梯度计算
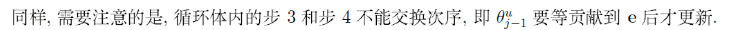
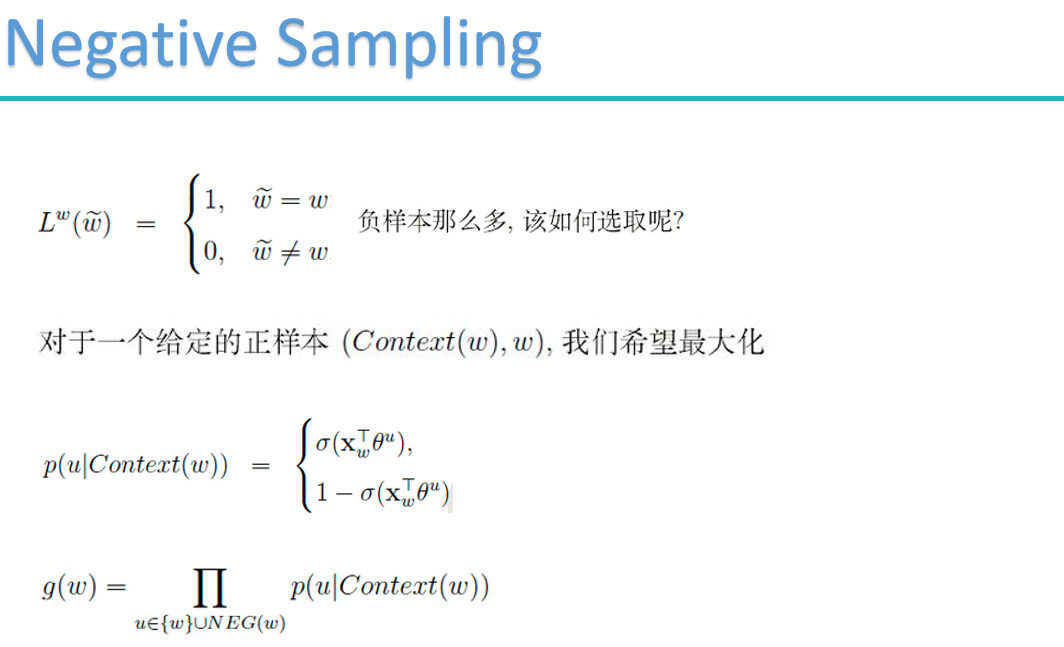
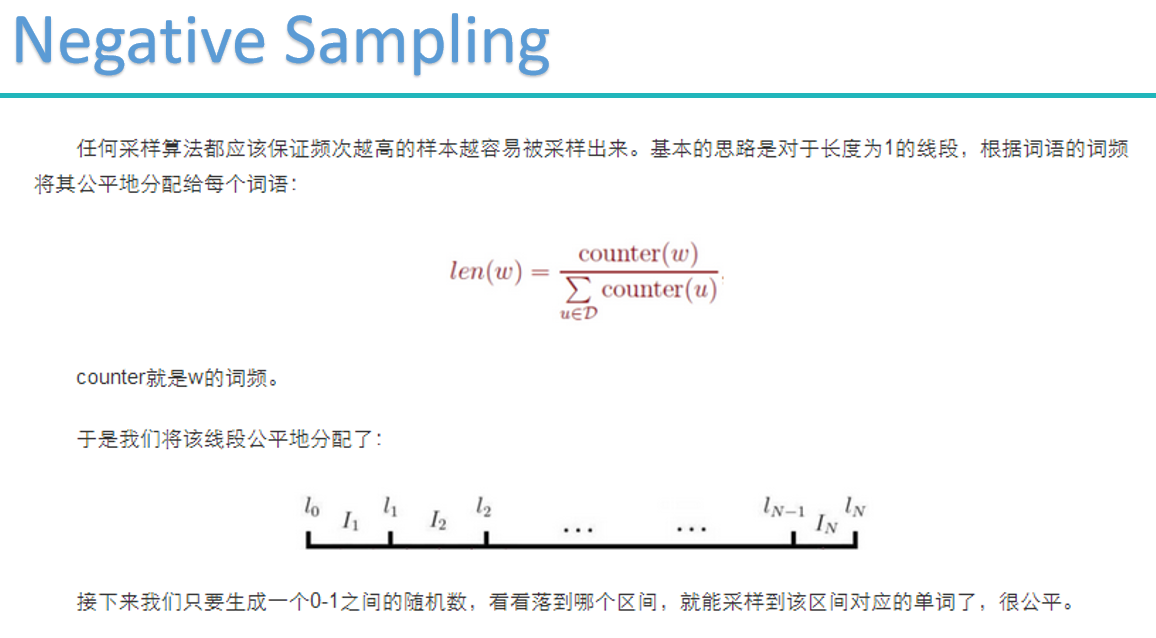

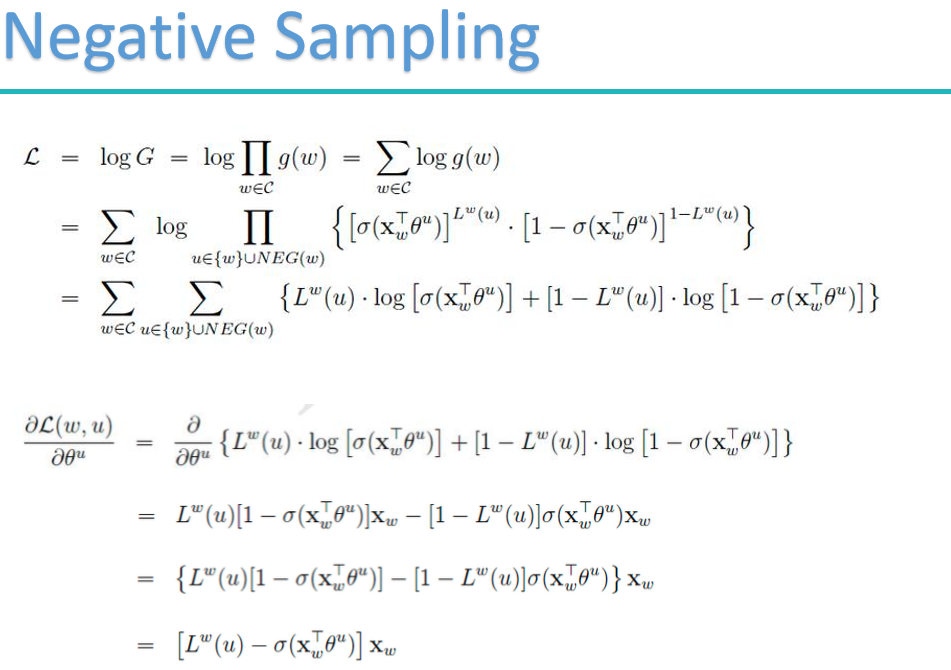
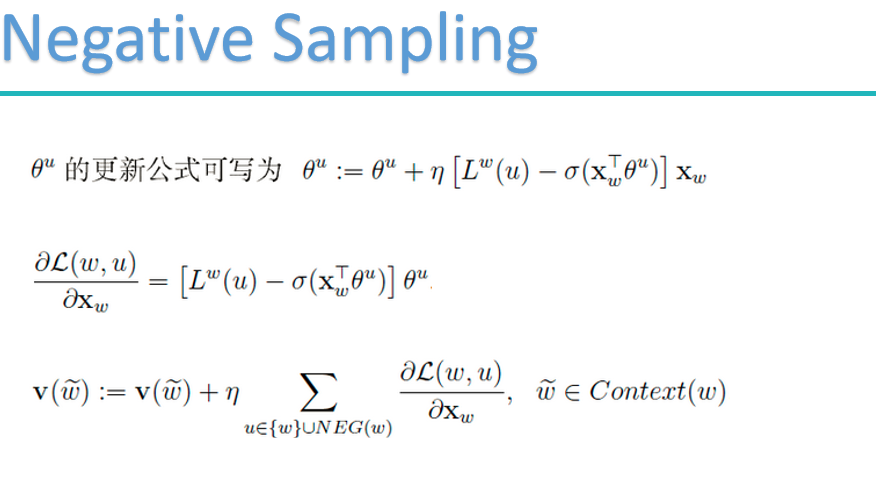
cbow:
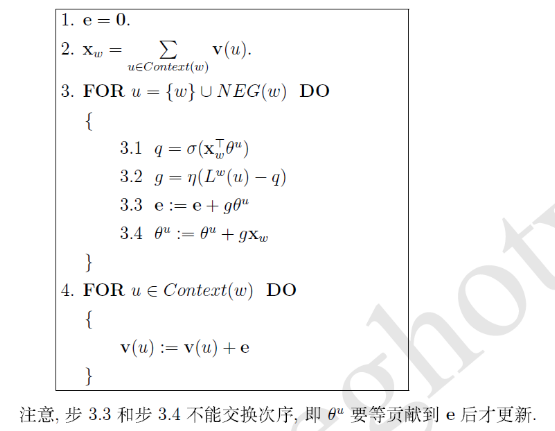
skip-gram


Task4.文本表示:从one-hot到word2vec的更多相关文章
- 文本情感分析(二):基于word2vec、glove和fasttext词向量的文本表示
上一篇博客用词袋模型,包括词频矩阵.Tf-Idf矩阵.LSA和n-gram构造文本特征,做了Kaggle上的电影评论情感分类题. 这篇博客还是关于文本特征工程的,用词嵌入的方法来构造文本特征,也就是用 ...
- 文本分类实战(一)—— word2vec预训练词向量
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- NLP点滴——文本相似度
[TOC] 前言 在自然语言处理过程中,经常会涉及到如何度量两个文本之间的相似性,我们都知道文本是一种高维的语义空间,如何对其进行抽象分解,从而能够站在数学角度去量化其相似性.而有了文本之间相似性的度 ...
- 重磅︱文本挖掘深度学习之word2vec的R语言实现
每每以为攀得众山小,可.每每又切实来到起点,大牛们,缓缓脚步来俺笔记葩分享一下吧,please~ --------------------------- 笔者寄语:2013年末,Google发布的 w ...
- 文本分类实战(十)—— BERT 预训练模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- 文本分类实战(九)—— ELMO 预训练模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- 文本分类实战(八)—— Transformer模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- 文本分类实战(七)—— Adversarial LSTM模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- 文本分类实战(六)—— RCNN模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
随机推荐
- hypermesh中怎么设置支反力(反作用力)
Analysis page >> Control cards >> Global output request 勾选 SPCF 和 GPFORCE .
- Django学习之模板
一.常用语法 1.变量 2.Filters 3.自定义filter 4.Tags 5.csrf_token 6.注释 7.注意事项 二.母板 2.继承母板 3.块(block) 4.组件 5.静态文件 ...
- Redis安装启动,Redis Desktop Manager安装
Window 下安装下载地址:https://github.com/MSOpenTech/redis/releases.Redis 支持 32 位和 64 位.这个需要根据你系统平台的实际情况选择,这 ...
- python 卡方检验例子
python 求拒绝域和卡方值 import scipy.stats as ss obs=[107,198,192,125,132,248] exp=[167]*6 #拒绝域 1%的显著水平,自由度5 ...
- Delphi XE2 之 FireMonkey 入门(11) - 控件居中、旋转、透明
RotationAngle.RotationCenter.Opacity 属性继承自 TControl(FMX.Types), 这些新属性成了控件的基本功能. 先在 HD 窗体上添加 TRectang ...
- 阶段1 语言基础+高级_1-3-Java语言高级_04-集合_03 斗地主案例(单列)_1_斗地主案例的需求分析
洗牌用到集合工具类.Collections里面有个shuffle的方法 完整的需求分析
- uni-app-小程序中组件不支持id选择器等
这个问题刚开始遇到的时候有点搞笑啰,正常情况下,id选择器不是最正常的吗?搞锤子哦. 接着我就找度娘了 ,官网给出的解释是:https://developers.weixin.qq.com/mini ...
- linux下vscode备忘
vscode如何自定义,如何方便地编写c/c++vscode支持vim.sublime快捷键,在设置->keymap可以安装相应插件vscode默认的快捷键支持自定义,打开keyboard sh ...
- Python解决ModuleNotFoundError: No module named 'Queue'的问题
我们知道Python2和Python3两个版本之间,有些不兼容的地方,Python3中引入Queue会报出这个问题. Python3中要这样引入: import queue Python2中要这样引入 ...
- 【MM系列】SAP MM模块-基础配置第一篇
公众号:SAP Technical 本文作者:matinal 原文出处:http://www.cnblogs.com/SAPmatinal/ 原文链接:[MM系列]SAP MM模块-基础配置第一篇 ...