
Hbase总结(五)-hbase常识及habse适合什么场景
当我们对于数据结构字段不够确定或杂乱无章非常难按一个概念去进行抽取的数据适合用使用什么数据库?答案是什么,假设我们使用的传统数据库,肯定留有多余的字段。10个不行,20个,可是这个严重影响了质量。
而且假设面对大数据库,pt级别的数据,这样的浪费更是严重的,那么我们该使用是什么数据库?hbase数个不错的选择,那么我们对于hbase还存在下列问题:
1.Column Family代表什么?
2.HBase通过row和column确定一份数据,这份数据的值可能有多个版本号,为什么会存在多个版本号?
3.查询的时候会显示那个版本号?
4.它们的存储类型是什么?
5.tableName是什么类型?
6.RowKey 和 ColumnName是什么类型?
7.Timestamp 是什么类型?
8.value 是什么类型?
带着以上几个问题去读以下内容:
引言
团队中使用HBase的项目多了起来,对于业务人员而言,通常并不须要从头搭建、维护一套HBase的集群环境。对于其架构细节也不一定要深刻理解(交由HBase集群维护团队负责),迫切须要的是高速理解基本技术来解决业务问题。近期在XX项目轮岗过程中,尝试着从业务人员视角去看HBase,将一些过程记录下来,期望对高速了解HBase、掌握相关技术来开展工作的业务人员有点帮助。我认为作为一个初次接触HBase的业务开发測试人员,他须要迫切掌握的至少包括下面几点:
深入理解HTable。掌握怎样结合业务设计高性能的HTable
掌握与HBase的交互。反正是离不开数据的增删改查,通过HBase Shell命令及Java Api都是须要的
掌握怎样用MapReduce分析HBase里的数据。HBase里的数据总要分析的,用MapReduce是当中一种方式
掌握怎样測试HBase MapReduce,总不能光写无论正确性吧。debug是须要的吧。看看怎样在本机单測debug吧
本系列将环绕以上几点展开,篇幅较长。假设是HBase刚開始学习的人建议边读边练。对于HBase比較熟练的,能够选读下。比方关注下HBase的MapReduce及其測试方法。
从一个演示样例说起
传统的关系型数据库想必大家都不陌生,我们将以一个简单的样例来说明使用RDBMS和HBase各自的解决方案及优缺点。
以博文为例,RDBMS的表设计例如以下:
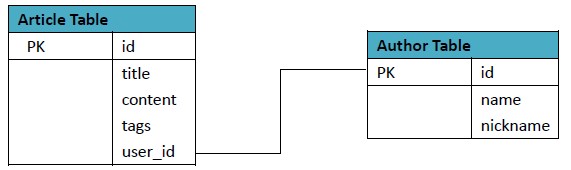
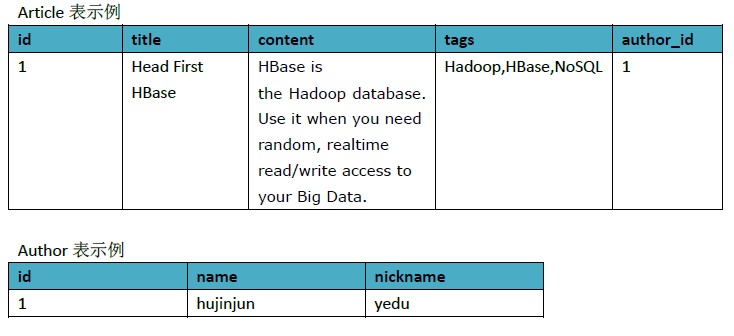
为了方便理解。我们以一些数据演示样例下
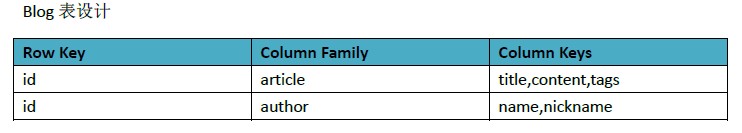
上面的样例。我们用HBase能够按下面方式设计
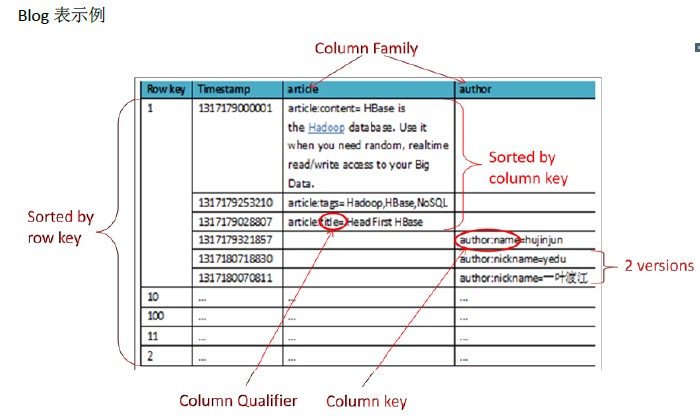
相同为了方便理解,我们以一些数据演示样例下,同一时候用红色标出了一些关键概念。后面会解释
HTable一些基本概念
Row key
行主键,
HBase不支持条件查询和Order by等查询,读取记录仅仅能按Row key(及其range)或全表扫描,因此Row key须要依据业务来设计以利用其存储排序特性(Table按Row key字典序排序如1,10,100,11,2)提高性能。
Column Family(列族)
在表创建时声明。每一个Column
Family为一个存储单元。在上例中设计了一个HBase表blog,该表有两个列族:article和author。
Column(列)
HBase的每一个列都属于一个列族。以列族名为前缀,如列article:title和article:content属于article列族,author:name和author:nickname属于author列族。
Column不用创建表时定义即能够动态新增。同一Column
Family的Columns会群聚在一个存储单元上,并依Column key排序,因此设计时应将具有同样I/O特性的Column设计在一个Column Family上以提高性能。
同一时候这里须要注意的是:这个列是能够添加和删除的,这和我们的传统数据库非常大的差别。
所以他适合非结构化数据。
Timestamp
HBase通过row和column确定一份数据。这份数据的值可能有多个版本号,不同版本号的值依照时间倒序排序,即最新的数据排在最前面,查询时默认返回最新版本号。如上例中row
key=1的author:nickname值有两个版本号,分别为1317180070811相应的“一叶渡江”和1317180718830相应的“yedu”(相应到实际业务能够理解为在某时刻改动了nickname为yedu,但旧值仍然存在)。
Timestamp默觉得系统当前时间(精确到毫秒)。也能够在写入数据时指定该值。
Value
每一个值通过4个键唯一索引。tableName+RowKey+ColumnKey+Timestamp=>value。比如上例中{tableName=’blog’,RowKey=’1’,ColumnName=’author:nickname’,Timestamp=’
1317180718830’}索引到的唯一值是“yedu”。
存储类型
TableName
是字符串
RowKey
和 ColumnName 是二进制值(Java 类型 byte[])
Timestamp
是一个 64 位整数(Java 类型 long)
value
是一个字节数组(Java类型 byte[])。
存储结构
能够简单的将HTable的存储结构理解为
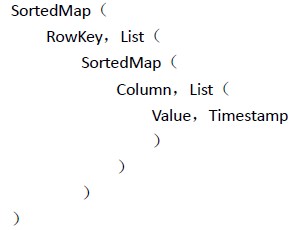
即HTable按Row
key自己主动排序。每一个Row包括随意数量个Columns,Columns之间按Column key自己主动排序,每一个Column包括随意数量个Values。理解该存储结构将有助于查询结果的迭代。
话说什么情况须要HBase
半结构化或非结构化数据
对于数据结构字段不够确定或杂乱无章非常难按一个概念去进行抽取的数据适合用HBase。以上面的样例为例,当业务发展须要存储author的email,phone,address信息时RDBMS须要停机维护。而HBase支持动态添加.
记录很稀疏
RDBMS的行有多少列是固定的。为null的列浪费了存储空间。而如上文提到的,HBase为null的Column不会被存储,这样既节省了空间又提高了读性能。
多版本号数据
如上文提到的依据Row
key和Column key定位到的Value能够有随意数量的版本号值,因此对于须要存储变动历史记录的数据,用HBase就很方便了。比方上例中的author的Address是会变动的,业务上一般仅仅须要最新的值,但有时可能须要查询到历史值。
超大数据量
当数据量越来越大,RDBMS数据库撑不住了,就出现了读写分离策略,通过一个Master专门负责写操作,多个Slave负责读操作,server成本倍增。
随着压力添加。Master撑不住了,这时就要分库了,把关联不大的数据分开部署,一些join查询不能用了。须要借助中间层。随着数据量的进一步添加,一个表的记录越来越大,查询就变得非常慢,于是又得搞分表,比方按ID取模分成多个表以降低单个表的记录数。经历过这些事的人都知道过程是多么的折腾。採用HBase就简单了,仅仅须要加机器就可以,HBase会自己主动水平切分扩展,跟Hadoop的无缝集成保障了其数据可靠性(HDFS)和海量数据分析的高性能(MapReduce)。
Hbase总结(五)-hbase常识及habse适合什么场景的更多相关文章
- hbase常识及habse适合什么场景
当我们对于数据结构字段不够确定或杂乱无章很难按一个概念去进行抽取的数据适合用使用什么数据库?答案是什么,如果我们使用的传统数据库,肯定留有多余的字段,10个不行,20个,但是这个严重影响了质量.并且如 ...
- Hbase入门(五)——客户端(Java,Shell,Thrift,Rest,MR,WebUI)
Hbase的客户端有原生java客户端,Hbase Shell,Thrift,Rest,Mapreduce,WebUI等等. 下面是这几种客户端的常见用法. 一.原生Java客户端 原生java客户端 ...
- Hbase第五章 MapReduce操作HBase
容易遇到的坑: 当用mapReducer操作HBase时,运行jar包的过程中如果遇到 java.lang.NoClassDefFoundError 类似的错误时,一般是由于hadoop环境没有hba ...
- Hbase框架原理及相关的知识点理解、Hbase访问MapReduce、Hbase访问Java API、Hbase shell及Hbase性能优化总结
转自:http://blog.csdn.net/zhongwen7710/article/details/39577431 本blog的内容包含: 第一部分:Hbase框架原理理解 第二部分:Hbas ...
- 【转帖】HBase之五:hbase的region分区
HBase之五:hbase的region分区 https://www.cnblogs.com/duanxz/p/3154487.html 一.Region 概念 Region是表获取和分布的基本元素, ...
- HBase 2、HBase安装与初试牛刀
官方帮助文档:http://hbase.apache.org/book.html PDF:http://hbase.apache.org/apache_hbase_reference_guide.p ...
- HBase案例:HBase 在人工智能场景的使用
近几年来,人工智能逐渐火热起来,特别是和大数据一起结合使用.人工智能的主要场景又包括图像能力.语音能力.自然语言处理能力和用户画像能力等等.这些场景我们都需要处理海量的数据,处理完的数据一般都需要存储 ...
- 大数据技术之_11_HBase学习_01_HBase 简介+HBase 安装+HBase Shell 操作+HBase 数据结构+HBase 原理
第1章 HBase 简介1.1 什么是 HBase1.2 HBase 特点1.3 HBase 架构1.3 HBase 中的角色1.3.1 HMaster1.3.2 RegionServer1.3.3 ...
- HBase 实战(2)--时间序列检索和面检索的应用场景实战
前言: 作为Hadoop生态系统中重要的一员, HBase作为分布式列式存储, 在线实时处理的特性, 备受瞩目, 将来能在很多应用场景, 取代传统关系型数据库的江湖地位. 本篇主要讲述面向时间序列/面 ...
随机推荐
- sequelize初使用
官网地址:Sequelize Sequelize is a promise-based ORM for Node.js v4 and up. It supports the dialects Post ...
- Bug Bounty Reference
https://github.com/ngalongc/bug-bounty-reference/blob/master/README.md#remote-code-execution Bug Bou ...
- linux修改文件打开最大数(ulimit命令)
解除 Linux 系统的最大进程数和最大文件打开数限制:vi /etc/security/limits.conf# 添加如下的行* soft noproc 65536 * hard noproc 65 ...
- jquery-扩展
jQuery扩展三种方式:$.extend,$.fn.extend,外部文件. 1)jQuery.extend(object) 调用 $.方法 2)jQuery.fn.extend(object) ...
- MongoDB 进阶模式设计
原文链接:http://www.mongoing.com/mongodb-advanced-pattern-design 12月12日上午,TJ在开源中国的年终盛典会上分享了文档模型设计的进阶技巧,就 ...
- Oracle-查询最近更新的前10条数据
在实际用途中,常常会要求取最近的几条纪录,这就需要先对纪录进行排序后再取rownum <= 一般常见的 SELECT * FROM (SELECT a.* FROM torderdetail a ...
- CF 554A 字符串水题
给出一个字符串,问再加入一个字母,最多能形成多少种字符串 inputaoutput51inputhioutput76 # include <iostream> # include < ...
- CentOS下Lua 环境的搭建
curl -R -O http://www.lua.org/ftp/lua-5.2.2.tar.gz .tar.gz cd lua- make linux test 报错 cd src &&a ...
- ref:web 防止SQL注入方法
ref:https://blog.csdn.net/beidou321/article/details/6482618 小结:spring采用JdbcTemplate来操作sql,一般不要自行拼接sq ...
- DFT,DTFT,DFS,FFT区别
学习了数字信号处理之后,被里面的几个名词搞的晕头转向,比如DFT,DTFT,DFS,FFT,FT,FS等,FT和FS属于信号与系统课程的内容,是对连续时间信号的处理,这里就不过多讨论,只解释一 ...