
python爬虫 学习1
 1 import requests

 2 from bs4 import BeautifulSoup

 3 import bs4

 4 def gethtmltext(url):     #获取html内容,利用try和except框架可以抛出异常

 5     try:

 6         r = requests.get(url,timeout=30)   #获取url,时间限制为30秒

 7         r.raise_for_status()               #检查连接状态是否为200,即正常连接,如果为否则抛出except异常

 8         r.encoding=r.apparent_encoding     #确定编码

 9         return r.text                      #返回为html的内容

10     except:

11         return ''

12

13

14 def fillunivlist(ulist,html):      #解析html内容,提取所需数据  ulist是一个空列表,用来存取解析出来的所需数据

15     soup = BeautifulSoup(html,'html.parser')    #利用beautifulsoup的html.parser来解析r.text

16     for tr in soup.find('tbody').children:      #通过分析发现所需排序,学校名称,总分存在于tbody标签类的tr标签中的td标签 .children是查找tbody的子类

17         if isinstance(tr,bs4.element.Tag):      #因为tr标签包含其他string,而我们所需要的只是bs4.element.Tag标签类型,所以用isinstance(obj,class)作一个判断

18             tds = tr('td')     #若判断为真则 执行查找tr标签中的td标签,并赋值给tds

19             ulist.append([tds[0].string,tds[1].string,tds[2].string])    #将tds的数据追加给ulist

20

21 def printunivlist(ulist,num):       #格式化输出内容

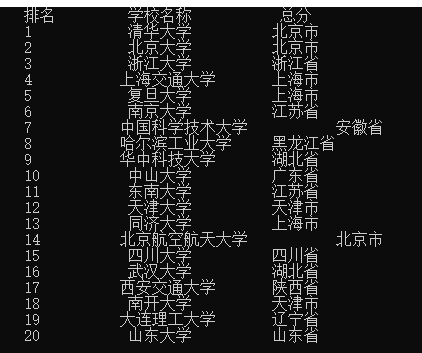
22     print('{:^10}\t{:^6}\t{:^10}'.format('排名','学校名称','总分'))

23     for i in range(num):

24         u=ulist[i]

25         print('{:^10}\t{:^6}\t{:^10}'.format(u[0],u[1],u[2]))

26

27

28 def main():    #定义一个主函数,实现具体抓取并输出

29     uinfo = []

30     url = 'http://www.zuihaodaxue.cn/zuihaodaxuepaiming2016.html'

31     html = gethtmltext(url)

32     fillunivlist(uinfo,html)

33     printunivlist(uinfo,20)

34

35 main()
效果图如下:
python爬虫 学习1的更多相关文章
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
- python爬虫学习 —— 总目录
开篇 作为一个C党,接触python之后学习了爬虫. 和AC算法题的快感类似,从网络上爬取各种数据也很有意思. 准备写一系列文章,整理一下学习历程,也给后来者提供一点便利. 我是目录 听说你叫爬虫 - ...
- Python爬虫学习:三、爬虫的基本操作流程
本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:三.爬虫的基本操作与流程 一般我们使用Python爬虫都是希望实现一套完整的功能,如下: 1.爬虫目标数据.信息: 2.将 ...
- Python爬虫学习:四、headers和data的获取
之前在学习爬虫时,偶尔会遇到一些问题是有些网站需要登录后才能爬取内容,有的网站会识别是否是由浏览器发出的请求. 一.headers的获取 就以博客园的首页为例:http://www.cnblogs.c ...
- Python爬虫学习:二、爬虫的初步尝试
我使用的编辑器是IDLE,版本为Python2.7.11,Windows平台. 本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:二.爬虫的初步尝试 1.尝试抓取指定网页 ...
- 《Python爬虫学习系列教程》学习笔记
http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多.学习过程中我把一些学习的笔记总结下来,还记录了一些自己 ...
- python爬虫学习视频资料免费送,用起来非常666
当我们浏览网页的时候,经常会看到像下面这些好看的图片,你是否想把这些图片保存下载下来. 我们最常规的做法就是通过鼠标右键,选择另存为.但有些图片点击鼠标右键的时候并没有另存为选项,或者你可以通过截图工 ...
- python爬虫学习笔记(一)——环境配置(windows系统)
在进行python爬虫学习前,需要进行如下准备工作: python3+pip官方配置 1.Anaconda(推荐,包括python和相关库) [推荐地址:清华镜像] https://mirrors ...
- [转]《Python爬虫学习系列教程》
<Python爬虫学习系列教程>学习笔记 http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多. ...
- python爬虫学习01--电子书爬取
python爬虫学习01--电子书爬取 1.获取网页信息 import requests #导入requests库 ''' 获取网页信息 ''' if __name__ == '__main__': ...
随机推荐
- java中对 闰年的计算 以及月份天数
import java.io.*;//局部变量的使用import java.util.Scanner; public class HelloJava { public static void ...
- IDEA 使用的配置
IDEA 使用 工欲善其事必先利其器,选择适合自己的 IDE,会让自己事倍功半.作为 Java 开发环境,有人喜欢 Eclipse,有人喜欢 idea,这其中的差别对比这里不做对比,需要了解的朋友可以 ...
- 开发基于Django和Websocket的堡垒机
WebSSH有很多,基于Django的Web服务也有很多,使用Paramiko在Python中进行SSH访问的就更多了.但是通过gevent将三者结合起来,实现通过浏览器访问的堡垒机就很少见了.本文将 ...
- 086 01 Android 零基础入门 02 Java面向对象 01 Java面向对象基础 03 面向对象基础总结 01 面向对象基础(类和对象)总结
086 01 Android 零基础入门 02 Java面向对象 01 Java面向对象基础 03 面向对象基础总结 01 面向对象基础(类和对象)总结 本文知识点:面向对象基础(类和对象)总结 说明 ...
- 004 01 Android 零基础入门 01 Java基础语法 01 Java初识 04 Java程序的结构
004 01 Android 零基础入门 01 Java基础语法 01 Java初识 04 Java程序的结构 Java程序的结构 Java程序外层--类 程序外层,如下面的代码,是一个类的定义. c ...
- ::在C++中是什么意思
转自:https://blog.csdn.net/u012547790/article/details/22727277 ::在C++中是什么意思 今天又想了一下::在C++中是什么意思: 表示作用域 ...
- 完全小白入门:python的下载和安装
1. 打开官网www.python.org,选择Downloads
- 「DevOps 转型与实践」沙龙回顾第二讲
背景介绍 本期分享内容为<平台化 DevOps-云计算与云原生模式下 DevOps 的建设实践>.目前,DevOps 越来越成为大家当前建设的热点,伴随着基础设施的转型和应用框架的转型,更 ...
- JavaScript倒计时效果
实现思路: 输入的时间减去现在的时间就是剩余的时间,但是不能拿着时分秒相减,比如05分减去25分,结果会是负的. 可以用时间戳来做,用户输入时间总的毫秒数减去现在时间的总的毫秒数,得到的就是剩余时间的 ...
- 利用 JS 脚本实现网页全自动秒杀抢购
利用 JS 脚本实现网页全自动秒杀抢购 倒计时页面: 倒计时未结束时,购买按钮还不能点击. 结束时,可以点击购买,点击后出现提示"付款成功" 展示效果 1.制作测试网页 首先我们来 ...