
Jsoup代码示例、解析网页+提取文本
使用Jsoup解析HTML
那么我们就必须用到HttpClient先获取到html
同样我们引入HttpClient相关jar包
以及commonIO的jar包
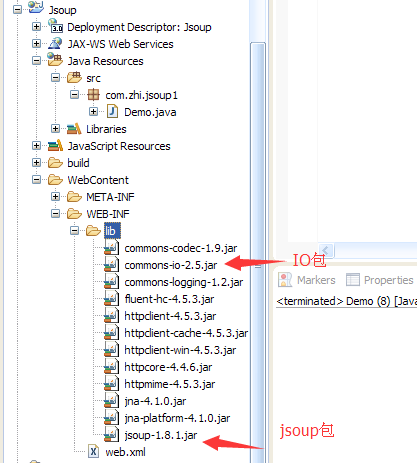
我们把httpClient的基本代码写上,然后解析网页 得到文档对象
我们获取title和制定id的文档对象
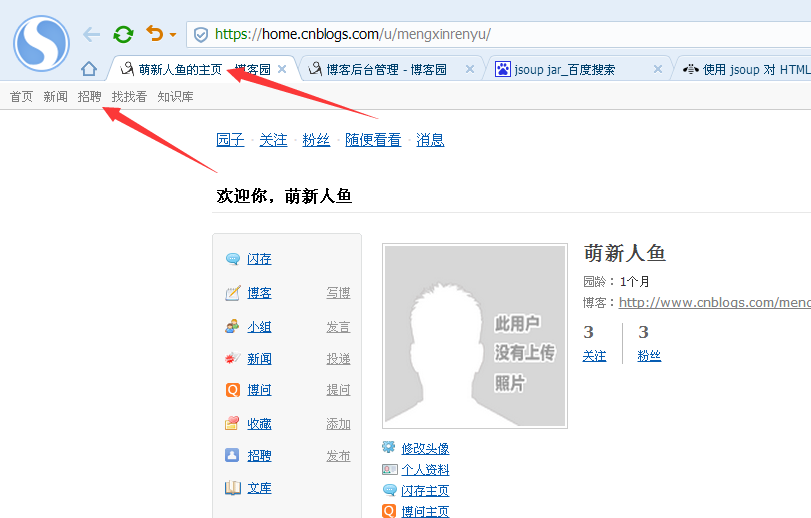
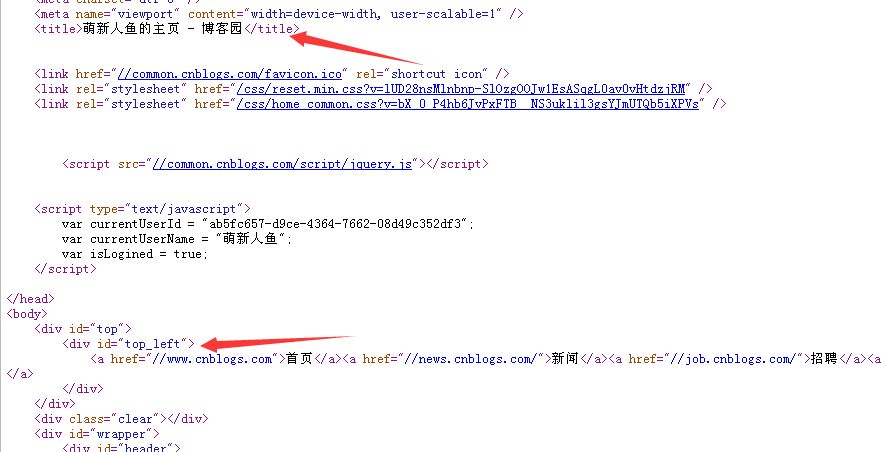
代码实例:
package com.zhi.jsoup1;

import org.apache.http.HttpEntity;

import org.apache.http.client.methods.CloseableHttpResponse;

import org.apache.http.client.methods.HttpGet;

import org.apache.http.impl.client.CloseableHttpClient;

import org.apache.http.impl.client.HttpClients;

import org.apache.http.util.EntityUtils;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

public class Demo {

	public static void main(String[] args) throws Exception {

		CloseableHttpClient httpClient=HttpClients.createDefault(); //1、创建实例

		HttpGet httpGet=new HttpGet("https://home.cnblogs.com/u/mengxinrenyu/"); //2、创建实例

		httpGet.setHeader("User-Agent", "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/38.0.2125.122 Safari/537.36 SE 2.X MetaSr 1.0");

		CloseableHttpResponse httpResponse=httpClient.execute(httpGet); //3、执行

		HttpEntity entity=httpResponse.getEntity(); //4、获取实体

		String content=EntityUtils.toString(entity, "utf-8"); //5、获取网页内容

		httpResponse.close();

		httpClient.close();

		Document doc=Jsoup.parse(content); // 解析网页 得到文档对象

        Elements elements=doc.getElementsByTag("title"); // 获取tag是title的所有DOM元素

        Element element=elements.get(0); // 获取第1个元素

        String title=element.text(); // 返回元素的文本

        System.out.println("标题:"+title);

        element=doc.getElementById("top_left"); // 获取id=top_left的DOM元素

        String menu=element.text(); // 返回元素的文本

        System.out.println("导航:"+menu);

	}

}
由于网页我是登陆以后的,所以会出现以下错误
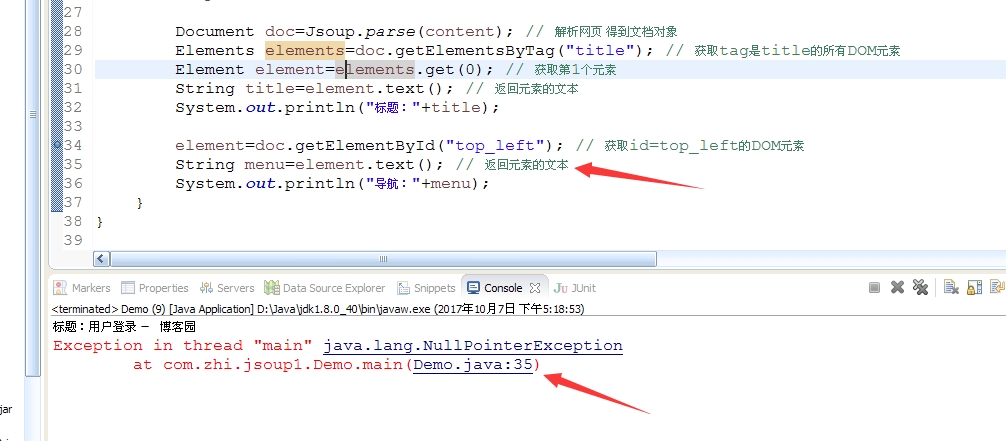
因为请求的是某个登陆账户下的网页,所以网页会提示登录。从没没有相应id的元素,返回NPE。
我们换一个新闻页面试一下
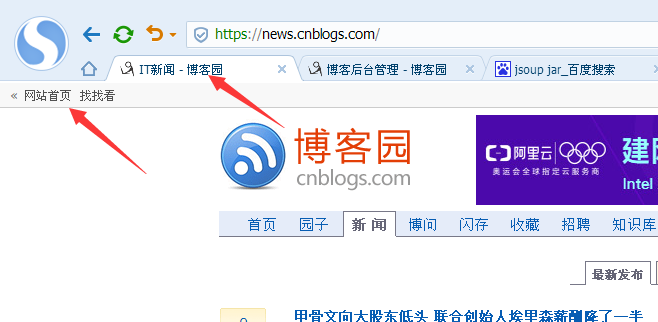
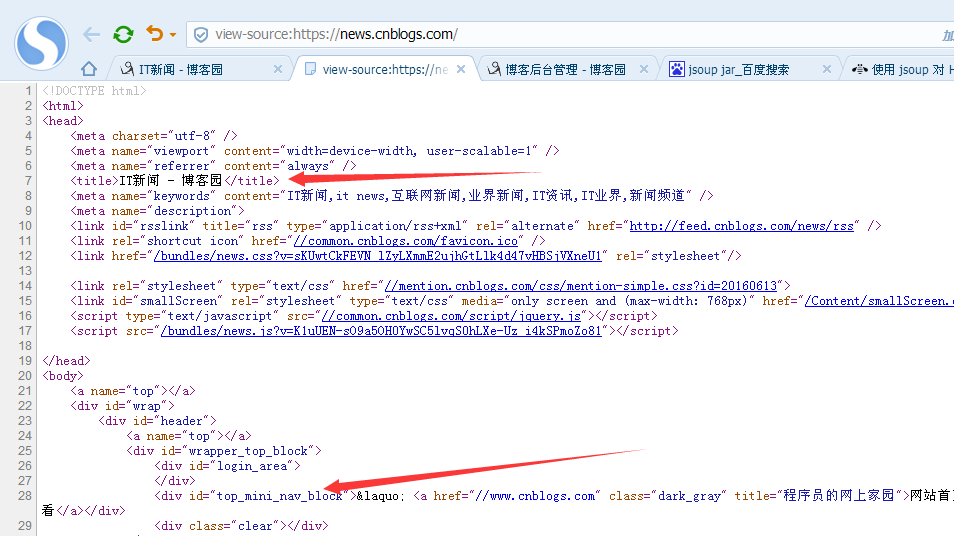
代码示例:
public class Demo {

	public static void main(String[] args) throws Exception {

		CloseableHttpClient httpClient=HttpClients.createDefault(); //1、创建实例

		HttpGet httpGet=new HttpGet("https://news.cnblogs.com/"); //2、创建实例

		httpGet.setHeader("User-Agent", "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/38.0.2125.122 Safari/537.36 SE 2.X MetaSr 1.0");

		CloseableHttpResponse httpResponse=httpClient.execute(httpGet); //3、执行

		HttpEntity entity=httpResponse.getEntity(); //4、获取实体

		String content=EntityUtils.toString(entity, "utf-8"); //5、获取网页内容

		httpResponse.close();

		httpClient.close();

		Document doc=Jsoup.parse(content); // 解析网页 得到文档对象

        Elements elements=doc.getElementsByTag("title"); // 获取tag是title的所有DOM元素

        Element element=elements.get(0); // 获取第1个元素

        String title=element.text(); // 返回元素的文本

        System.out.println("标题:"+title);

        element=doc.getElementById("top_mini_nav_block"); // 获取id=top_left的DOM元素

        String menu=element.text(); // 返回元素的文本

        System.out.println("导航:"+menu);

	}

}
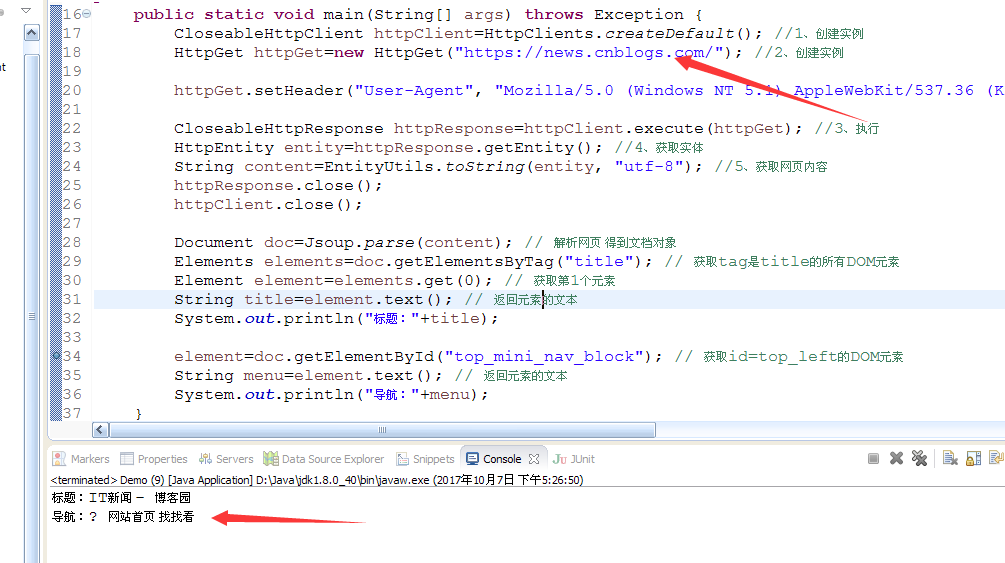
运行如图:
Jsoup代码示例、解析网页+提取文本的更多相关文章
- 使用java开源工具httpClient及jsoup抓取解析网页数据
今天做项目的时候遇到这样一个需求,需要在网页上展示今日黄历信息,数据格式如下 公历时间:2016年04月11日 星期一 农历时间:猴年三月初五 天干地支:丙申年 壬辰月 癸亥日 宜:求子 祈福 开光 ...
- 使用Python中的HTMLParser、cookielib抓取和解析网页、从HTML文档中提取链接、图像、文本、Cookies(二)(转)
对搜索引擎.文件索引.文档转换.数据检索.站点备份或迁移等应用程序来说,经常用到对网页(即HTML文件)的解析处理.事实上,通过 Python语言提供的各种模块,我们无需借助Web服务器或者Web浏览 ...
- Python中的HTMLParser、cookielib抓取和解析网页、从HTML文档中提取链接、图像、文本、Cookies(二)
对搜索引擎.文件索引.文档转换.数据检索.站点备份或迁移等应用程序来说,经常用到对网页(即HTML文件)的解析处理.事实上,通过 Python语言提供的各种模块,我们无需借助Web服务器或者Web浏览 ...
- 【python】使用HTMLParser、cookielib抓取和解析网页、从HTML文档中提取链接、图像、文本、Cookies
一.从HTML文档中提取链接 模块HTMLParser,该模块使我们能够根据HTML文档中的标签来简洁.高效地解析HTML文档. 处理HTML文档的时候,我们常常需要从其中提取出所有的链接.使用HTM ...
- Jsoup解析网页源码时常用的Element(s)类
Jsoup解析网页源码时常用的Element(s)类 一.简介 该类是Node的直接子类,同样实现了可克隆接口.类声明:public class Element extends Node 它表示由一个 ...
- Jsoup解析网页html
Jsoup解析网页html 解析网页demo: 利用Jsoup获取截图中的数据信息: html代码片段: <!-- 当前基金档案\计算\定投\开户 start --> <div cl ...
- [译]使用BeautifulSoup和Python从网页中提取文本
如果您要花时间浏览网页,您可能遇到的一项任务就是从HTML中删除可见的文本内容. 如果您使用的是Python,我们可以使用BeautifulSoup来完成此任务. 设置提取 首先,我们需要获取一些HT ...
- (java)Jsoup爬虫学习--获取网页所有的图片,链接和其他信息,并检查url和文本信息
Jsoup爬虫学习--获取网页所有的图片,链接和其他信息,并检查url和文本信息 此例将页面图片和url全部输出,重点不太明确,可根据自己的需要输出和截取: import org.jsoup.Jsou ...
- Jsoup提取文本时保留标签
使用Jsoup来对html进行处理比较方便,你可能会用它来提取文本或清理html标签.如果你想提取文本时保留标签,可以使用Jsoup.clean方法,参数为html及标签白名单: Jsoup.clea ...
随机推荐
- HIbernate入门3
HIbernate的一对多操作: 1. 创建实体类:一个Customer类(客户类)和一个LinkMan类(联系人),两者的关系为:一个客户中可能有多个联系人(关于一对多的实体类之间的关联,不做详细介 ...
- 【mysql】select子句顺序
sleect…from (1)where (2)group by (3)having (4)order by (5)limit
- Redis主从同步、哨兵、集群
什么是主从同步(复制) 主从复制,是指将一台Redis服务器的数据,复制到其他的Redis服务器.前者称为主节点(master),后者称为从节点(slave),数据的复制是单向的,只能由主节点到从节点 ...
- 问题 B: 傻鸡抓大闸蟹
问题 B: 傻鸡抓大闸蟹 时间限制: 1 Sec 内存限制: 128 MB提交: 94 解决: 39[提交] [状态] [命题人:jsu_admin] 题目描述 背景又到了吃大闸蟹的季节,黄老师想 ...
- 图片,word,Excel等附件上传
@ResponseBody @RequestMapping("/upload") public String upload(HttpServletRequest request, ...
- 07-js数据类型
# JavaScript 基本数据类型 typeof函数获取一个变量的类型: ```angularjs* boolean - 如果变量是 Boolean 类型的* number - 如果变量是 Num ...
- redis-Nosql
Nosql: CAP:C(Consistency):强一致性.A(Availability):可用性.P(Partitio Tolerance):分区容错性 CAP 理论的核心是: 一个分布式系统,不 ...
- 用Node.js原生代码实现静态服务器
---恢复内容开始--- 后端中服务器类型有两种 1. web服务器[ 静态服务器 ] - 举例: wamp里面www目录 - 目的是为了展示页面内容 - 前端: nginx 2. 应用级服务器[ a ...
- OC学习--面向对象的个人理解
1. 什么是面向对象? 以下一段话是我在百度上找的解释: 面向对象(Object Oriented,OO)是软件开发方法.面向对象的概念和应用已超越了程序设计和软件开发,扩展到如数据库系统.交互式界面 ...
- NTP时间服务器构建
搭建一个NTP服务器,为整个网络环境中的所有主机提供时间校准服务,具体如下: - 部署一台NTP时间服务器 - 设置时间服务器上层与0.centos.pool.ntp.org同步 - 设置本地服务器层 ...