
Doc2vec实现原理
1、Doc2vec概述
Doc2vec 和熟知的 Word2vec 类似,只不过 Word2vec 是训练词向量,而 Doc2vec 可以训练句子,段落,文档的向量表示。
Doc2vec 将文本向量化的应用解决了几个问题:
1)解决了文本中词之间的顺序问题
2)解决了文本中词的语义问题
3)解决了文本向量化后的高稀疏高维度的问题
4)解决了文本长度不均的问题,可以转变成等长的向量,适用于句子,段落和文本。
利用 Doc2vec 可以极大地提高在文本分类,情感分析等问题上的准确率
2、Doc2vec模型
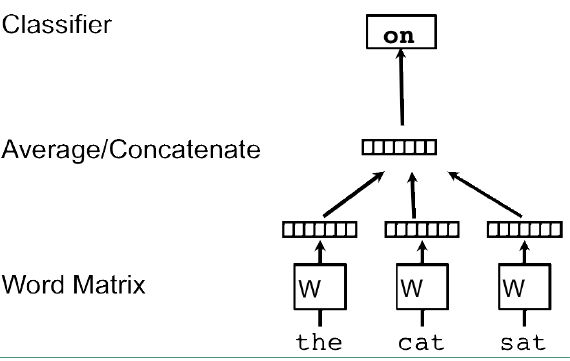
Doc2vec 中的两个模型都是受到 word2vec 激发的。在 word2vec 中的CBOW模型是利用上下文的词预测中心词。其具体模型图如下:
而在 Doc2vec 有个类似的模型,称为 Distributed Memory Model of Paragraph Vectors (PV-DM)。其具体模型结构如下图:
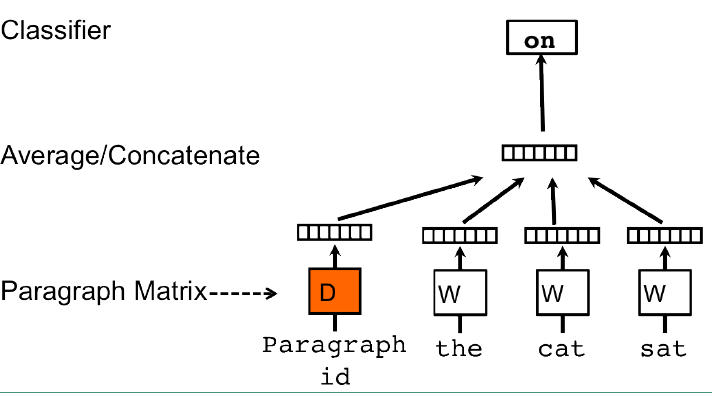
PV-DM 模型较 CBOW 的不同点就是引入了段落作为输入值。假设在我们的语料库中有 N 个段落、M 个词,段落映射后的向量长度为p,词映射后的向量长度为q。则整个模型的参数就是 N × p + M × q 。
而在输入值也是采用固定的滑动窗口来输入的。但是在这里段落该怎么处理呢?原文中是这么说的(不是很明确意思,各位自己理解):
The contexts are fixed-length and sampled from a sliding window over the paragraph. The paragraph vector is shared across all contexts generated from the same paragraph but not across paragraphs. The word vector matrix W, however, is shared across paragraphs. I.e., the vector for “powerful” is the same for all paragraphs。
对于这段话我的理解是,段落与段落之间是相互独立的,而词在所有段落之间是共享的。
在预测新的段落(不在语料库中)的向量时,固定词向量W 和 softmax时的权重 U 和偏置 b。将新的段落加入到矩阵D中,然后梯度下降求新段落的向量。
除了PV-DM 模型之外,还有一个 PV-DBOW (Distributed Bag ofWords version of Paragraph Vector)模型(该模型有点类似于skip-gram 模型)。具体的模型结构如下:
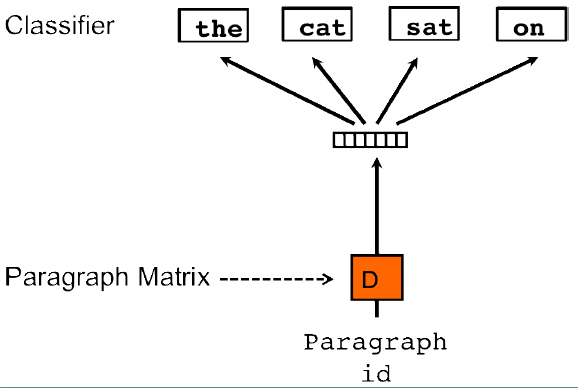
PV-DBOW 模型是一种忽略了上下文的方法。这个模型输入时段落矩阵,输出是从段落中随机采样的词,而且在每次梯度下降迭代时都会重新采样,以此来训练段落向量。
一般来说 PV-DM 模型就可以获得很好的结果,但是将 PV-DM 和 PV-DBOW 两个模型生成的向量结合起来的效果会更好。所以更推荐后者。
Doc2vec实现原理的更多相关文章
- [Algorithm & NLP] 文本深度表示模型——word2vec&doc2vec词向量模型
深度学习掀开了机器学习的新篇章,目前深度学习应用于图像和语音已经产生了突破性的研究进展.深度学习一直被人们推崇为一种类似于人脑结构的人工智能算法,那为什么深度学习在语义分析领域仍然没有实质性的进展呢? ...
- word2vec模型原理与实现
word2vec是Google在2013年开源的一款将词表征为实数值向量的高效工具. gensim包提供了word2vec的python接口. word2vec采用了CBOW(Continuous B ...
- Gensim进阶教程:训练word2vec与doc2vec模型
本篇博客是Gensim的进阶教程,主要介绍用于词向量建模的word2vec模型和用于长文本向量建模的doc2vec模型在Gensim中的实现. Word2vec Word2vec并不是一个模型--它其 ...
- 【机器学习】使用gensim 的 doc2vec 实现文本相似度检测
环境 Python3, gensim,jieba,numpy ,pandas 原理:文章转成向量,然后在计算两个向量的余弦值. Gensim gensim是一个python的自然语言处理库,能够将文档 ...
- 基于Doc2vec训练句子向量
目录 一.Doc2vec原理 二.代码实现 三.总结 一.Doc2vec原理 前文总结了Word2vec训练词向量的细节,讲解了一个词是如何通过word2vec模型训练出唯一的向量来表示的.那接着 ...
- 奇异值分解(SVD)原理与在降维中的应用
奇异值分解(Singular Value Decomposition,以下简称SVD)是在机器学习领域广泛应用的算法,它不光可以用于降维算法中的特征分解,还可以用于推荐系统,以及自然语言处理等领域.是 ...
- node.js学习(三)简单的node程序&&模块简单使用&&commonJS规范&&深入理解模块原理
一.一个简单的node程序 1.新建一个txt文件 2.修改后缀 修改之后会弹出这个,点击"是" 3.运行test.js 源文件 使用node.js运行之后的. 如果该路径下没有该 ...
- 线性判别分析LDA原理总结
在主成分分析(PCA)原理总结中,我们对降维算法PCA做了总结.这里我们就对另外一种经典的降维方法线性判别分析(Linear Discriminant Analysis, 以下简称LDA)做一个总结. ...
- [原] KVM 虚拟化原理探究(1)— overview
KVM 虚拟化原理探究- overview 标签(空格分隔): KVM 写在前面的话 本文不介绍kvm和qemu的基本安装操作,希望读者具有一定的KVM实践经验.同时希望借此系列博客,能够对KVM底层 ...
随机推荐
- Netty实战十三之使用UDP广播事件
1.UDP的基础知识 我们将会把重点放在一个无连接协议即用户数据报协议(UDP)上,它通常用在性能至关重要并且能够容忍一定的数据报丢失的情况下. 面向连接的传输(如TCP)管理了两个网络端点之间的连接 ...
- 修改tomcat命令黑窗口的名字
一.为什么要修改tomcat黑窗口的名字 同时启动多个tomcat时,不好区分,而给tomcat的命令窗口取名区分是个不错的选择,例如下面这个效果. 二.修改的方法 1.找到tomcat的bin目录下 ...
- python面向对象学习(五)多态
多态 多态:不同的 子类对象 调用相同的 父类方法,产生不同的执行结果 多态 可以 增加代码的灵活度 以 继承 和 重写父类方法 为前提 是调用方法的技巧,不会影响到类的内部设计 多态案例练习 需求 ...
- awk、nawk、mawk、gawk的简答介绍
awk 是一种编程语言,用于在linux/unix下对文本和数据进行处理.数据可以来自标准输入.一个或多个文件,或其它命令的输出(即管道).它支持用户自定义函数和 动态正则表达式等先进功能,是linu ...
- Java中的匿名内部类及内部类的二三事
匿名内部类适合创建那些只需要使用一次的类,它的语法有些奇怪,创建匿名内部类会立即创建一个该类的实例,这个类定义立即消失,且不能重复使用. 定义匿名类的格式如下: new 实现接口() |父类构造器(实 ...
- java集合框架-List集合ArrayList和LinkedList详解
List 集合源码剖析 ✅ ArrayList 底层是基于数组,(数组在内存中分配连续的内存空间)是对数组的升级,长度是动态的. 数组默认长度是10,当添加数据超越当前数组长度时,就会进行扩容,扩容长 ...
- spring-framework-中文文档一:IoC容器、介绍Spring IoC容器和bean
5. IoC容器 5.1介绍Spring IoC容器和bean 5.2容器概述 本章介绍Spring Framework实现控制反转(IoC)[1]原理.IoC也被称为依赖注入(DI).它是一个过程, ...
- Suricata规则编写——常用关键字
本篇转载自:http://blog.csdn.net/wuyangbotianshi/article/details/44775181 1.简介 现在的NIDS领域snort一枝独秀,而suricat ...
- F5负载的应用IIS日志记录的不是真实IP的处理方法
如果没有这一项,在服务里添加上 将F5XForwardedFor.dll拷贝到应用目录下 添加筛选器: 名称:F5XForwardedFor 可执行文件:F5XForwardedFor.dll所在的目 ...
- python 数据驱动ddt使用,需要调用下面的代码,请挨个方法调试,把不用的注释掉
#!/usr/bin/env/python # -*- coding: utf-8 -*- # @Time : 2018/12/15 15:27 # @Author : ChenAdong # @Em ...