
利用Selenium爬取淘宝商品信息
一. Selenium和PhantomJS介绍
Selenium是一个用于Web应用程序测试的工具,Selenium直接运行在浏览器中,就像真正的用户在操作一样。由于这个性质,Selenium也是一个强大的网络数据采集工具,其可以让浏览器自动加载页面,这样,使用了异步加载技术的网页,也可获取其需要的数据。
Selenium模块是Python的第三方库,可以通过pip进行安装:
|
pip3 install selenium |
Selenium自己不带浏览器,需要配合第三方浏览器来使用。通过help命令查看Selenium的Webdriver功能,查看Webdriver支持的浏览器:
|
from selenium import webdriver help(webdriver) |
查看执行后的结果,如下图所示:
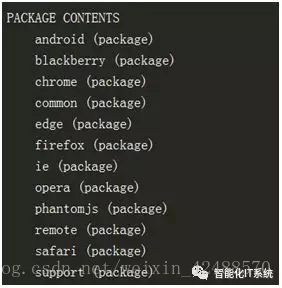
在这个案例中,采用PhantomJS。Selenium和PhantomJS的配合使用可以完全模拟用户在浏览器上的所有操作,包括输入框内容填写、单击、截屏、下滑等各种操作。这样,对于需要登录的网站,用户可以不需要通过构造表单或提交cookie信息来登录网站。
二. 案例介绍
这里所举的案例,是利用Selenium爬取淘宝商品信息,爬取的内容为淘宝网(https://www.taobao.com/)上男士短袖的商品信息,如下图所示:
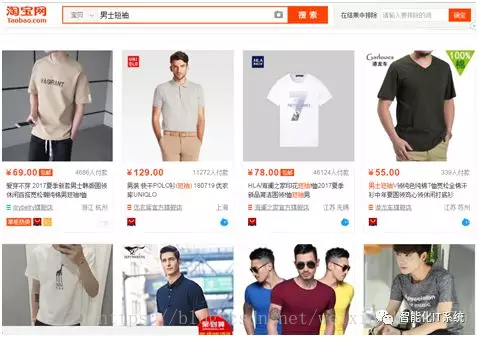
这里可以看到,在用户输入淘宝后,需要模拟输入,在输入框输入“男士短袖”。
案例中使用Selenium和PhantomJS,模拟电脑的搜索操作,输入商品名称进行搜索,如图所示,“检查”搜索框元素。
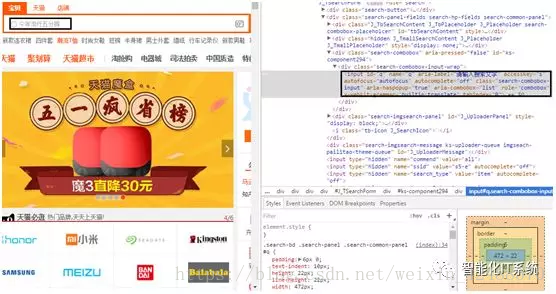
并且如下图所示,“检查”下一页元素:
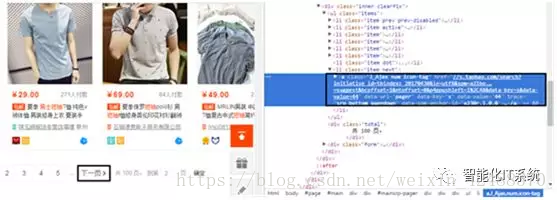
爬取的内容有商品价格、付款人数、商品名称、商家名称和地址,如下图所示:
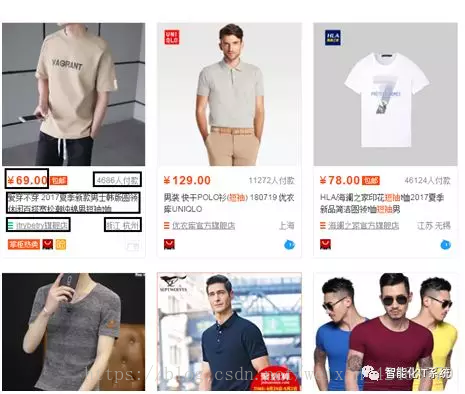
最后把爬取数据存储到MongoDB数据库中。
三. 相关技术
这里把除了selenium之外所需要的知识列一下,这里就不做详细解释了,如果不清楚的话可以百度了解下。
mongoDB的使用,以及在python中用mongodb进行数据存储。
lxml,爬虫三大方法之一,解析效率比较高,使用难度相比正则表达式要低(上一篇文章的解析方法是正则表达式)。
间歇休息的方法:driver.implicitly_wait
四. 源代码
代码如下所示,可复制直接执行:
from selenium import webdriver

from lxml import etree

import time

import pymongo

client = pymongo.MongoClient('localhost',  27017)

mydb = client['mydb']

taobao = mydb['taobao']

driver = webdriver.PhantomJS()

driver.maximize_window()

def get_info(url,page):

     page = page + 1

     driver.get(url)

     driver.implicitly_wait(10)

     selector = etree.HTML(driver.page_source)

     infos = selector.xpath('//div[@class="item J_MouserOnverReq"]')

     for info in infos:

        data = info.xpath('div/div/a')[0]

        goods =  data.xpath('string(.)').strip()

        price = info.xpath('div/div/div/strong/text()')[0]

        sell =  info.xpath('div/div/div[@class="deal-cnt"]/text()')[0]

        shop =  info.xpath('div[2]/div[3]/div[1]/a/span[2]/text()')[0]

        address =  info.xpath('div[2]/div[3]/div[2]/text()')[0]

        commodity = {

            'good':goods,

            'price':price,

            'sell':sell,

            'shop':shop,

            'address':address

        }

        taobao.insert_one(commodity)

     if page <= 50:

        NextPage(url,page)

     else:

        pass

def NextPage(url,page):

     driver.get(url)

     driver.implicitly_wait(10)

 driver.find_element_by_xpath('//a[@trace="srp_bottom_pagedown"]').click()

     time.sleep(4)

     driver.get(driver.current_url)

     driver.implicitly_wait(10)

     get_info(driver.current_url,page)

if __name__ == '__main__':

     page = 1

     url = 'https://www.taobao.com/'

     driver.get(url)

     driver.implicitly_wait(10)

     driver.find_element_by_id('q').clear()

     driver.find_element_by_id('q').send_keys('男士短袖')

     driver.find_element_by_class_name('btn-search').click()

     get_info(driver.current_url,page)
五. 代码解析
(1)1~4行
导入程序需要的库,selenium库用于模拟请求和交互。lxml解析数据。pymongo是mongoDB 的交互库。
(2)6~8行
打开mongoDB,进行存储准备。
(3)10~11行
最大化PhantomJS窗口。
(4)14~33行
利用lxml抓取网页数据,分别定位到所需要的信息,并把信息集成至json,存储至mongoDB。
(5)35~47行
分页处理。
(5)51~57行
利用selenium模拟输入“男士短袖”,并模拟点击操作,并获取到对应的页面信息,调取主方法解析。
———————————————————
公众号-智能化IT系统。每周都有技术文章推送,包括原创技术干货,以及技术工作的心得分享。扫描下方关注。
利用Selenium爬取淘宝商品信息的更多相关文章
- python3编写网络爬虫16-使用selenium 爬取淘宝商品信息
一.使用selenium 模拟浏览器操作爬取淘宝商品信息 之前我们已经成功尝试分析Ajax来抓取相关数据,但是并不是所有页面都可以通过分析Ajax来完成抓取.比如,淘宝,它的整个页面数据确实也是通过A ...
- Selenium+Chrome/phantomJS模拟浏览器爬取淘宝商品信息
#使用selenium+Carome/phantomJS模拟浏览器爬取淘宝商品信息 # 思路: # 第一步:利用selenium驱动浏览器,搜索商品信息,得到商品列表 # 第二步:分析商品页数,驱动浏 ...
- <day003>登录+爬取淘宝商品信息+字典用json存储
任务1:利用cookie可以免去登录的烦恼(验证码) ''' 只需要有登录后的cookie,就可以绕过验证码 登录后的cookie可以通过Selenium用第三方(微博)进行登录,不需要进行淘宝的滑动 ...
- 爬取淘宝商品信息,放到html页面展示
爬取淘宝商品信息 import pymysql import requests import re def getHTMLText(url): kv = {'cookie':'thw=cn; hng= ...
- 使用Selenium爬取淘宝商品
import pymongo from selenium import webdriver from selenium.common.exceptions import TimeoutExceptio ...
- selenium+pyquery爬取淘宝商品信息
import re from selenium import webdriver from selenium.common.exceptions import TimeoutException fro ...
- 使用Pyquery+selenium抓取淘宝商品信息
配置文件,配置好数据库名称,表名称,要搜索的产品类目,要爬取的页数 MONGO_URL = 'localhost' MONGO_DB = 'taobao' MONGO_TABLE = 'phone' ...
- Selenium爬取淘宝商品概要入mongodb
准备: 1.安装Selenium:终端输入 pip install selenium 2.安装下载Chromedriver:解压后放在…\Google\Chrome\Application\:如果是M ...
- selenium+phantomjs+pyquery 爬取淘宝商品信息
from selenium import webdriver from selenium.common.exceptions import TimeoutException from selenium ...
随机推荐
- 基于阿里云 DNS API 实现的 DDNS 工具
0.简要介绍 0.1 思路说明 AliDDNSNet 是基于 .NET Core 开发的动态 DNS 解析工具,借助于阿里云的 DNS API 来实现域名与动态 IP 的绑定功能.工具核心就是调用了阿 ...
- 关于git 指令
命令行操作(由于是Linux命令行下的普通用户,都是在$级别下操作): 一. 本机配置 添加用户 git config –global user.name “XX” git config –gloab ...
- Object.defineProperty方法
Object.defineProperty() (一次添加/修改一个属性) 用法:Object.defineProperty(obj, prop, descriptor) 方法会直接在一个对象上定义一 ...
- Python实现随机漫步
随机漫步生成是无规则的,是系统自行选择的结果.根据设定的规则自定生成,上下左右的方位,每次所经过的方向路径. 首先,创建一个RandomWalk()类和fill_walk()函数 random_wal ...
- mysql 架构篇系列 2 复制架构一主一从搭建(异步复制)
一. 环境准备 1.1 主库环境(172.168.18.201) 环境 说明 查看脚本 操作系统版本 CentOS Linux release 7.4.1708 (Core) cat /etc/red ...
- 转 Mac 使用ab性能测试工具
Mac 使用ab命令进行压测 1.在Mac中配置Apache ①启动Apache,打开终端 sudo apachectl -v 如下显示Apache的版本 sudo apachectl start 这 ...
- 如何在mpvue下收集小程序的formId
什么是formId formId是小程序可以向用户发送模板消息的通行证,简单而言,你只有获取到formId,把它交给后台,后台同学才能向用户发送通知消息,而这个通行证的有效期只有七天.这是微信为了防止 ...
- mysql 更新语句中加判断条件
UPDATE loan_overdue_list l setl.type_status=(CASE WHEN l.overdue_days>(select c.overdue_one from ...
- Win32知识之窗口绘制.窗口第一讲
Win32知识之窗口本质 一丶摘要 在学习Win32的时候. 很多操作都是窗口进行操作的.那么今天就说一下窗口的本质是什么. 窗口的本质是不断绘制.是windows通过消息机制进行绘制的. 我们知道. ...
- 翻译:insert select(已提交到MariaDB官方手册)
本文为mariadb官方手册:insert select的译文. 原文:https://mariadb.com/kb/en/insert-select/ 我提交到MariaDB官方手册的译文:http ...