
北大开源全新中文分词工具包:准确率远超THULAC、结巴分词
最近,北大开源了一个中文分词工具包,它在多个分词数据集上都有非常高的分词准确率。其中广泛使用的结巴分词误差率高达 18.55% 和 20.42,而北大的 pkuseg 只有 3.25% 与 4.32%。
pkuseg 是由北京大学语言计算与机器学习研究组研制推出的一套全新的中文分词工具包。它简单易用,支持多领域分词,在不同领域的数据上都大幅提高了分词的准确率。
项目地址:https://github.com/lancopku/PKUSeg-python
pkuseg 具有如下几个特点:
高分词准确率:相比于其他的分词工具包,该工具包在不同领域的数据上都大幅提高了分词的准确度。根据北大研究组的测试结果,pkuseg 分别在示例数据集(MSRA 和 CTB8)上降低了 79.33% 和 63.67% 的分词错误率。
多领域分词:研究组训练了多种不同领域的分词模型。根据待分词的领域特点,用户可以自由地选择不同的模型。
支持用户自训练模型:支持用户使用全新的标注数据进行训练。
此外,作者们还选择 THULAC、结巴分词等国内代表分词工具包与 pkuseg 做性能比较。他们选择 Linux 作为测试环境,在新闻数据(MSRA)和混合型文本(CTB8)数据上对不同工具包进行了准确率测试。此外,测试使用的是第二届国际汉语分词评测比赛提供的分词评价脚本。评测结果如下:
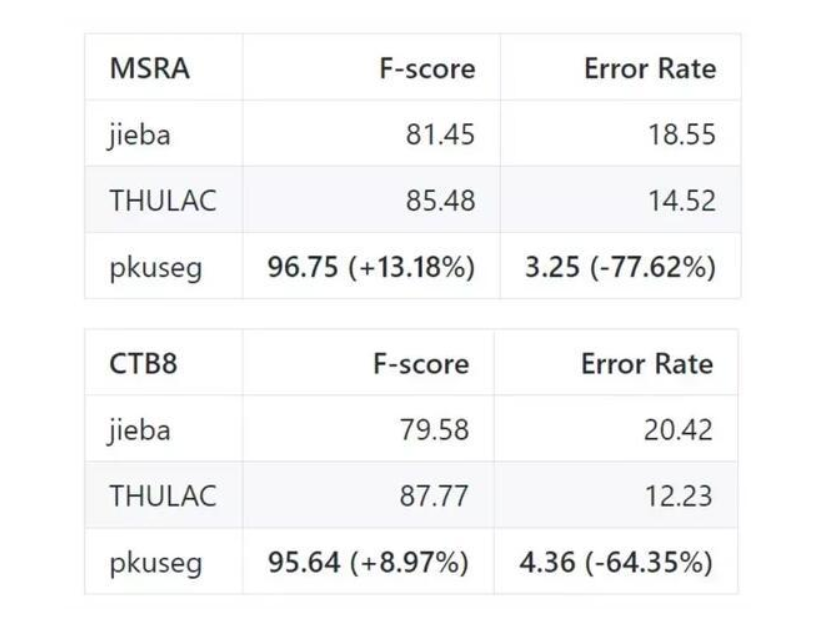
我们可以看到,最广泛使用的结巴分词准确率最低,清华构建的 THULAC 分词准确率也没有它高。当然,pkuseg 是在这些数据集上训练的,因此它在这些任务上的准确率也会更高一些。
预训练模型
分词模式下,用户需要加载预训练好的模型。研究组提供了三种在不同类型数据上训练得到的模型,根据具体需要,用户可以选择不同的预训练模型。以下是对预训练模型的说明:
MSRA:在 MSRA(新闻语料)上训练的模型。新版本代码采用的是此模型。
CTB8:在 CTB8(新闻文本及网络文本的混合型语料)上训练的模型。
WEIBO:在微博(网络文本语料)上训练的模型。
其中,MSRA 数据由第二届国际汉语分词评测比赛提供,CTB8 数据由 LDC 提供,WEIBO 数据由 NLPCC 分词比赛提供。在 GitHub 项目中,这三个预训练模型都提供了下载地址。
安装与使用
pkuseg 的安装非常简单,我们可以使用 pip 安装,也可以直接从 GitHub 下载:
- pip install pkuseg
使用 pkuseg 实现分词也很简单,基本上和其它分词库的用法都差不多:
- '''代码示例1: 使用默认模型及默认词典分词'''
- import pkuseg
- #以默认配置加载模型
- seg = pkuseg.pkuseg()
- #进行分词
- text = seg.cut('我爱北京天安门')
- print(text)
- '''代码示例2: 设置用户自定义词典'''
- import pkuseg
- #希望分词时用户词典中的词固定不分开
- lexicon = ['北京大学', '北京天安门']
- #加载模型,给定用户词典
- seg = pkuseg.pkuseg(user_dict=lexicon)
- text = seg.cut('我爱北京天安门')
- print(text)
- '''代码示例3'''
- import pkuseg
- #假设用户已经下载好了ctb8的模型并放在了'./ctb8'目录下,通过设置model_name加载该模型
- seg = pkuseg.pkuseg(model_name='./ctb8')
- text = seg.cut('我爱北京天安门')
- print(text)
对于大型文本数据集,如果需要快速分词的话,我们也可以采用多线程的方式:
- '''代码示例4'''
- import pkuseg
- #对input.txt的文件分词输出到output.txt中,使用默认模型和词典,开20个进程
- pkuseg.test('input.txt', 'output.txt', nthread=20)
最后,pkuseg 还能重新训练一个分词模型:
- '''代码示例5'''
- import pkuseg
- #训练文件为'msr_training.utf8',测试文件为'msr_test_gold.utf8',模型存到'./models'目录下,开20个进程训练模型
- pkuseg.train('msr_training.utf8', 'msr_test_gold.utf8', './models', nthread=20)
这些都是 GitHub 上的示例,详细的内容请参考 GitHub 项目,例如参数说明和参考论文等。
北大开源全新中文分词工具包:准确率远超THULAC、结巴分词的更多相关文章
- python 结巴分词学习
结巴分词(自然语言处理之中文分词器) jieba分词算法使用了基于前缀词典实现高效的词图扫描,生成句子中汉字所有可能生成词情况所构成的有向无环图(DAG), 再采用了动态规划查找最大概率路径,找出基于 ...
- pkuseg:一个多领域中文分词工具包
pkuseg简单易用,支持细分领域分词,有效提升了分词准确度. 目录 主要亮点 编译和安装 各类分词工具包的性能对比 使用方式 相关论文 作者 常见问题及解答 主要亮点 pkuseg具有如下几个特点: ...
- 轻量级的中文分词工具包 - IK Analyzer
IK Analyzer是一个开源的,基于java语言开发的轻量级的中文分词工具包.从2006年12月推出1.0版开始, IKAnalyzer已经推出了4个大版本.最初,它是以开源项目Luence为应用 ...
- THULAC:一个高效的中文词法分析工具包(z'z)
网址:http://thulac.thunlp.org/ THULAC(THU Lexical Analyzer for Chinese)由清华大学自然语言处理与社会人文计算实验室研制推出的一套中文词 ...
- python中文分词:结巴分词
中文分词是中文文本处理的一个基础性工作,结巴分词利用进行中文分词.其基本实现原理有三点: 基于Trie树结构实现高效的词图扫描,生成句子中汉字所有可能成词情况所构成的有向无环图(DAG) 采用了动态规 ...
- python 中文分词:结巴分词
中文分词是中文文本处理的一个基础性工作,结巴分词利用进行中文分词.其基本实现原理有三点: 基于Trie树结构实现高效的词图扫描,生成句子中汉字所有可能成词情况所构成的有向无环图(DAG) 采用了动态规 ...
- 中文分词之结巴分词~~~附使用场景+demo(net)
常用技能(更新ing):http://www.cnblogs.com/dunitian/p/4822808.html#skill 技能总纲(更新ing):http://www.cnblogs.com/ ...
- EasyPR--一个开源的中文车牌识别系统
我正在做一个开源的中文车牌识别系统,Git地址为:https://github.com/liuruoze/EasyPR. 我给它取的名字为EasyPR,也就是Easy to do Plate Reco ...
- 中文分词接口api,采用结巴分词PHP版中文分词接口
中文分词,分词就是将连续的字序列按照一定的规范重新组合成词序列的过程.我们知道,在英文的行文中,单词之间是以空格作为自然分界符的,而中文只是字.句和段能通过明显的分界符来简单划界,唯独词没有一个形式上 ...
随机推荐
- 【java】java基本用法记录
java用法总结 计时 long startTime = System.nanoTime(); solution.process(inputFile); long endTime = System.n ...
- 给没有连接因特网的centos使用yum安装其他软件。
在centos上,使用yum安装软件很方便,比如安装gcc,java等, 但是在没有网络的情况下呢? 我之前就碰到过这么一个问题,在一个没有外网的环境内,我需要安装GCC等工具, 然后有人推荐我先去其 ...
- [转] JS中的call()方法和apply()方法用法总结
//例1 <script> window.color = 'red'; document.color = 'yellow'; var s1 = {color: 'blue' }; func ...
- C# DataConstruct 数据结构关于 Array,ArrayList,List,HashTable,Dictionnary的学习记录
Array: 数组,开辟连续存储的内存存储数据.Array获取数据的时间复杂度是O(1),但是要删除数据却是开销很大的,因为这需要重排数组中的所有数据 优点: 1.查询速度快,可以利用索引快速查询到对 ...
- ubuntu更换pip install,apt-get,conda install 成国内源
解决ubuntu的pip和apt-get太慢的问题 ubuntu国外龟速的源实在难受,还是自己动手更改一下各种pip 源和apt-get 的源吧,换了之后速度令人舒适! 更换pip源成清华源 临时使用 ...
- pycharm中range的应用
v = range(100) for item in v: print (item) #输出结果是0 1 2 3 ......99 这是在python3中实现的,python2中不一样 下面是一个从大 ...
- 当使用xmapp时session序列化生成的文件的路径
由于没有安装tomcat而是安的xmapp所以序列化和反序列化时并没有在tomcat的里边生成session文件而是在java的工作路径下生成在以下路径下 D:\pro\java\workspace\ ...
- MySQL server has gone away错误的解决办法
在我们使用mysql导入大文件sql时可能会报MySQL server has gone away错误,该问题是max_allowed_packet配置的默认值设置太小,只需要相应调大该项的值之后再次 ...
- Kubernetes系列之Helm介绍篇
本次系列使用的所需部署包版本都使用的目前最新的或最新稳定版,安装包地址请到公众号内回复[K8s实战]获取 介绍 Helm 是 Deis 开发的一个用于 Kubernetes 应用的包管理工具,主要用来 ...
- AddIn 中当前完整文件名的获取
Me.Application.ActiveWorkbook.Name 需要注意的是:只有当前文件已经存档的情况下,才能获得后缀名.